服装AI质检上线后,产线跑得正顺,突然要换款——新款式、新工艺、新瑕疵标准,模型得跟着变。可产线不能停,质检节拍不能掉,漏检率更不能飙上去。这就是模型热更新的价值:在不中断产线的前提下,把新模型平滑地替换旧模型。
本文结合服装AI质检的真实场景,讲清楚热更新的核心思路、落地架构和踩坑经验。
1. 为什么换款会中断产线
换款之所以让产线头疼,是因为它同时触发了三个变化:
- 数据分布变了:新款的版型、面料、缝线工艺和旧款差异大,旧模型的特征分布不再适用。
- 标注标准变了:不同款式的瑕疵定义不同,比如针织款的"跳针"和梭织款的"断经"是两回事。
- 推理逻辑变了:检测阈值、ROI区域、后处理规则都可能要跟着调。
如果按老办法"停线→重训→重新部署→验证→复产",一次换款往往要停机数小时甚至一整天。对服装厂来说,停机就是实打实的产能损失。
2. 热更新的核心思路
热更新的本质是:让新旧模型在产线上无缝交接。关键不在于"换模型"这个动作本身,而在于换之前、换之中、换之后的三段式管理。
2.1 换之前:影子模式预热
新模型训练完,不要直接上产线。先让它跑"影子模式"——和旧模型并行推理,但结果只记录、不参与质检判定。
影子模式要收集两类数据:
- 一致性对比:新旧模型在同一批图上的判定差异有多大。
- 置信度分布:新模型在真实产线数据上的置信度是否健康。
只有当新模型在影子模式下表现稳定,才允许进入下一步。
2.2 换之中:灰度切换
不要一次性全量切换。按产线工位或机台分批灰度:
- 先切 10% 的工位跑新模型,观察漏检率和误报率。
- 稳定后再逐步扩大到 30%、50%、100%。
灰度切换期间,新旧模型同时在线,任何一台设备都可以随时回滚。
2.3 换之后:自动回滚兜底
热更新必须带"后悔药"。一旦新模型在灰度阶段出现漏检率飙升或置信度异常,系统要能自动回滚到旧模型,而不是等人工发现。
3. 落地架构:模型服务与产线解耦
要让热更新不中断产线,架构上必须做到模型服务与产线业务解耦。推荐用"模型网关 + 版本管理"的模式:
核心组件有三个:
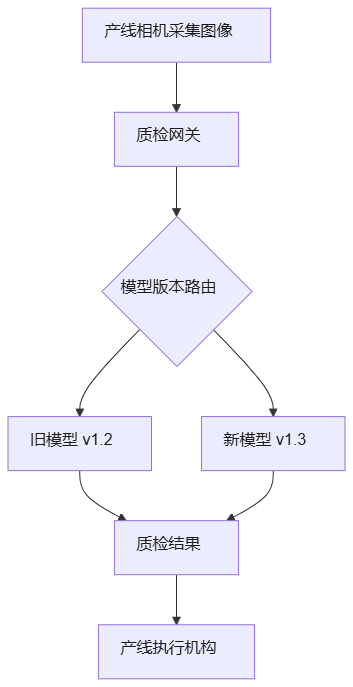
- 模型网关:统一接收推理请求,按版本路由规则分发到具体模型实例。
- 版本仓库:管理模型文件、配置、标注标准,每次更新都生成新版本号。
- 监控告警:实时跟踪每个版本的漏检率、误报率、推理耗时。
4. 关键实现:版本路由与热加载
4.1 版本路由
网关层维护一张版本路由表,决定"当前这个工位、这个款式,该用哪个模型":
class ModelRouter:
def __init__(self):
self.routes = {} # (line_id, style_id) -> model_version
def route(self, line_id, style_id):
key = (line_id, style_id)
return self.routes.get(key, "default")
def update_route(self, line_id, style_id, version):
key = (line_id, style_id)
self.routes[key] = version
换款时,只需要更新路由表,把新款式指向新模型版本,产线请求自然就切过去了。
4.2 模型热加载
模型文件放在共享存储,网关进程通过版本号动态加载,不重启服务:
import joblib
class ModelManager:
def __init__(self):
self.models = {}
def load_version(self, version, path):
self.models[version] = joblib.load(path)
return self.models[version]
def get_model(self, version):
if version not in self.models:
raise KeyError(f"model {version} not loaded")
return self.models[version]
加载完成后,把新版本注册到路由表,旧版本保留在内存中一段时间,用于灰度对比和快速回滚。
5. 换款热更新的标准流程
结合服装AI质检的实际操作,一次完整的换款热更新可以拆成六步:
- 新款式数据采集:新款上线前,先拍一批真实产线图。
- 模型微调训练:基于新款数据微调,产出新版本。
- 影子模式验证:新旧模型并行跑,对比判定一致性。
- 灰度切换:按工位分批切到新模型。
- 监控观察:盯漏检率、误报率、推理耗时。
- 全量生效:稳定后全量切换,旧模型归档。
6. 踩坑与避坑建议
6.1 影子模式数据要够真实
影子模式用的图必须来自真实产线,而不是训练集。训练集里没有的"脏图"、“反光图”、“遮挡图”,恰恰是热更新最容易翻车的地方。
6.2 回滚要快,但不能误伤
自动回滚的触发条件要设得合理。漏检率瞬时抖动就回滚,会导致频繁震荡;建议用"连续 N 个批次超阈值"再触发回滚。
6.3 新旧模型判定标准要可对比
换款时如果连瑕疵定义都改了,新旧模型的判定结果就没有可比性。建议在影子模式阶段,用同一批图同时跑新旧模型,并人工复核差异样本。
6.4 推理资源要留余量
灰度期间新旧模型同时在线,GPU/CPU 资源占用会翻倍。上线前要评估好资源余量,避免灰度切换时把产线推理拖慢。
7. 总结
模型热更新不是"换模型"这一个动作,而是一套从影子模式、灰度切换、自动回滚到监控告警的完整机制。对服装AI质检来说,换款是常态,热更新能力直接决定了产线的柔性和效率。
核心就三句话:
- 换之前:影子模式充分验证。
- 换之中:灰度切换、随时可回滚。
- 换之后:监控兜底、快速响应。
把这套机制跑通,换款就不再是产线的"停机时刻",而是平滑的版本升级。