一件衣服要变成一条能投放的短片,中间隔着两步:先让它穿在一个具体的人身上、站在一个具体的地方,再把这个人拍成几个镜头。前一步决定片子长什么样,后一步决定片子怎么动。
AI 把这两步都压到了参考图加提示词上,两张图进去、一段话出来。实际做的时候,卡住的往往不是哪一步不会,而是两步之间的衔接——定妆图做歪了,视频只能照着歪的拍;定妆图做对了,镜头拆分才有东西可拆。
AI 穿搭视频怎么做,真正决定成片的两件事,在生成视频之前就已经定了:衣服换没换对,人站没站对。这两件事都可以在一张图上先验完,再往下走。
一、先数清两张图里各有几件东西
白底模特图上看着只有一套衣服,把它拆开数,是一份完整的清单:浅黄的坑条针织开衫、深色牛仔阔腿裤、白色褶皱手袋、黑色平底鞋,脖子上一根细项链。穿搭拼图更容易数,它本来就是一件一件摆开拍的,棕色吊带背心、米白打底长袖、格纹不规则半身裙、波点丝巾、豹纹手袋、薄荷绿运动鞋,六件各占一块。
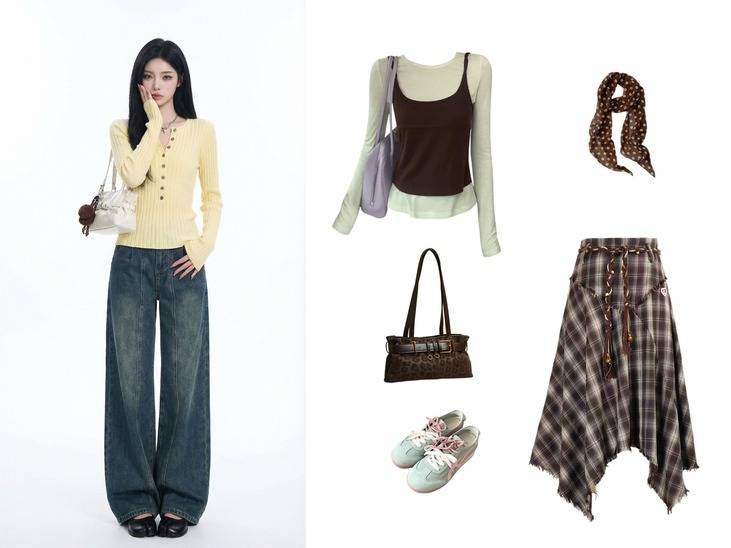
图:左为白底棚拍的模特原图,右为拼在一张图上的整套穿搭单品。
两份清单摆在一起,差集就出来了。要把人换成拼图上这一整套,就得同时处理背心、打底长袖、裙子、丝巾、手袋、运动鞋六项,还得决定原来那件开衫和那条牛仔裤是撤掉还是留着。这一步在纸上做完,提示词才好写,因为这时你已经知道自己要动的是六件东西,而不是笼统的"衣服"。
清单不必写到纤维和针脚那么细,能把两边的单品一一对上号就够。吊带和打底算两件还是一套,不影响后面的写法;但把"包"和"鞋"漏掉,结果就会差出很远——这两样恰恰是最先被动过的。
穿搭拼图之所以好用,是因为几件单品被摆在同一张图里,模型一次能看全它们之间的关系:打底在吊带里面、丝巾不属于任何一件衣服、鞋和包是各自独立的两件。如果把单品拆成几张图递进去,哪件配哪件就得靠提示词另行交代,多一层出错的机会。
二、换装那一句要写清换哪几件、留哪几样
提示词里关于换装的那一句,通常和换场景连在一起写,一句话里塞了两件事:
把图2的服装换到图1的模特身上,动作不变。同时将人物换到路边,能看到远处蔚蓝的大海,蓝天,行驶车辆、白色护栏,光影自然融合。这句话读起来没有歧义,落到画面上,"服装"覆盖的范围却是由模型自己裁定的。这一次的结果,是把六件单品一起换了上去:白色褶皱手袋变成豹纹手袋,黑色漆皮平底鞋变成薄荷绿运动鞋,丝巾系在颈侧打了个结,连原来脖子上那根细项链,在这个画面里也找不到位置了。
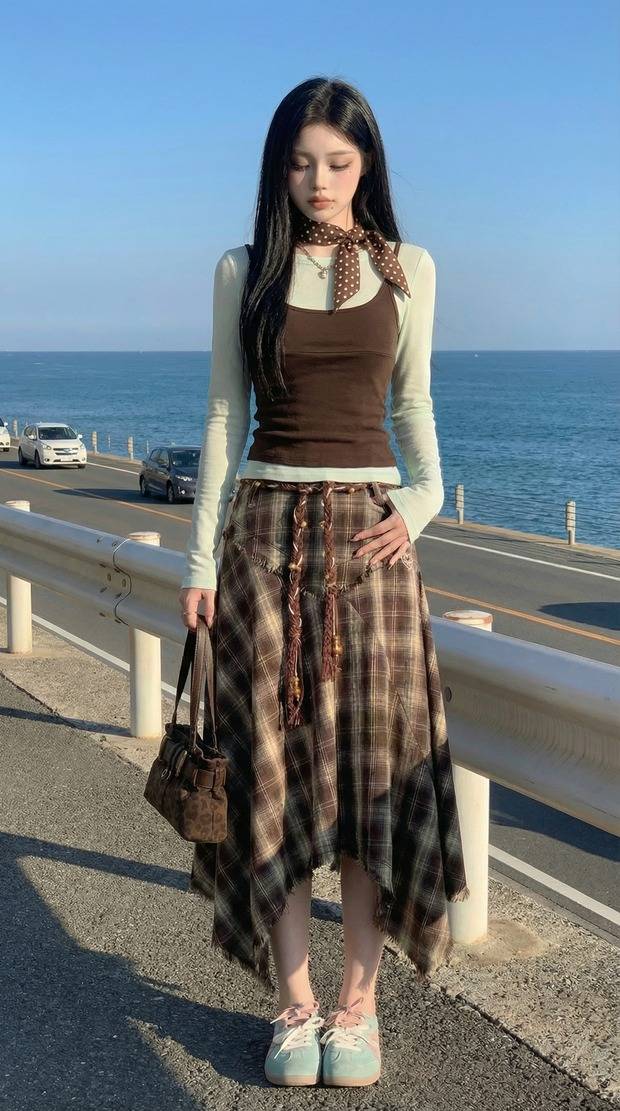
图:一次生成之后,服装、配件与背景同时被替换,人物站到了公路边的路面上。
这一版的"服装"把配件也算了进去,包、鞋、丝巾都在替换范围内。它们恰恰是最容易出问题的部分,因为手袋和鞋的款式识别度往往比衣服还高,换错一只包,整套搭配的味道就散了;反过来,如果这批图要保留原来的包,模型很可能不声不响地把它换掉。
要把范围收住,得把两个方向都写出来。要换的逐项点名,要留的也逐项点名,脸、发型、身形比例、站姿这四样是换装时最容易被顺手一起改掉的。这一单如果只换上衣,提示词里补一句"裤、鞋、手袋保持图1不变",比把要换的那件上衣描述三遍更管用。
丝巾在拼图上只是平铺着的一块方巾,成图里却被系到了颈侧、打了个结——模型不只是把物件搬过去,它还要决定这件东西穿在身上的样子。围巾、腰带、帽子都有同样的问题,拼图上摆得再清楚,戴法仍然是一个需要写明的变量。
也不必每次都把六项写满,只改一件的时候,把要留的那几件点出来就行,写多了反而让句子重心偏移,模型分不清哪一句是重点。
这一版还有一处没守住,就是那句"动作不变"。输入里模特左手抬到脸侧、右手提着包,成图里她低着头,左手落到了腰前。
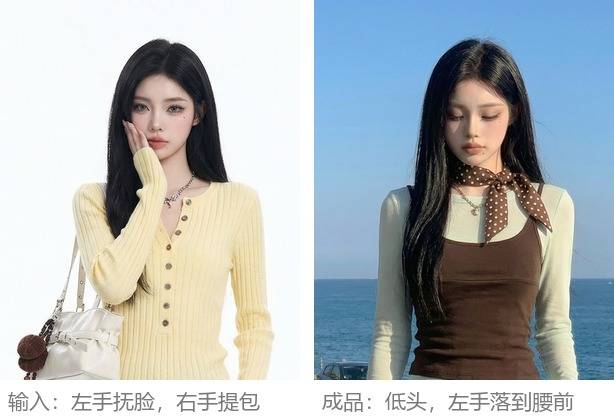
图:左为白底原图里的抬手姿势,右为成图里的低头站位,抬到脸侧的那只手在成图里落到了腰前。
要保住姿势,就得写到具体:哪只手、抬到多高、视线朝哪个方向、重心压在一条腿还是两条腿上。写"动作不变"等于把这个决定权交回给模型,而换装和换场景本来就已经占满了这段指令,姿势是最容易被挪开的那一项。
三、场景按远中近写可见物,不写形容词
同一段话的后半截交代了人物换到哪里去:路边,远处是大海和天,中段有行驶的车辆,最近的是白色护栏。这一截里没有一个形容词,全是能看见的东西:大海、蓝天、车辆、护栏,四样分布在不同的距离上——海和天在最远处,车辆在中段,护栏离人最近。顺序也不是随手排的,它从远往近写,跟画面从背景往前景铺开的顺序一致,读的人顺着这句话,眼睛是从天边一路收到脚边的。
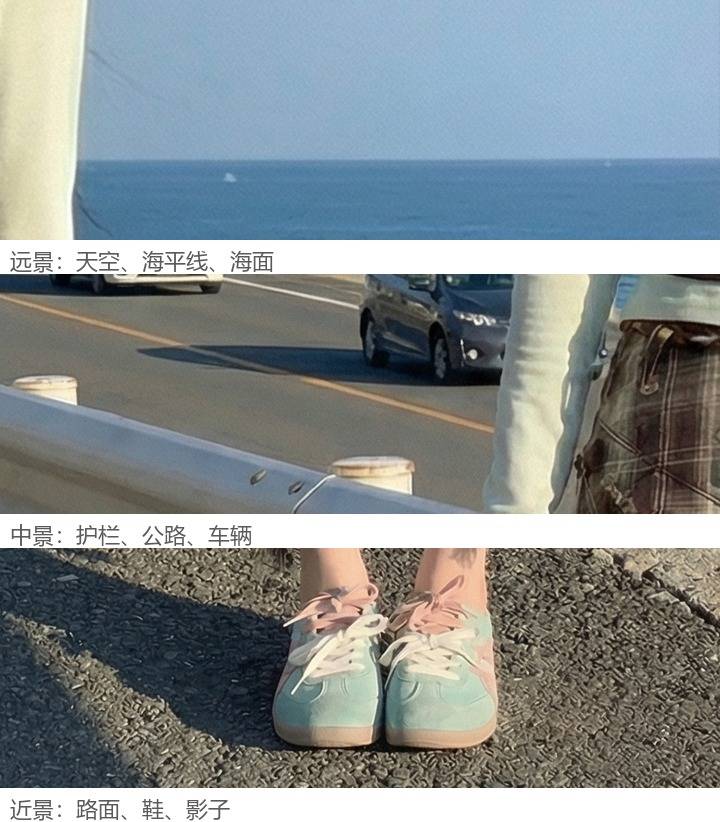
图:从成图里分别取出的三段画面,对应提示词写到的海与天、护栏与车辆、路面与鞋。
换一种写法,"海边公路、风景优美、氛围浪漫",得到的大概是一片空旷的海滩,人物站在沙子上,护栏和车辆都不会出现——这三样没有任何一样被写出来,模型没有理由自己加。场景描述的可执行程度,取决于里面有几样能被指认的实物。
场景里还得交代人物和这些东西的位置关系。站在路面上还是站在护栏外侧,护栏在身前还是身后,出来的画面完全不同:护栏在身后,人和海之间没有遮挡,整身轮廓是完整的;护栏在身前,人被切掉一截,视线也被引向公路那一边。这一版成图里护栏在人物身后横穿画面中部,人站在靠近镜头这一侧的柏油路面上,肩到裙摆都完整留在画面里。同样几个字,效果差得很远。
场景不必写全。写住人站的位置,再加两三样能定住空间的东西就够了,写太多会把画面塞满,模特反而没地方站——六件单品加一片海加一条公路,画面里能容纳的东西本来就有限。
四、换场景就得把光一起换掉
白底棚拍是四面均匀的散射光,正面打亮,四周补光,人物身上几乎没有影子,脚下也留不下一道。户外傍晚不一样,太阳压得很低,从侧后方过来,人会在地面上拖出一道很长的影子,护栏也在自己脚下投出一道。
只换衣服不换光,人就变成了剪下来贴在背景上的纸片。这也是为什么那段提示词的末尾要专门留五个字:光影自然融合。
这五个字单看很虚,落到能写的层面是三样东西:光从哪一侧来、色温偏暖还是偏冷、影子落在哪个方向。成图里人物站在路面上,影子朝画面左侧拉出去,护栏立柱的投影也是同一个方向,两道影子对得上,人才算真的站在那条路上。如果人物有影子、护栏没有,或者两个方向拧着,一眼就能看出是合成的。
影子的长度也是信息。正午的影子短,缩在脚下;傍晚的影子长,能拉到半个身位以外。这一版成图的影子从脚下一直伸到画面左下角,把这层意思写进提示词,比只写"傍晚"两个字更能定住时间。
落到句子里,这三项可以合成一句:傍晚的低角度侧光从人物右后方打过来,暖金色,路面上的影子朝左前方拉长。这样一句比"光影自然融合"多给了三个可以照着写的项,模型不必自己猜是正午还是黄昏。这一句是按案例整理出来的写法,尚未单独用于生成验证。
如果只是把白墙换成灰墙、把影棚背景换成室内一角,光其实不用动,因为两种环境都是均匀的散射光。一旦跨到户外,白天还是傍晚、太阳在哪一侧,这几项必须跟着重写,衣服描述得再细也补不回来。
五、这张定妆图拆成三个取景范围
图做到这一步,画面里已经有一个穿对了衣服、站在对的地方的人。接下来要把它拆成一条十秒的片子,拆的依据不是镜头数量,而是取景范围——同一套衣服,从腰以上、腰以下、全身三个范围去看,各自能证明的事情不一样。
先数部件。这套搭配摊开来有八件:浅豆绿长袖内搭、深棕色方领吊带、棕底白波点围巾、细链吊坠项链、棕黑格纹不规则下摆半裙、两条带金珠的编织腰绳、豹纹小方包、浅蓝拼色低帮系带鞋。八件东西没法在一个镜头里说完,必须分给不同的取景范围:领口、肩带、围巾归上半身,裙摆的不规则下摆、腰绳、鞋归下半身,整套比例和整体气质交给全身镜头。
再给每个范围配一个带动布料的动作。上半身可以抬手整理围巾、扶一下领口;下半身可以迈半步、让裙摆自己晃起来;全身镜头留给站定与转身。动作不用大,够让衣料动一次就行——静态的裙子看不出垂感,动一下才看得出。
最后按"局部—整体—局部"的顺序排。这是用上面那张定妆图和上面那段提示词生成的视频,分镜与成片效果可以对照着看。
这条成片 10.05 秒,竖版画幅,按场景变化检测出 7 个切点,切成 7 段:
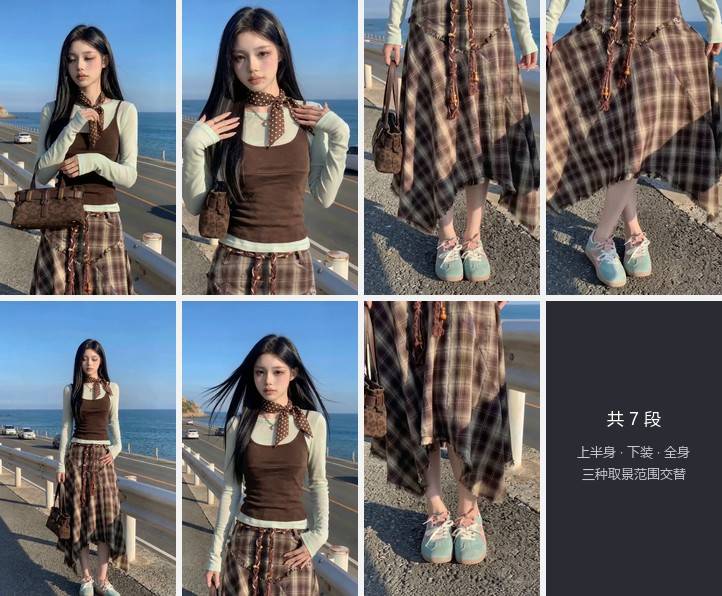
图:画面包含领口附近的手部动作、裙摆与鞋的局部、全身站姿,以及头发向一侧扬起的半身画面。
腰以上的 3 段合起来 5.58 秒,腰以下的 3 段 3.13 秒,全身只有 1 段、1.33 秒。平均每段 1.44 秒,最短 0.79 秒,最长 2.25 秒。一半以上的时间给了上半身,全身只出现一次。
这个分配里最要紧的一点是:全身镜头虽然只有一段,位置却在中间偏后,前面先用两个上半身镜头把脸和领口交代清楚,再退到全身看整套比例,接着又切回下半身的裙摆与鞋。观众记住的是搭配的整体印象,看见的却是被拆开的零件。
案例记录里的完整提示词只有一句要求,没有具体写法:
完整案例提示词
根据这一套衣服出一个带货穿搭视频服装的细节要展示,同时符合爆款带货视频的节奏,注意语气,要有感情,和情绪,全程不要出现字幕,要有时尚感和个性,非常吸引人,根据视频配服装搭配的热门音乐,不要出现任何字幕,任何旁白成片原片
视频:这套海边穿搭的动态展示,保留原片画面与声音。
片中头发与裙摆的摆动延续了海边的环境感,人物幅度很小的动作让围巾、领口和腰部装饰成为视觉重点。全片没有字幕,原提示词里两次提出的"不要出现任何字幕"兑现了;音轨是一层连续的配乐,语音转写返回空文本,所以只能说识别不到台词,不能据此判断有没有人声。
拆镜头的顺序不必每次都按这个模板。造型的重点如果落在裤型或鞋上,腰以下的比例就该加大;如果重点是整体气质,全身镜头可以多给一段。这里给的是这条片子实际的时间分配,不是一套通用比例。
六、从成片核对,哪些兑现了、哪些被改掉
把成片和那张定妆图放在一起逐件对,能对上的和不能对上的都很清楚。
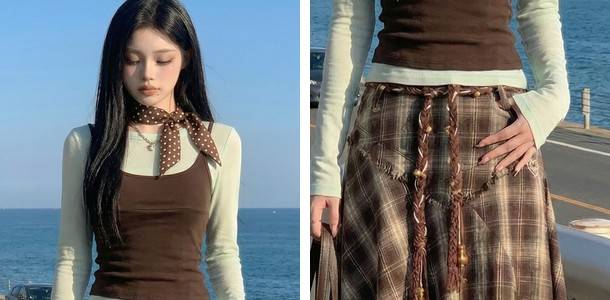
图:左侧为棕色吊带、浅色内搭与波点围巾的叠层,右侧为格纹裙腰及垂下的腰绳。
内搭的颜色和圆领保住了,围巾的花色与系法保住了,半裙的格纹和不规则下摆保住了,两条带金珠的腰绳也还在,只是比定妆图里更粗更短。场景从公路、护栏到两侧车辆,一路延续下来。
被改掉的有三处。吊带原本是方领、宽肩带,成片里变圆领、细肩带;鞋原本是浅蓝米白的低帮系带款,成片里变成厚底、鞋身明显更大;人物比例在全身镜头里被压矮,腰线变低,腿短了、脚大了。
这三处差异指向同一件事:颜色和花纹是最稳的,形状和比例不是。写提示词时把"方领、宽肩带、低帮、薄底、腰线在肚脐以上"这类形状描述写进去,比写"一件棕色吊带背心和一双浅蓝运动鞋"有用——后者只交代了品类和颜色,形状全靠模型自己填。
这里只有一条成片,不能说这些改动是必然的。能说的是:在这一条里,被改掉的全是形状,被保住的全是颜色、花纹和场景。想要哪一样稳,就得在提示词里给它一个看得见的形状,而不是一个品类名。
总结:图对了,片才有得拆
先数清两张图里各有几件东西,把换的和留的逐项点名;场景按远中近写可以指认的实物,光跟着场景一起换;定妆图落定之后,再按腰以上、腰以下、全身三个范围拆镜头,让每个范围配一个带动布料的动作。这一路做下来,最容易被改掉的从来不是衣服的颜色,而是衣服的形状和人的姿势。