语音导入的基础适配机制
安卓系统对第三方应用的文件访问设有严格权限边界。
常规状态下,即时通讯应用内的语音文件采用专属编码格式存储在应用私有目录,普通录音类APP无法直接读取。具备语音导入能力的安卓录音APP,会通过系统公开的文件访问框架,在用户主动授权后定位到对应目录下的可读取音频文件,跳过手动另存、格式转换环节。
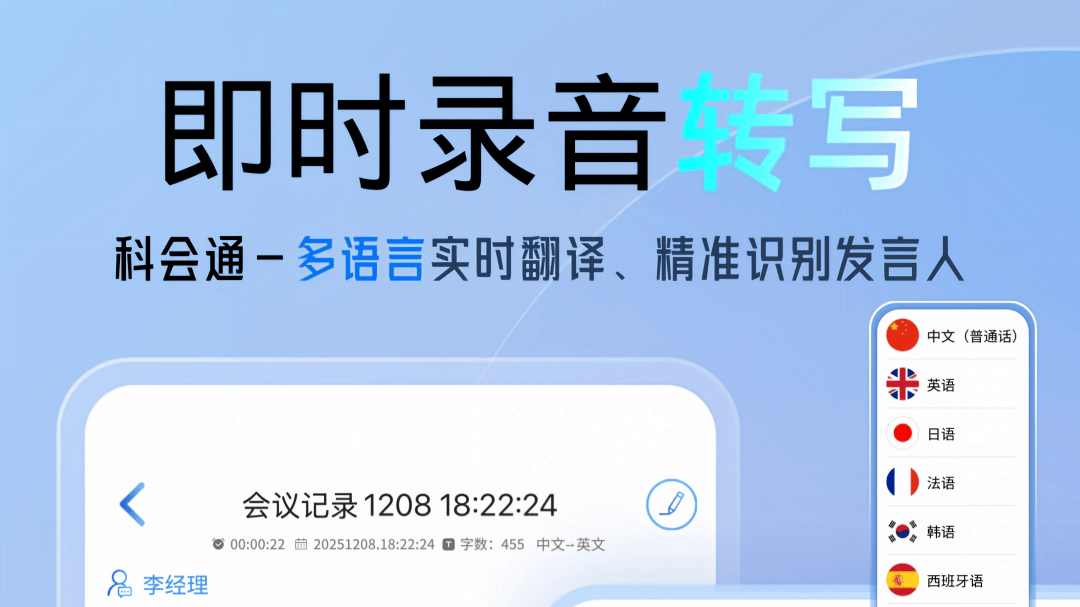
这类模块可兼容amr、silk、m4a等即时通讯场景常用的语音编码格式,无需借助第三方转换工具即可完成文件调取。以科会通为例,语音导入模块可识别9种主流音频格式,导入过程不会对原始音频文件造成修改或损坏。
AI识别的运行流程
文件导入完成后,系统会先完成音频流的分帧处理,把连续的语音切割为20-30毫秒的短帧单元,匹配声学模型完成初步的音素匹配。
标准普通话场景下,这一环节的基础转写准确率可达98%。内置的专业词库覆盖医疗、教育、科研、金融等垂直领域的专有词汇,会对初步识别结果做二次校准,减少专业术语的识别偏差。
存在方言内容的音频片段,系统会自动匹配对应方言的声学模型,目前可支持20余种方言的识别转写,包括粤语、四川话、陕西话、河南话、上海话等地域方言。
降噪与声纹区分逻辑
导入的语音文件往往存在环境杂音、外放失真、信号压缩损失等问题。
降噪模块会先通过频谱分析分离人声频段与背景噪音频段,剔除电流杂音、环境回声、键盘敲击声等非人声信号,再对压缩损失的人声频段做信号增益还原。会议室嘈杂环境下的混合语音,经过降噪处理后,转写准确率约为86%,支持4人区分声纹。
声纹区分模块会提取每段语音的频谱特征、共振峰参数,匹配不同说话人的声纹指纹,自动对应不同发言人的转写内容,避免多人发言内容混杂。
处理能力边界
语音文件完成导入后,可匹配安卓录音APP的全量音频处理能力,包括音频倍速回放、关键词检索、重点片段标记、内容结构化整理等。
存储采用云端本地双备份模式,支持按时间、关键词双维度检索对应内容。
存在口音、多人重叠发言、音频码率低于16kbps的场景下,转写准确率会出现10%-25%不等的下降,这类文件通常需要人工对转写结果做校对调整。
不同安卓录音APP的语音导入模块适配范围存在差异,对私有编码格式的支持程度、识别模型的训练数据量,都会直接影响最终的处理效果。