从60亿人到5000人,各层对AI的判断截然不同,原因在于每一层亲眼见到的AI本来就不一样。
10月11日,OpenAI联合创始人、前特斯拉AI总监安德烈·卡帕西(Andrej Karpathy)在X上更新了他今年4月的一条帖子。4月时他说,关于AI能力有两群人在各说各话。这一次他改了说法:差距在扩大,局面已经不是两方对话,更像一个越收越窄的漏斗。
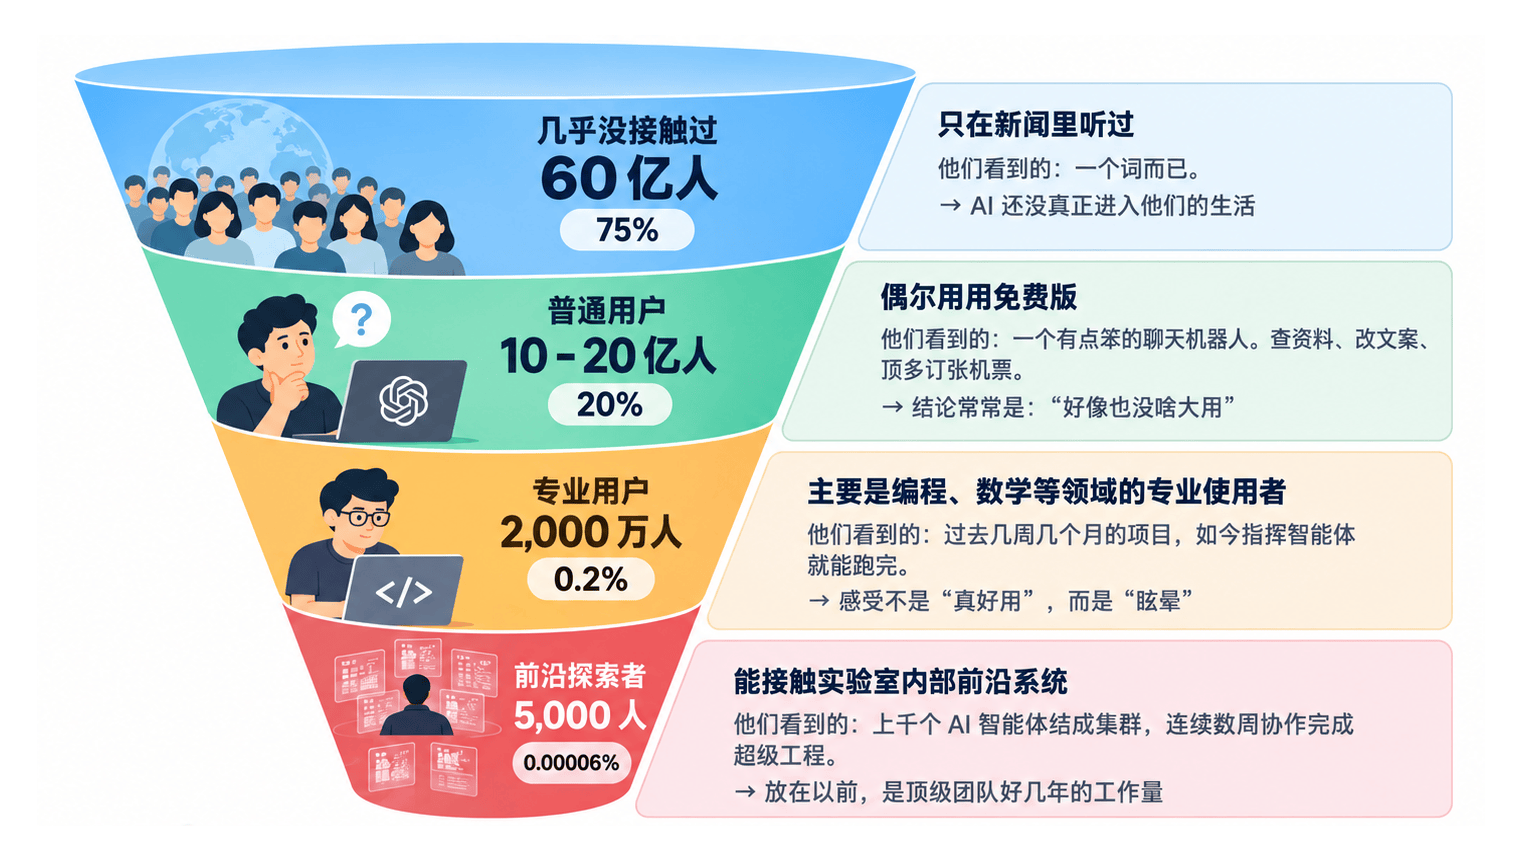
他给出了一组自称“粗略估算”的数字:
约60亿人,占全球人口约75%,几乎没接触过大语言模型。
约10亿到20亿人,偶尔用免费版聊天机器人查资料、写东西,用完觉得“也就那样”。
约2000万人,在编程、数学等领域专业使用前沿模型,看到的AI更接近外界宣传的样子。
约5000人,能用到实验室内部尚未公开的前沿系统。在那里,成千上万个智能体连续数周协同推进大型软件项目、网络攻防、科学发现和前沿数学。
这组数字最容易被记住的是顶端的“5000人”,比登顶珠峰的人还少。不过帖子更值得细读的部分,是卡帕西对漏斗成因的解释。他的意思是,各层之间不只是“知道得多和知道得少”的区别,大家实际用到的AI本身就不同。
三个成因:差距从哪里来
按卡帕西的说法,漏斗主要由三件事塑造。
第一,问题的尺度和时间跨度不同。 第二层的用户交给AI的,通常是一个问题:一段文案、一封邮件、一次查询。第三层和第四层交给AI的,是一个项目:几千行代码、一项持续数周的研究。AI现在的进步,很大程度体现在“长任务”上,也就是能连续工作、自我纠错、拆解子目标。只问一个问题,很难感受到这种能力。拿AI做一次问答的人和拿AI推进一个项目的人,对它的评价自然不同。
第二,能力提升集中在可验证的数字领域。 编程和数学有一个共同点:结果对不对可以自动检验。代码能不能跑,证明是否成立,都有明确答案。这正是强化学习最容易发力的地方,模型可以在大量“做题、判分、改进”的循环中快速变强。写一份让领导满意的汇报、做一个合适的家庭理财决定,就没有这样的标准答案,进步也就没那么明显。AI的能力因此是“参差不齐”的。专业用户集中待在它最强的领域,普通用户日常碰到的却多是它相对弱的领域。
第三,访问门槛是实打实的。 免费版、付费版和内部系统之间,模型版本、算力额度和工具权限都不一样。一些报道在概括卡帕西的观点时提到,公众对AI的印象很大程度上来自免费版的旧模型,以及社交媒体上流传的“AI翻车”片段。很多人是凭一个较弱的版本加上几段出错的视频,给整个AI下了结论。
把三点放在一起看,卡帕西对第二层用户并不居高临下。他承认,一些非技术背景的朋友觉得AI没什么用,从他们自己的体验出发,这个判断有道理。
更深一层:每一层都把自己看到的上限当成AI的上限
顺着卡帕西的框架往下想,还能看出更值得注意的一点:漏斗里每一层都容易把自己看到的上限当成AI的上限。
第二层觉得AI“只是更好用的搜索引擎”,因为他们只用它搜索。第三层的专业用户虽然已经亲眼看到智能体几天做完过去几个月的项目,但他们同样看不到第四层。有媒体把第三层的感受概括为“智能体眩晕”:能力变化太快,连每天在用的人也很难准确判断它走到了哪一步。到了第四层,卡帕西的担忧换成了另一种:“人类的审阅与理解开始跟不上了。”
所以这个漏斗并不简单地对应“懂的人”和“不懂的人”,每一层都有自己的盲区。底层看不清AI已经能做什么,顶层看不清AI做出来的东西是否都可靠、是否都被理解了。前者涉及普及,后者涉及监督。两件事都和“人跟不跟得上”有关。
这个问题的影响不只在个人层面。公共讨论、政策制定和许多商业判断,往往是在第一、二层的认知基础上进行的,而技术前沿在第三、四层推进。认知分层持续拉大,社会就更难对AI形成一致的判断,“AI被高估了”和“AI被低估了”两种说法会长期并存,而且各自都有依据。
漏斗会自己变平吗
不太可能自动变平。卡帕西说差距在扩大,原因很直接:能力增长最快的地方在漏斗顶端,向下扩散却要经过多道门槛。
中国的情况可以作为参照。中国互联网络信息中心(CNNIC)第57次《中国互联网络发展状况统计报告》显示,截至2025年12月,我国生成式人工智能用户规模达6.02亿人,普及率42.8%。“用过AI”的问题已基本解决,大量用户停在第二层,“用好AI”成了更难的部分。
从第二层往下走,难点往往不在模型本身,而在于把模糊的需求变成AI擅长处理的形式。这一点和卡帕西说的成因可以对应起来:AI在目标清晰、步骤明确、结果可以检验的任务上表现最好,而普通人的需求大多是“帮我做个年终总结PPT”这样笼统的一句话。把一件事拆成几步,每一步选对工具、说清要求,本身就是一种需要学习的能力。专业用户经过长期使用自然掌握了这种能力,普通用户很少有机会系统地学。
已经有产品在做这种“翻译”。比如AIWW新上线的AI使用助手,用户填入“我想用AI___”,就能得到分步骤的做法、对应的工具和可以直接用的提示词。这类工具能否持续有效还需要时间检验,但它们针对的正是漏斗口最常见的那道门槛。
卡帕西的漏斗读起来很容易只盯着顶端:5000人、智能体集群、人类跟不上的速度。但对AI的社会影响来说,漏斗中间同样重要:几十亿人用过AI,却还没真正把它用起来。
AI普及的下一阶段,可能不取决于顶端再出现多强的模型,而在于每一层的人能否往下多走一步。对大多数人来说,这一步往往很小,比如用AI完整做成一件真实的工作,并且觉得它确实省了时间。