近期,国内多个互联网服务接连出现因高并发导致的系统故障:电商大促期间页面加载失败、茶饮联名活动小程序崩溃、AI应用因瞬时流量过载而全线瘫痪。这些事故有个共同点 —— 每次请求背后都躲不开一次IP查询:登录要查IP判断异地风险,支付要查IP 确认是不是从机房发起,广告要查IP做地域定向。
平时这些查询走在线API没问题,但一旦流量洪峰到来,每秒数十万次IP查询请求涌向API,限流、延迟、超时接连出现,风控链路被迫降级。针对这类问题,IP数据云的离线库方案提供了一种思路:将IP数据预加载到本地内存,把查询从“网络调用”变成“CPU运算”,帮助风控链路在流量洪峰中保持稳定。下面拆解原理和落地细节。
一、高并发下,IP查询为什么容易成为瓶颈?
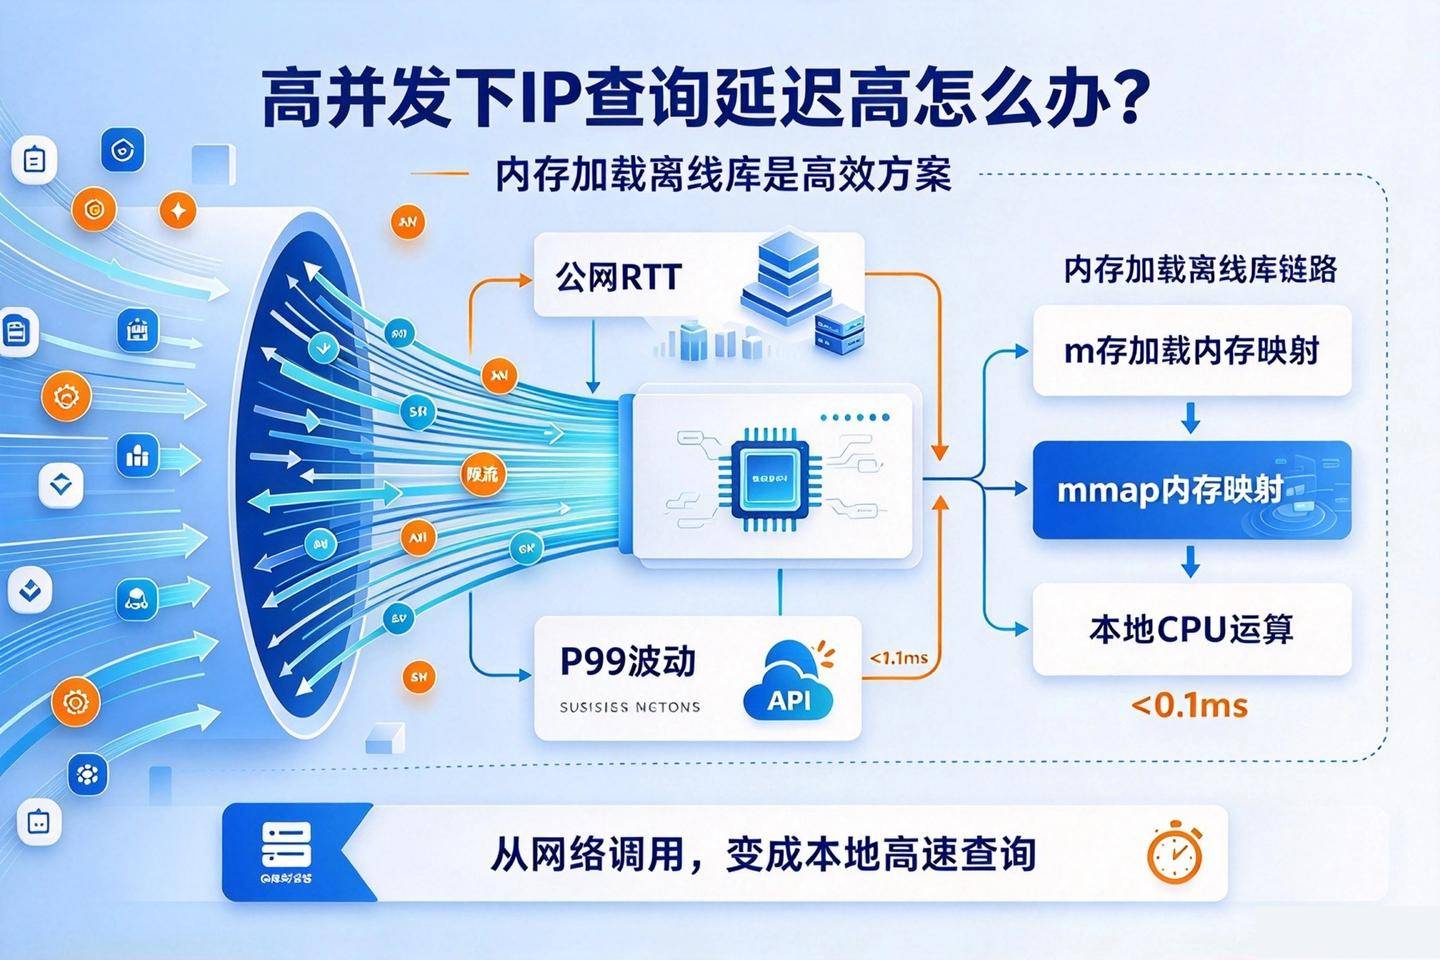
在高并发业务中,IP查询的特点是调用量大、实时性要求高、不能失败。一次登录请求要查IP,一笔支付要查IP,一条广告曝光也要查IP。单台服务器每秒处理数万请求,就意味着每秒要完成数万次IP查询。
在线API的延迟由“公网RTT + 服务端处理时间”共同决定,单次查询平均在30-80ms。高并发场景下,问题会被急剧放大:
- 网络抖动:公网链路不稳定,高峰期P99可能超过500ms
- API限流:大多数在线API有QPS限制,超过阈值直接拒绝或排队
- 成本线性增长:按次计费,调用量越大成本越高
更关键的是,当业务系统本身已经处于高负载状态时,每一次外部调用都在消耗本已紧张的线程和连接资源。在线API的延迟取决于“网络通不通”,离线库的延迟取决于“CPU快不快”——这个本质差异,决定了高并发场景下两种方案的稳定性上限不同。
二、内存加载离线库的核心原理
离线库的本质,是把IP段与地理信息的映射关系预制成二进制文件。查询时程序直接在内存中做二分查找或索引定位,不依赖网络。内存加载的三种方式:
- 一次性加载:启动时将整个数据库文件读入内存,查询最快,但内存占用较高
- 内存映射(mmap):将文件映射到进程虚拟地址空间,按需加载,内存占用低且查询性能接近内存
- 分片加载:只加载热点IP段,适合内存受限但查询量大的场景
在实际落地时,选支持内存映射的离线库 SDK,把数据库文件映射进进程虚拟地址空间,省掉自建索引的开发和维护成本。
三、关键指标对比
四、实操落地:从部署到集成
以下代码展示如何加载离线库并集成到业务系统中:
import ipdatacloud
import time
# 加载离线库(应用启动时执行一次,常驻内存)
db = ipdatacloud.OfflineIPLib('/data/ipdb/ip_data_cloud.mmdb', enable_risk=True)
def query_ip(ip: str) -> dict:
"""查询IP归属地,单次查询延迟<0.5ms"""
info = db.query(ip)
return {
'ip': ip,
'country': info.get('country'),
'province': info.get('province'),
'city': info.get('city'),
'net_type': info.get('net_type'),
'risk_score': info.get('risk_score')
}
# 压测示例
start = time.time()
for i in range(10000):
query_ip('203.0.113.45')
elapsed = (time.time() - start) / 10000 * 1000
print(f"平均单次查询耗时: {elapsed:.3f}ms")
高并发场景的额外优化:
- 多进程共享:使用mmap时,多个进程可共享同一份物理内存页,进一步提升吞吐
- LRU缓存:对高频查询的IP结果做短期缓存,命中率可达80%以上
- 降级策略:离线库加载失败时,降级为“放行”而非“拒绝”,避免中断业务
五、总结
高并发下做IP查询,争的不是 "准不准",是 "快不快、稳不稳"。洪峰一到,依赖公网的在线API随时可能卡壳。要快速落地IP数据云的内存加载离线库有现成的SDK和预编译数据库文件,支持mmap加载和多语言集成,不用自己从零建索引。无论是大促风控、游戏开服还是广告竞价,这套方案都能让IP查询不再成为系统的瓶颈。