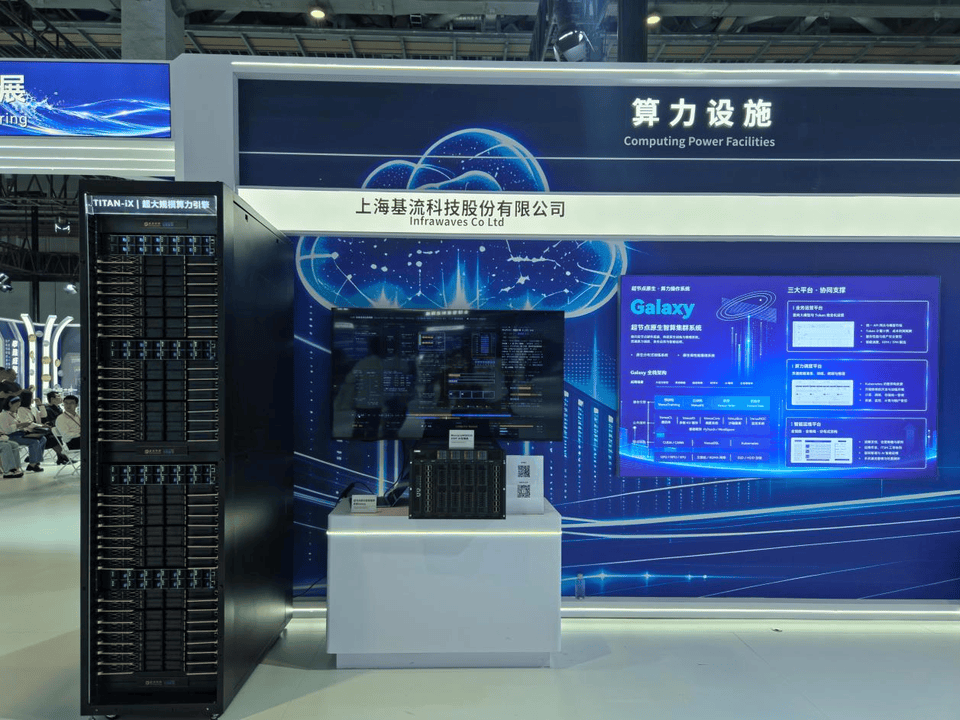
东方网记者程琦10月15日报道:第26届中国国际工业博览会在国家会展中心(上海)开幕。在人工智能与先进计算备受瞩目的背景下,算力基础设施服务商基流科技亮相“中国智造暨先进制造业创新实践展”,现场展出了其自主研发的AI算力集群系统“Galaxy”,重点呈现了面向大规模智算集群的高速互联、训推平台及软硬件协同工程能力。
当前,人工智能大模型的演进使得算力竞争从单一芯片算力峰值的比拼,逐步转向涵盖计算、通信、存储、散热与调度的集群系统级工程。业内人士指出,构建高稳定、高利用率的超大规模算力集群,已成为大模型训练和推理落地的核心支撑。
支撑大规模智算需求:已交付6个“万卡集群”
记者在现场获悉,伴随国内千亿至万亿参数大模型研发提速,超大规模集群的系统调优与运维成为行业刚需。
据官方披露的数据,截至2026年第三季度,基流科技已累计调优交付AI算力集群66个,覆盖GPU规模超过14万卡,其中包括6个万卡级超大规模算力集群;同时,公司持续提供专业运维服务的GPU规模超过3万卡。这些实际工程落地经验,为智算系统在超大规模环境下的软硬件协同迭代提供了数据与场景基础。
锚定超节点架构:自研国产高通量交换机部署超300台
面对大规模算力集群中日益严峻的跨卡通信瓶颈,业内正在加速引入“超节点”(Super-node)架构——通过超大卡间通信带宽提升集群扩展效率,并通过高密度集成优化硬件物料与部署成本。
围绕超节点架构的支撑,基流科技在展会现场展示了其自研网络互联与系统工程能力:
在硬件网络层面,展示了自研MS8836高通量网络交换机。该设备采用国产交换芯片,配备128个800Gbps端口,单向交换带宽达102.4Tbps,并融合了NPO(近封装光学)技术与自研开源网络操作系统,目前该自研高通量交换机已累计生产并部署超过300台;
在工程与基础设施层面,展示了适配超节点的IDC高密液冷改造方案与“算、网、存、热”一体化监控系统,通过低开销在线诊断技术提升集群长周期运行的稳定性。
软硬协同优化 应对十万亿级模型训推挑战
除底层物理网络外,大规模集群的有效算力利用率(MFU)同样取决于计算与通信调度的跨层协同。
现场技术演示显示,在软件训推平台层面,该系统针对稠密与混合专家(MoE)稀疏模型的训练,通过计算通信联合优化,可将集群实际利用率提升3%至6%;在推理阶段,通过拓扑感知与专家并行调度优化,显著降低了跨节点通信等待时延,提升吞吐效率。
业内技术专家分析指出,随着产业界开始探索十万亿参数级模型的计算架构,单靠堆叠芯片已难以满足训练需求。通过超节点设计、自主可控的高速网络以及软硬件全栈优化来破解通信与稳定性瓶颈,正成为国内AI智算中心建设的重要技术演进方向。