分离AI智能体执行与GPU推理环节可能提升加速器利用率,但由此产生的网络需求可能使部署复杂化,并削弱潜在的成本节省效果,分析师指出。
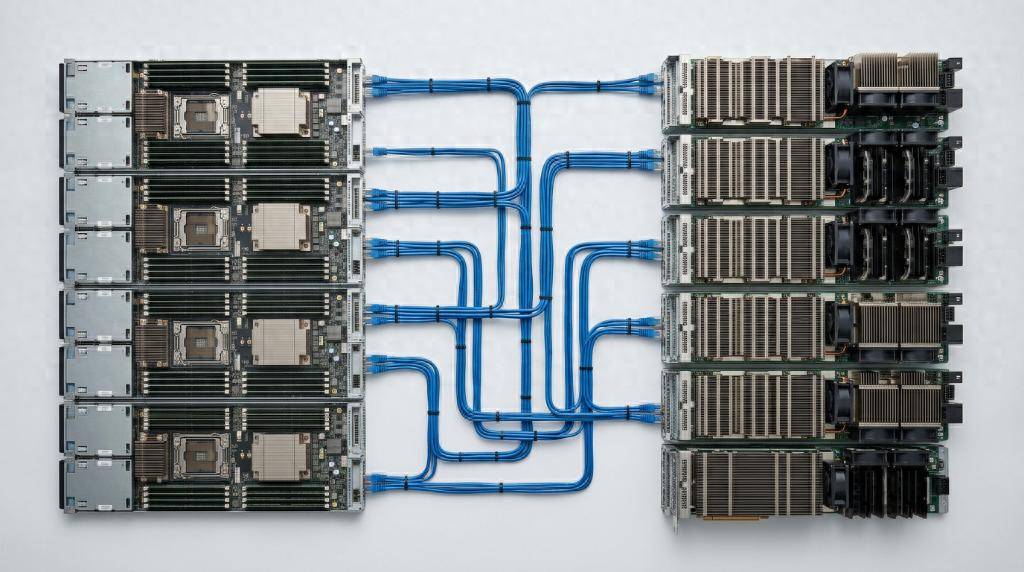
AMD推出了Helion,这是一种面向数据中心机架的开放蓝图,旨在让CPU在运行AI智能体方面发挥更大作用,同时允许客户根据其推理需求配置GPU资源。
该架构基于开放计算项目(OCP)规范,支持多种计算硬件组合。AMD列举的示例包括面向超大规模云服务商的纯CPU机架,配备第六代EPYC处理器,核心数最高可达32768个;以及面向企业的一体化机架,最多可容纳16个Instinct MI350P GPU。
AMD公布的Helion网络带宽上限为102 Tbps,不过该公司并未说明这一数字的具体计算方式。这一规格代表的是计划中的机架能力,而非客户环境中已验证的实际性能表现。
集成式Token路由器旨在将AI智能体的请求分发至不同模型,使企业能够在机架内同时使用云端托管的前沿模型与开源模型。
AMD表示该设计同时支持风冷和液冷。公司计划将Helion规范贡献给OCP,供业界进一步开发完善。
这家芯片制造商已公布了来自基础设施供应商的支持声明,包括思科、戴尔科技、HPE和联想。与生态合作伙伴共同开发的机架配置预计将于2026年11月上市。
CPU地位日益凸显
Omdia首席分析师连杰(音译,Lian Jye Su)表示,AI智能体应用的增长可能会提升数据中心对CPU的需求。虽然GPU负责处理模型推理,但CPU支持代码执行和工作流编排等任务。
“AI行业已经预期XPU与CPU配比将发生显著调整,从16:1逐步转向4:1,最终达到1:1,”连杰表示,他使用XPU作为包括GPU和定制AI芯片等加速器的统称。
Gartner高级首席分析师卡尼什卡·查汗(Kanishka Chauhan)认为,AMD的这一方案反映的是企业AI领域现有的工作分工,而非AI应用设计方式的根本性变革。他指出,CPU目前已承担了围绕GPU模型推理的大部分编排工作。
Forrester首席分析师戴查理(Charlie Dai)表示,将智能体执行与推理环节分离,将使数据中心运营商能够独立扩展CPU和GPU资源,有望提升加速器利用率。
“这其中的权衡是东西向网络流量的增加,这使得低延迟网络、数据本地化和可组合机架架构变得越来越重要,”戴查理说。
查汗指出,在漫长的智能体工作流中,CPU与GPU系统之间的反复交互可能在各个阶段累积网络延迟,因此机架间延迟是需要重点考量的因素。
集成挑战
Helion可能降低AI基础设施设计的复杂度,但企业仍需针对各个智能体工作负载计算总体拥有成本。戴查理表示,提升加速器利用率所带来的潜在节省,需要与电力、冷却及集成成本进行权衡。
查汗表示,Helion的一体化配置可以减少CPU服务器与独立GPU集群之间定制化集成的需求,从而有望降低部署成本。他还指出,超大规模云服务商也可以在现有GPU基础设施旁部署纯CPU机架。
如果将智能体执行与GPU推理分离需要升级网络以应对机架间增加的流量,额外产生的成本可能会抵消部分因GPU利用率提升而节省的费用。
连杰认为,软件成熟度、与AMD ROCm生态系统的兼容性,以及实现与更紧密集成平台相当的运维简便性,是部署过程中面临的其他挑战。
英伟达的替代选项
Helion的模块化设计可能会吸引那些希望将AI基础设施整合进现有环境的企业。
“在客户优先考虑多供应商选择、减少供应商锁定、成本灵活性或与现有x86/OCP环境集成的细分市场,开放架构能够对英伟达构成有意义的挑战,”连杰表示。
英伟达同样在扩大对开放基础设施标准的采用。本周,该公司宣布已将Vera Rubin机架和计算托盘设计贡献给OCP,并概述了旨在支持智能体AI工作负载的Vera CPU机架架构。
戴查理表示,思科、戴尔、HPE和联想等基础设施供应商的支持,对于向企业提供经过验证的设计方案和运维支持至关重要。他指出,要实现更广泛的采用,AMD需要证明具有竞争力的性能表现和软件成熟度,同时证明Helion能够带来更低的总体拥有成本。
Q&A
Q1:AMD的Helion架构是什么?
A:Helion是AMD推出的一种面向数据中心机架的开放蓝图,基于OCP规范,旨在让CPU在运行AI智能体方面发挥更大作用,同时支持企业灵活配置GPU资源以满足推理需求。
Q2:Helion架构为什么要把CPU和GPU的工作分开?
A:这样做可以让数据中心运营商独立扩展CPU和GPU资源,提升加速器的利用率。但分离后会增加机架间的网络流量,对低延迟网络和数据本地化提出更高要求。
Q3:Helion什么时候能投入使用?
A:与思科、戴尔、HPE、联想等生态合作伙伴共同开发的机架配置预计将于2026年11月上市。