DeepSeek-V4.1-Flash-1017刚刚重磅开源,是一个多模态模型,一共7630亿参数。
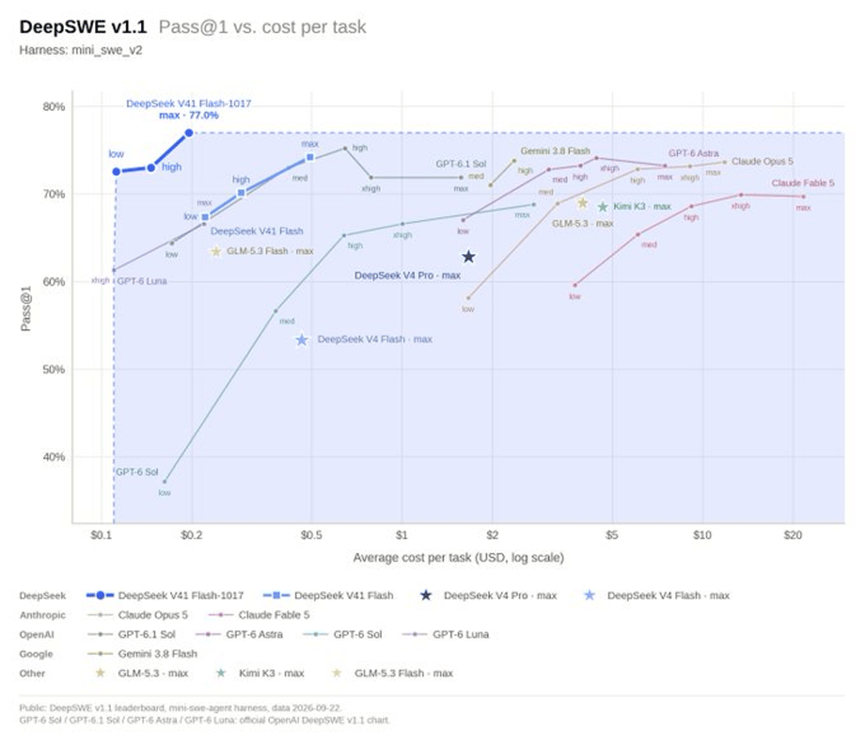
根据官方测试数据显示,V4.1-Flash在写代码、办公自动化、智能体测试、动手调工具四大关键测试,超过了GPT-5.6-Sol、Opus 5顶级闭源模型,并且更省钱。
同时也兼容 CodeBuddy、WorkBuddy热门AI应用。

开源地址:https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-1017
光说省钱没概念,咱看个实测。有人直接拿V4.1-Flash和GPT-6 luna做了对比,效果好像也差不多。
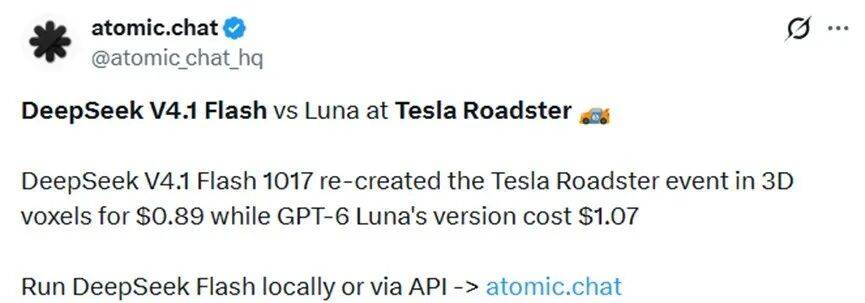
用同样的提示词开发了一个3D小游戏,Opus 5.5用了20分钟,花了6美元。
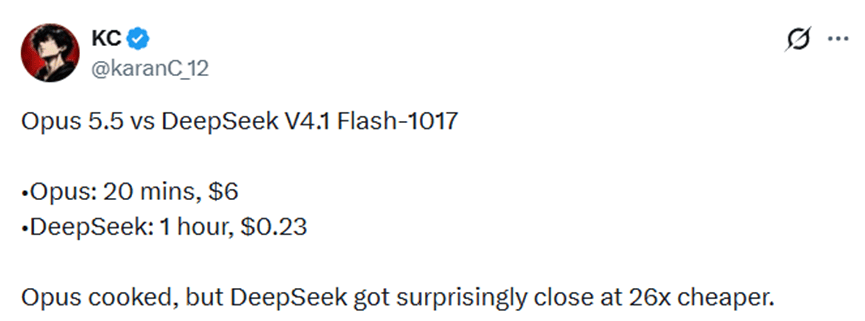
V4.1-Flash花了一小时,但是仅用了0.23美元,价格一下就拉开了26倍。
除了便宜之外V4.1-Flash的性能也相当能打。比如只给一个HTML文件,写个带四个关卡的第一人称跑酷游戏,中间还得让模型自己修一次bug。
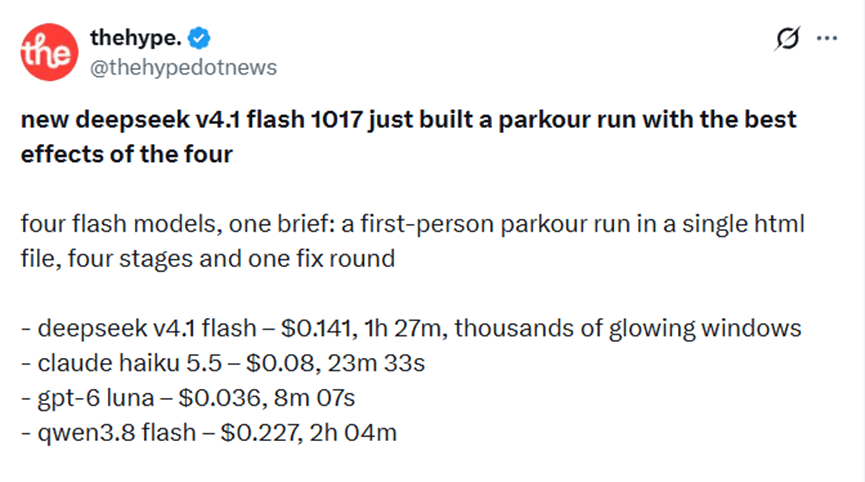
这次让V4.1-Flash、Claude Haiku 5.5、GPT-6 Luna 和 Qwen3.8 Flash同场竞技。
结果显示, V4.1-Flash完成的效果是四个模型中最好的,价格虽然比Claude Haiku 5.5、GPT-6 Luna高了一点。
但开发出了一个包含了几千个发光窗户的精细场景,视觉效果拉满。这一点其他三个模型都没有做到。
下面咱们在说说V4.1-Flash的各种特色功能。
许愿编程V4.1-Flash这次最大功能亮点绝对是许愿编程。其实上面那四个模型对比,V4.1-Flash能胜出也是因为这个功能。
简单来说,就是你不需要像以前那样,写一大段详细的prompt,把每个细节都描述清楚。
你只要说一句给我做一个网页版赛车游戏,可以选择车辆和赛道。
V4.1-Flash就会自己规划技术栈、搭建项目结构、写代码、调样式,最后给你交付一个能直接在浏览器里跑起来的游戏。
原生多模态V4.1-Flash-1017采用了全新的Causal-Encoder-Decoder非对称架构,原生支持图像和文本的混合输入。
不像有些模型的多模态是后来打补丁加上去的,DeepSeek-V4.1-Flash-1017从架构设计层面就把视觉理解能力内嵌进去了。
你可以丢一张设计稿进去,让模型帮你还原成代码,也可以拍一张手写笔记的照片,让模型整理成结构化的文字。
搜索API正式开放这次更新还有一个容易被忽略但很有价值的变化,就是DeepSeek把自研搜索引擎的能力通过API开放了出来。
新增的Search和Fetch两个接口,定价都是0.75美元1000次。
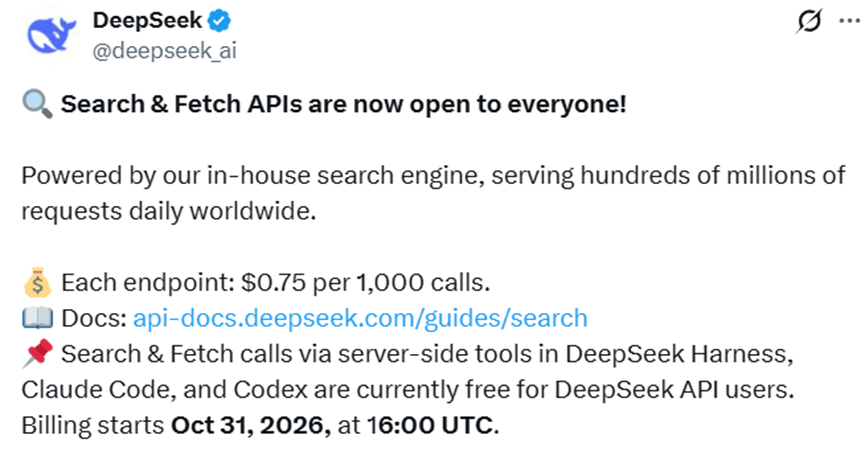
V4.1-Flash的搜索引擎索引了全球千亿级网页,支持多语言搜索,而且针对SEO作弊和低质AI生成内容有专门的过滤机制。
对于做AI Agent开发的团队来说,这个接口的实用性非常高,省去了自己搭建搜索基础设施的麻烦。
数据测试先看最考验综合推理的HLE榜单,有点类似给模型出的高难度综合智力测验。
GPT-5.6-Sol拿了44.5 分,V4.1-Flash这边是 42.6 分,差距不到两分,基本是紧贴着追。Opus 5 就明显高一截,冲到 56.3 分。
在DeepSWE这个专测让模型自己写代码、改bug的榜单上,V4.1-Flash拿下 77 分,把GPT-5.6-Sol 的73分和Opus 5的74分都甩在后头。
另一个测自动化办公流程的Automation-Bench上,V4.1-Flash拿了60.5 分,更是把GPT的45.8 分和Opus的50.3分远远甩开。
在考验模型自己上手操作、调用工具的榜单上,V4.1-Flash几乎是压着对手打。
测终端命令行操作的 Terminal-Bench 4.0,V4.1-Flash为42.3 分,超过 GPT 的 39.9分,只差 Opus 的 51.8 分一点。
就连测智能体考试能力的 Agents' Last Exam,也拿了35.4 分,比那两位都高。
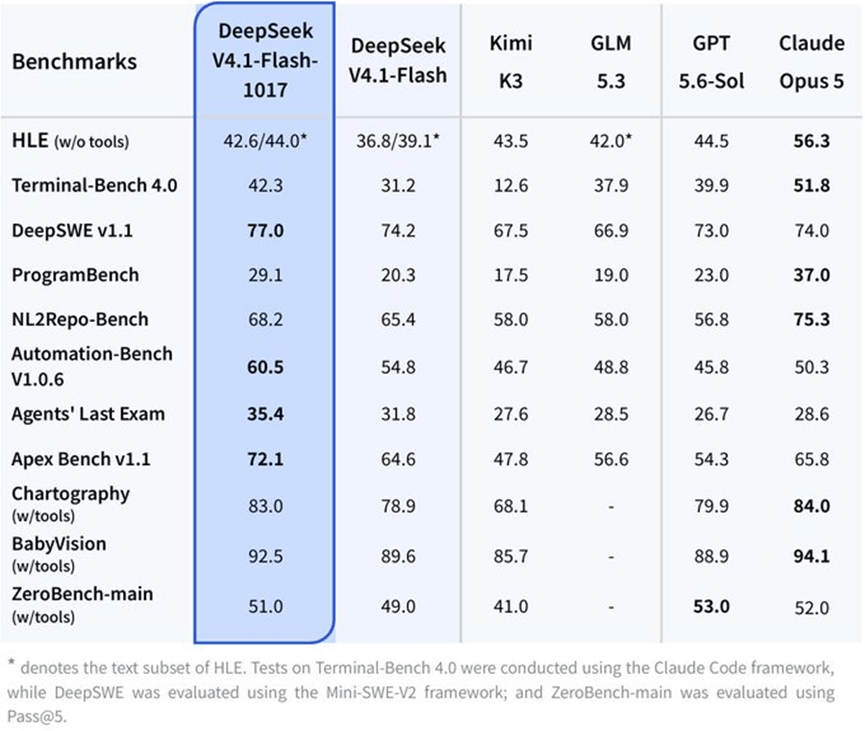
多模态的测图表理解的 Chartography,V4.1-Flash为83分,跟 Opus 的 84 分、GPT的79.9分基本在同一水平线。
测婴儿视觉的 BabyVision,V4.1-Flash为92.5 分,稳压 GPT 的 88.9分,就比 Opus 的 94.1差一点。