具身智能正在面临一个日益严峻的问题:当数据规模与模型能力持续增长,我们应该如何衡量模型的能力进步,又该如何发现模型缺陷,加以改进?衡量模型能力需要一把客观可信的标尺,评测体系正是行业必不可少的基础设施。
然而目前的模型评测存在诸多问题:真机评测成本昂贵、耗时缓慢,难以满足研发高频次、大规模的测试需要。仿真评测虽然能大幅提升测试效率,但又面临仿真不够“真实”、题库不够“丰富”的问题,很容易被模型“摸透规律”刷分,评测能力难以伴随模型能力共同成长。
今日,自变量发布 X2Real——一套可进化的仿真评测基准,旨在评估具身模型在真实物理世界中的性能。它提出三个设计原则:可信性(Faithfulness)、有效性(Effectiveness)和客观性(Fairness),分别通过与真实硬件对齐的仿真、多维度的任务设计,以及自动化的评测与诊断流程,让仿真评测成为模型性能的可信标尺。
更重要的是,X2Real 是一套能够伴随模型成长不断进化的评测体系,其评测能力不会随着模型能力提升而过时。经过测试,X2Real 仿真评测与真机评测的任务成功率相关性达到 0.96、进度分相关性达到 0.99,居于行业最前列水平。它真正实现了“让模型能力可度量,让研发进步可积累”,成为具身行业的关键基础设施。
仿真忠实还原真机表现,任务成功率相关性高达 0.96
X2Real 的第一个原则是可信性,即忠实反应模型在物理世界的真实能力。这要求 X2Real 能够以极高的仿真度模拟机器人在现实物理世界的动作。
但仿真与现实之间存在天然差异:关节的响应快慢、画面的质感、物理的重量与摩擦力,这些细节的仿真失真都会影响模型策略的表现。因此,要让仿真评测成为可信赖的“考场”,第一步就是将虚拟机器人调试到与真实机器人表现一致。
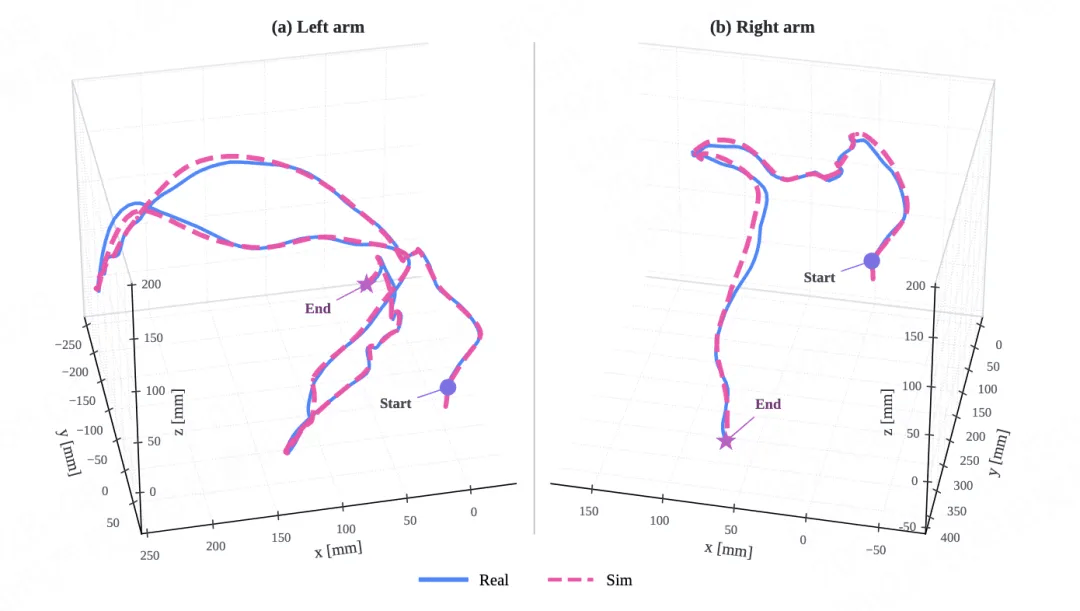
X2Real 采用与真实硬件对齐的仿真标定,去校准仿真世界里的机器人视觉、物理和控制特性。在控制参数方面,自变量团队先记录下真实机械臂的运动轨迹,再将同样的控制指令输入仿真系统,比较两者的运动轨迹,反复调整关节的响应力度,直到两者一致。经测试,X2Real 能够实现毫米级的轨迹一致性。
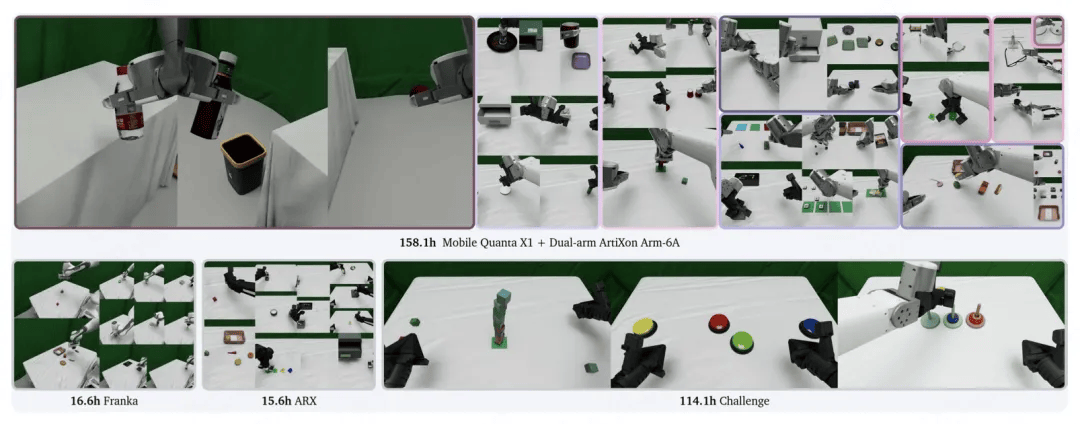
在视觉特征和物理属性上,X2Real 也都对偏差做了细致标定,确保模型在仿真中看到的画面、感受到的接触反馈,都与现实一致。这些标定覆盖了多种主流机器人本体,包括单臂 Franka、双臂 ArtiXon Arm-6A、ARX R5 和移动操作平台 Quanta X1 等。
测试显示,X2Real 经过标定能够忠实反映模型能力:在通用操作任务上,仿真评测与真机评测的任务成功率相关性达到 0.96、进度分相关性达到 0.99,仿真评测足以成为模型能力的可信量化依据。
44 个任务“海量题库”,全面考核推理与操作能力
X2Real 的第二个原则是有效性,即综合全面地考察模型的能力和短板。它从任务的多样性入手,将通用操作能力分为推理与操作两个类别:推理即正确理解任务指令和视觉输入,作出正确的动作决策;操作即正确执行对应的动作,达到预期的结果。
X2Real 共设计了 10 个类别的 44 个仿真任务,能够覆盖推理与操作中的多类关键能力。具体来说,4 类推理能力包括泛化、视觉理解、语言理解、记忆;5 类操作任务包括精细操作、双臂协同、工具使用、动态物体操作、移动操作。用于评测的任务由其中的一系列动作组合而成,比如拉开抽屉放入药瓶、将眼镜挂上木架子等。
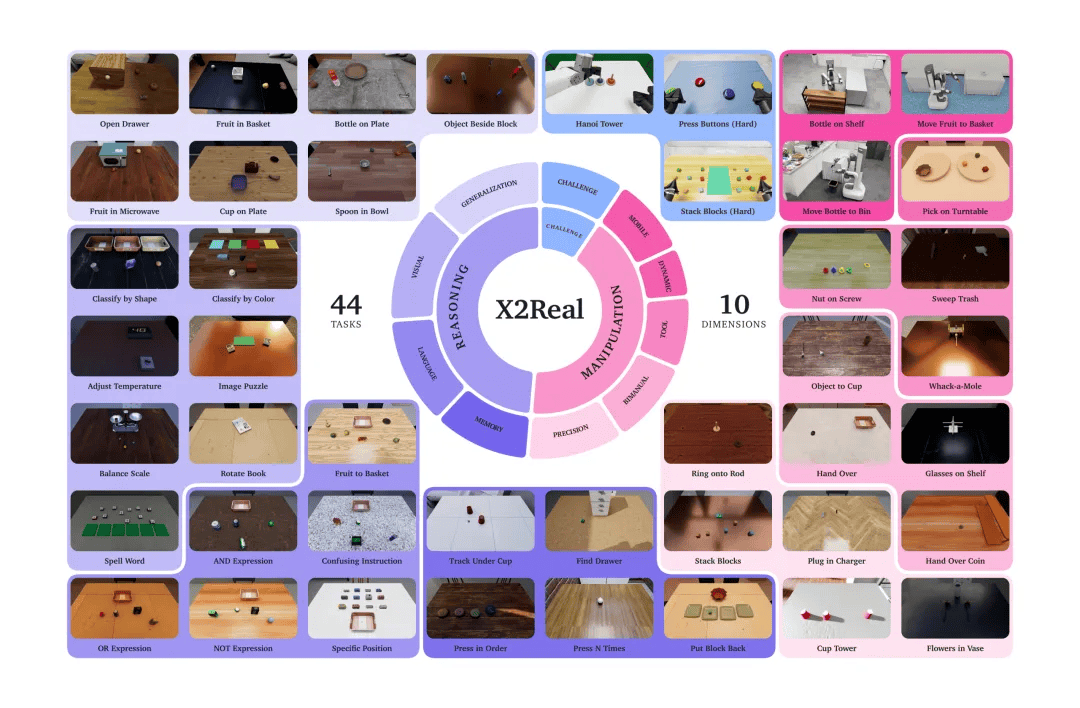
此外,X2Real 还专门设计了一类挑战任务,包括堆叠积木、按指定颜色序列按键、解决汉诺塔,分别考核模型的运动精度、长时记忆和推理规划能力。目前,这些任务对大部分具身模型都有很大的挑战,为模型未来进步留下充足的评测空间。
严格隔离训练与考试配置,杜绝模型“背题”刷分
X2Real 的第三个原则是客观性:既减少模型靠“背题”获得高分的可能性,也保证各种模型在同一规则下可以比较。围绕客观性要求,X2Real 做出三点设计:
一是任务的多维随机化。X2Real 将任务拆分为三个维度:外观条件,包括背景、光照、桌面材质纹理;任务设置,包括任务资产、物体摆放、干扰物布局、语言指令;具身条件,包括夹爪类型、相机参数、桌面高度。这些维度分别随机化,确保模型无法靠“死记硬背”评测环境获得好成绩。
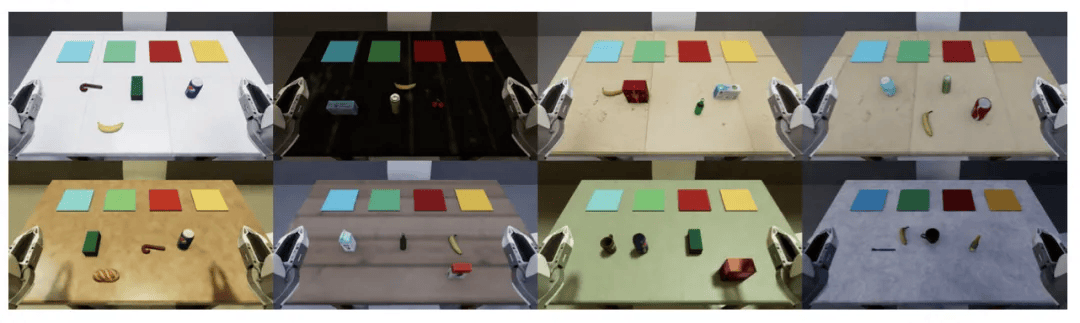
二是严格分离训练与评测配置。模型在测试前,都需要在 X2Real 提供的近 300 小时数据集上进行后训练。X2Real 确保这些训练数据在统一的绿幕摄影棚中采集,与评测的考试环境完全隔离,能够检验模型对新配置的泛化能力,杜绝“考前泄题”的风险。
三是持续生成新考题。X2Real 使用由英伟达 Isaac Lab-Arena 支撑的 Mana 仿真生态系统,将场景、机器人、任务步骤和环境都打包为可复用的模块,能够持续生成新的评测组合,相当于拥有无限的题库。
智能体驱动任务设计与评分,让评测成为“自动化流水线”
X2Real 能持续扩充考题,靠的是一套让大模型智能体深度参与的工作系统。
智能体同时驱动两个循环:一是任务设计的循环,持续编写新任务、新场景,扩充评测体系;二是回放分析的循环:每次评测后自动读取失败节点与轨迹,定位能力薄弱的环节,生成新的针对性任务。
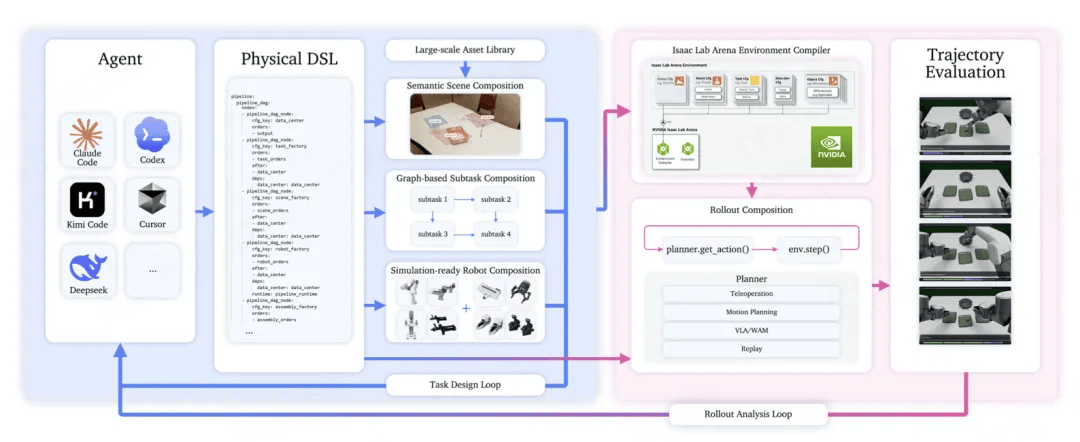
在任务设计循环中,智能体会驱动仿真软件搭建任务。通常,使用仿真软件需要处理复杂的底层接口,智能体难以直接使用。X2Real 则不直接使用这些接口,而是给智能体提供一套标准化的“可选项”:选择场景、摆放物品、定义任务步骤、选择机器人形态。配置完成后,系统还会自动检测,剔除掉不合理的配置。
在回放分析的循环中,X2Real 会将每个任务拆解为任务图:子任务按照先后关系连接成流程,每个节点的完成情况,都由物体姿态、接触关系、抓取状态等自动判定。即使模型未能完成最终任务目标,开发者也能知道它卡在哪一步,为改进模型提供清晰的诊断意见。
此外,智能体还会根据每次评测的节点记录,定位出模型能力的薄弱环节,针对性地生成新考题。可以说,在 X2Real 系统中,人类只提供高层意图,具体迭代都由智能体执行。这真正将“出题、判分、补题”的一整套评测流程,从人力密集工作变为可自动运行的流水线。

得关注的是,在传统评测中,由于不同模型拥有不同的接口,包括输入格式、动作表示、推理节奏等,难以直接互相比较。X2Real 通过统一评测协议(Policy Space)将这些差异由适配层统一翻译,相当于给所有模型发了同样的“答题卡”。
通过统一评测协议,X2Real 也大幅降低了评测门槛:开发者不需在本地搭建仿真环境,只需要接入统一模型接口、在本地运行模型推理服务,平台就能在线完成评测判分和轨迹回放工作。这使仿真评测变成开发者触手可及的行业基础设施。
“扎实的度量”将带来“扎实的进步”,仿真评测与模型能力共同成长
具身智能的持续迭代,需要一套能够与模型共同成长的评测体系。X2Real 在真实反映模型能力的基础上,能够提供更加细致的诊断方案,持续参与模型的改进,让每一次评测都成为模型能力下一次增长的起点。
自变量团队相信,建立持续可信的评测反馈机制,是具身智能实现长期持续进步的前提。当模型能力能够被持续验证,失败经验就能被系统地积累,数据、算力与算法资源就能投入到更有针对性的研究方向,提升模型研发的效率。
X2Real 希望为行业建立的,正是这样一个能够伴随模型持续成长的评测基础设施。在具身智能模型发展的道路上,当每一步足迹都可以被丈量、被记录、被评估,最终将汇集成一条通向“物理智能奇点”的康庄大道。