AI大模型落地、算力租赁业务持续发展的背景下,GPU算力卡作为智算集群的核心硬件,其稳定性直接关系到业务能否正常运转。不少运维团队日常巡检,大多只确认算力卡能否正常跑通任务,却容易忽略一类隐蔽风险:硬件慢性累积损伤。
这类隐患不属于烧毁、短路这类一眼就能排查的显性故障,更像是硬件的“慢性病”,不会直接造成设备宕机,但损伤会持续累积。等到问题集中爆发时,往往会直接中断正在执行的 AI 训练任务,给算力服务商带来不小损失。
算力卡慢性损伤,大多源于长期高负载连续运行、散热条件波动、供电不稳定、元器件自然老化、静电侵蚀等因素。
它的前期信号十分微弱:偶尔出现任务报错、算力输出波动、显存校验异常、训练任务无故中断,重启设备后又能短暂恢复正常。很多运维人员常会把这类现象归结为软件环境问题,错过了早期排查的窗口。
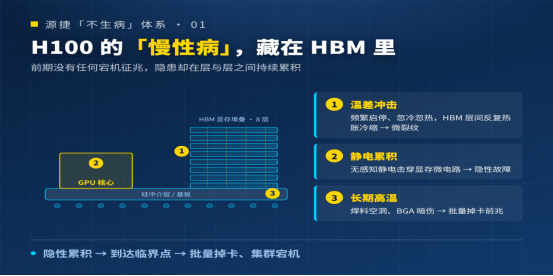
隐患搁置越久,后续处置成本越高
对于算力服务商而言,算力卡突发故障,会造成训练任务中断、断点文件丢失,需要投入额外算力与时间重新跑任务;多张算力卡接连故障,还会产生高额硬件更换成本、业务停机损失,同时影响客户对于集群服务稳定性的信任。
应对这类问题,核心思路并非故障发生后再抢修更换,而是建立“前置健康预检机制”。
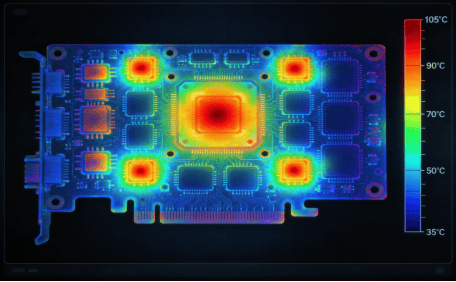 自主研发红外热像缺陷定位专利技术
依托标准化硬件检测方案,定期对集群内GPU算力卡开展深度检测,重点核查显存运行稳定性、供电链路状态、高温压力表现、接口工况,抓取硬件底层异常日志,在损伤早期识别风险。对存在隐患的算力卡及时轮换、维护,变被动抢修为主动预防。
这套运维方案,可适配算力租赁、AI模型训练集群、线上推理服务平台等多种业务场景。
做好常态化硬件健康评估,能够有效延长GPU硬件使用寿命,降低集群非计划停机概率,保障算力业务稳定交付。
算力硬件是智算行业重要资产,稳定运行也是降本增效的关键一环。持续做好算力卡健康管理,守住集群硬件可靠性底线,才能为业务提供稳定可靠的算力支撑。
本文为行业科普内容,仅作技术交流参考,不构成采购服务承诺。欢迎行业同行交流探讨。