●MAX大郭的判断局
WORKLOG
工作周报|10.26—11.1:从评测工具到研究实验
从公开页面到开源修复,再到评测预试:记录本周实际推进的工作。
2026 / 11 / 01
这一周,我主要推进了个人网站、计算社会科学研究、开源项目贡献,以及一系列关于 AI 评测和反馈可靠性的实验。
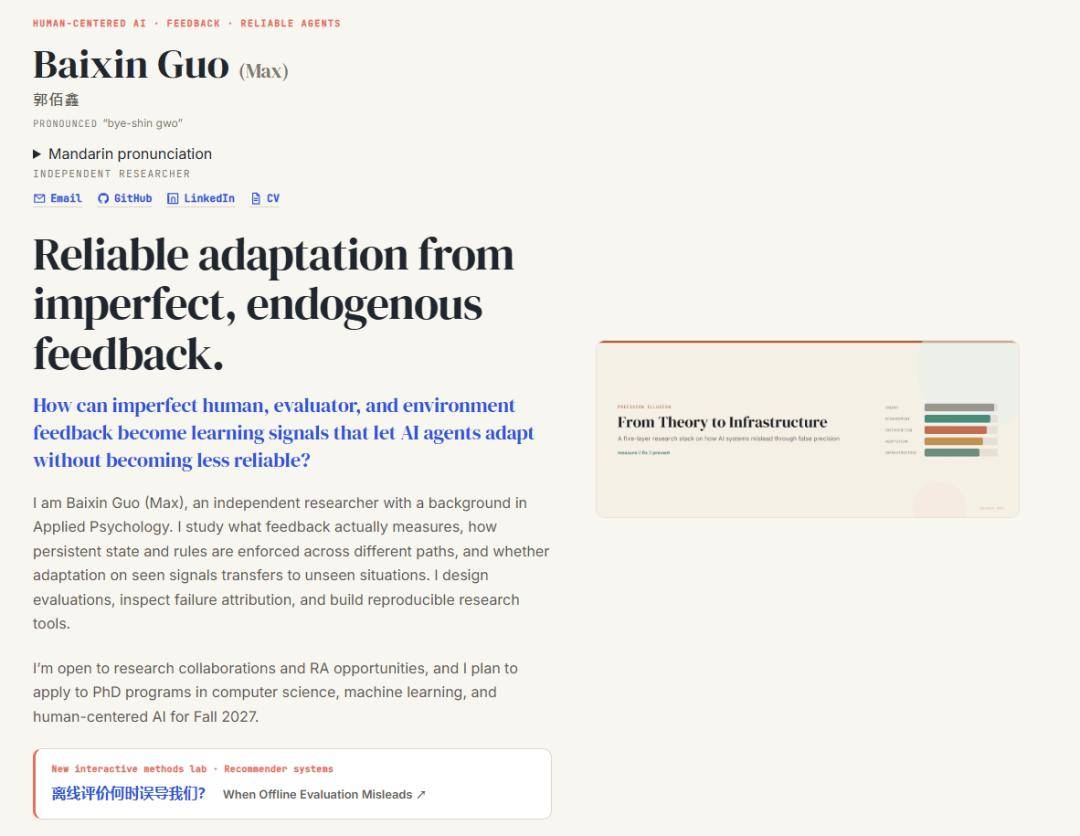
下面按项目记录: 它们分别解决什么问题、我这周做了什么,以及目前进展到哪一步。已经上线、等待审查和仍在预试的工作会分别说明。
01本周交付速览
项目 | 本周交付与状态 |
|---|---|
个人网站 | 离线评测交互实验室、《六个时钟》等页面上线 |
UniRL(腾讯混元) | 奖励组件加载流程 PR 已合并 |
Marin(marin-community) | 轨迹偏好数据可行性核查已合并 |
Tapestry / Mosaic / skill-up | PR 已提交,仍在审查 |
AI 评测与反馈工具 | 离线分析、合成预试及数据准入工具,逐项注明范围 |
原则
01公开呈现
个人网站与「言说的边界」:让读者能找到页面、来源与可复现材料。
02开源贡献
区分已经合并的改动、等待审查的 PR,以及公开问题讨论。
03研究预试
检查数据、评分和反馈能支持什么判断,再决定下一步是否投入完整实验。
一、个人网站与计算社会科学
这一部分记录公开入口、历史证据整理和网站集成。
021. 上线离线评测交互实验室项目背景
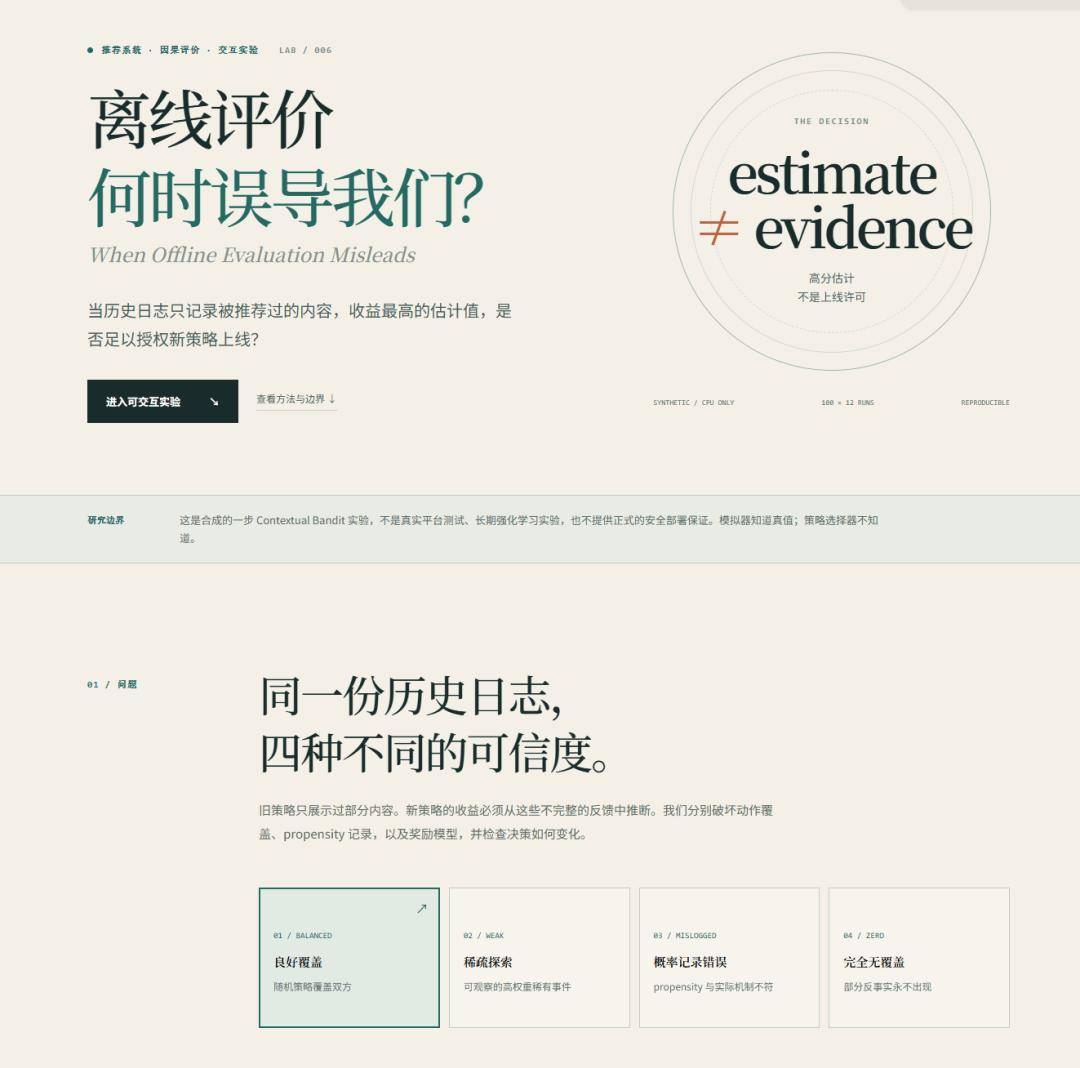
当一个系统只能使用历史数据评估新策略时,数据记录方式有误,可能会让一个实际上更差的策略看起来更好。
我具体做了什么
我把此前围绕这个问题制作的合成实验,整理为中英文交互页面,并放入个人网站。页面配有模拟结果、审计数据和可下载的 Python 复现代码,也在首页增加了入口,方便读者直接体验。
实验注记 · 本周更新范围
这一周主要完成的是公开呈现和网站集成;底层的模拟实验并不是全部在本周新做的。
入口:离线评价何时误导我们?
032. 推进「言说的边界」
项目背景
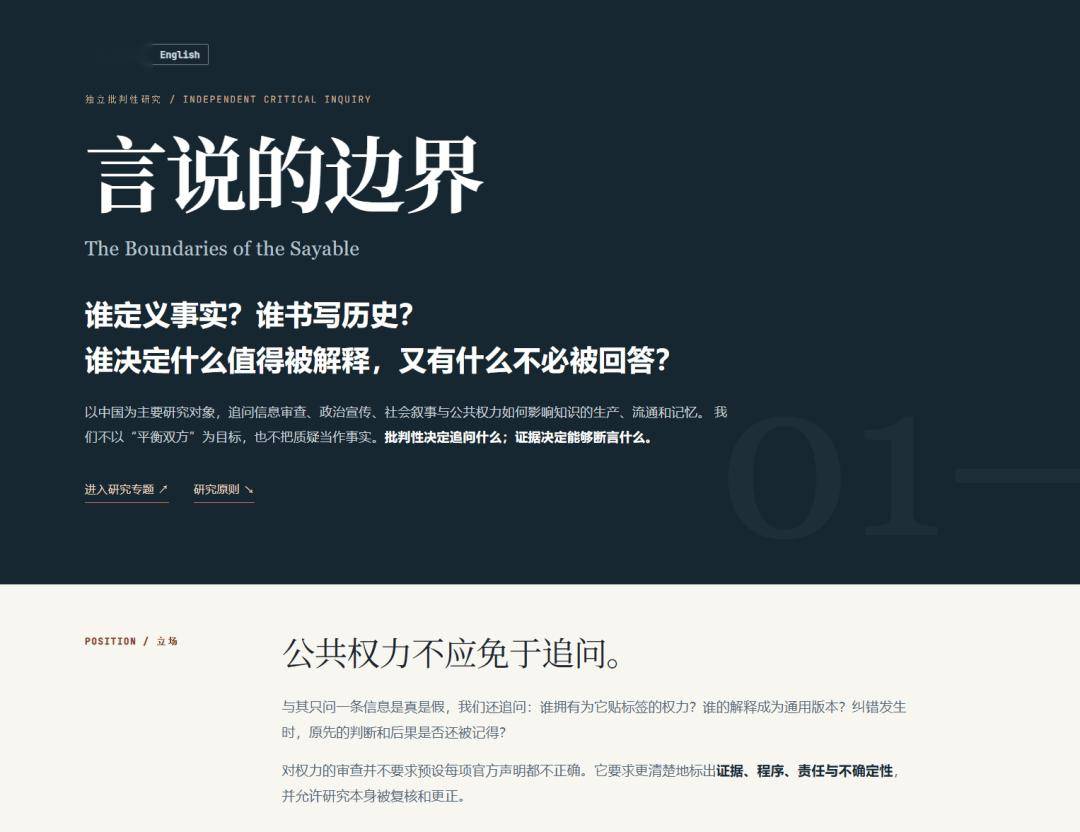
「言说的边界」是我正在建设的计算社会科学与社会技术研究专题,关注公共权力、信息控制、历史叙事和公众表达,也关注不同时间出现的证据会怎样改变我们对事件的判断。
我具体做了什么
本周完成了中英文专题入口,并发布《六个时钟》:尝试把信息出现、被定性、执法、政策变化和后续资料核查等时间区分开来,避免用后来才知道的事实,直接替代人们当时可获得的信息。
同时,我继续整理上海、李文亮等案例的历史证据和版本关系,制作了离线浏览器和时间校验工具。正式公开的文章已经附上来源;其他仍在研究的案例,尚不能当作已经完成的事实裁决。
这周还把信息治理联合试采推进到 v1.0:围绕六个重点案例整理来源、时间节点与原子命题,并制作离线证据浏览器。
证据边界
这些数量是审计记录,不代表总体样本;相关案例仍有原始材料缺口,独立复核也尚未完成。
入口:言说的边界 · 《六个时钟》
043. 更新个人网站
本周也调整了网站对研究项目、工程项目与研究产物的标注,修正 GitHub Pages 子路径下部分站内链接可能跳错的问题,并加入构建检查。
网站:Baixin Guo(Max)的个人主页
二、开源项目与工程贡献
先说明原项目做什么,再说明我提交了哪些改动,以及上游是否接受。
051. UniRL(腾讯混元):调整奖励组件的加载流程项目背景
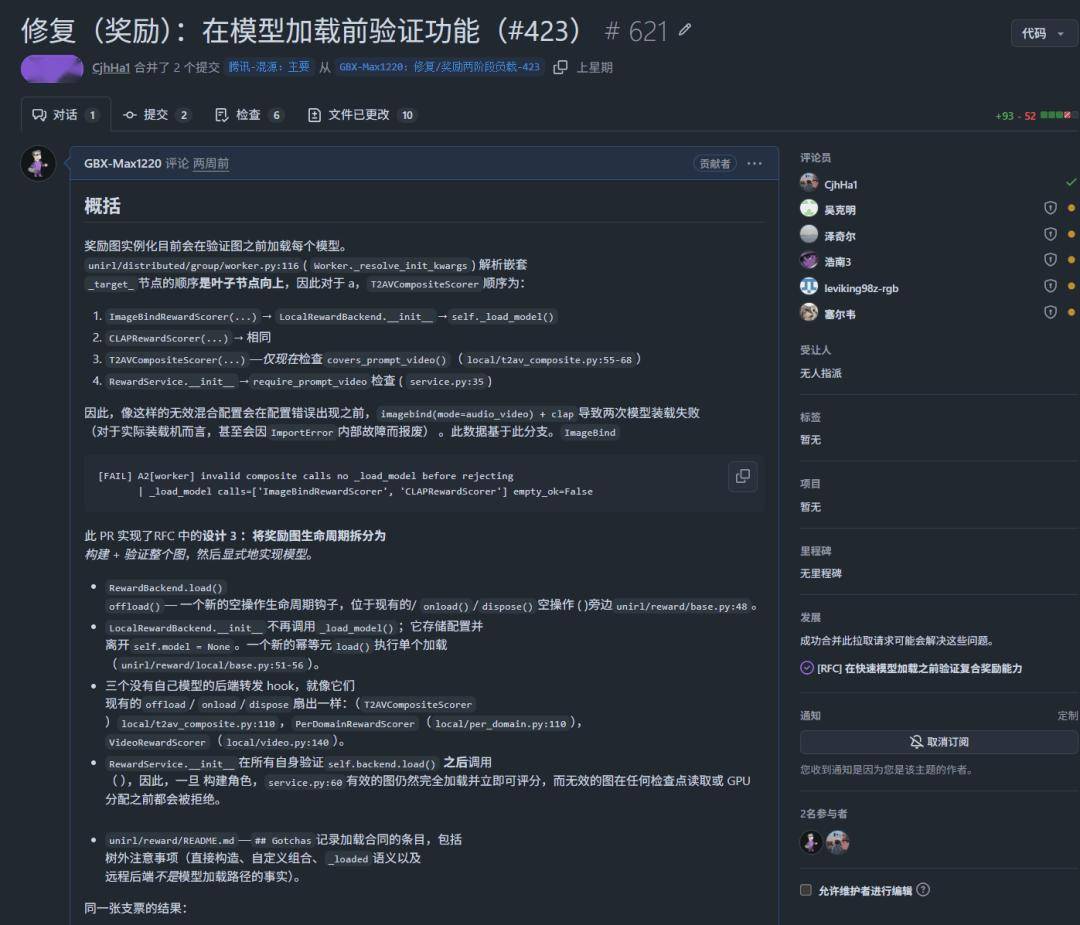
UniRL(腾讯混元) 是用于智能体强化学习的开源框架。奖励组件的配置如果不完整,理想情况下应该尽早报错,而不是等到模型加载后才发现问题。
我具体做了什么
奖励组件加载流程的修复 PR 已合并。
本周交付
支持:奖励组件加载流程的修复 PR 已合并。
我提交的 PR 将奖励图检查前移,延迟模型实例化,并处理重复加载的行为;配套 CPU 测试覆盖了相关路径。
边界:仅限配置检查和加载生命周期,不代表训练效果提升
实验注记 · 后续预检
随后,我还围绕一个相关问题做了小型预检工具:如果一个奖励组里的有效分数过少,或者分数完全相同,组内终局奖励可能无法提供区分信号。工具目前只在合成数据上验证,尚不能判断真实训练中这种情况有多常见。
链接:已合并的 PR #621 · 研究问题 #635
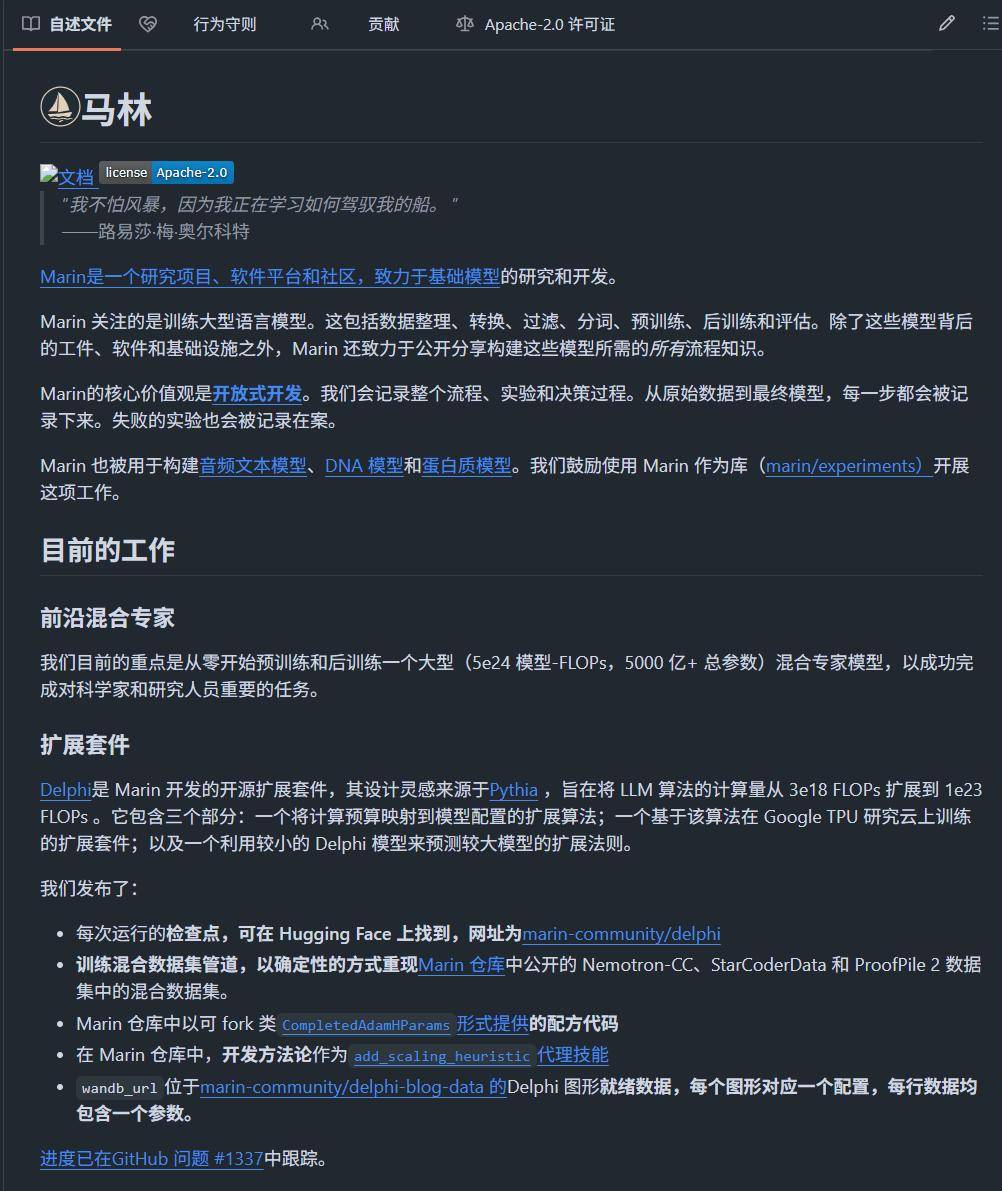
062. Marin(marin-community):检查智能体轨迹能否用于偏好学习项目背景
Marin(marin-community) 是一个用于大语言模型训练与研究的开源项目。我参与检查:现有 agent 轨迹是否能构造“同一历史下,比较不同动作”的偏好数据。
我具体做了什么
数据能支持到哪里
这次工作确认,部分轨迹可以在解析层面定位动作;但现有样本每个任务只有一条轨迹,也缺少动作级结果标签,不能直接形成有依据的自然偏好对。
轨迹偏好数据的可行性核查已合并。
本周交付
支持:轨迹偏好数据的可行性核查已合并。
交付的是数据筛查和复现代码,没有进行偏好训练。
边界:仅限数据筛查和复现代码,没有进行偏好训练
链接:Marin PR #10741
073. Tapestry(AI Alliance 联盟)与 Mosaic(LARK-AI-Lab):评测门槛和奖励噪声我具体做了什么
在 Tapestry(AI Alliance 联盟) 中,我提交了一个可选的区间决策策略:当外部已经给出不确定性区间时,让评测门槛能够使用这些信息,而不是只看单个分数。它不负责自行估计区间。
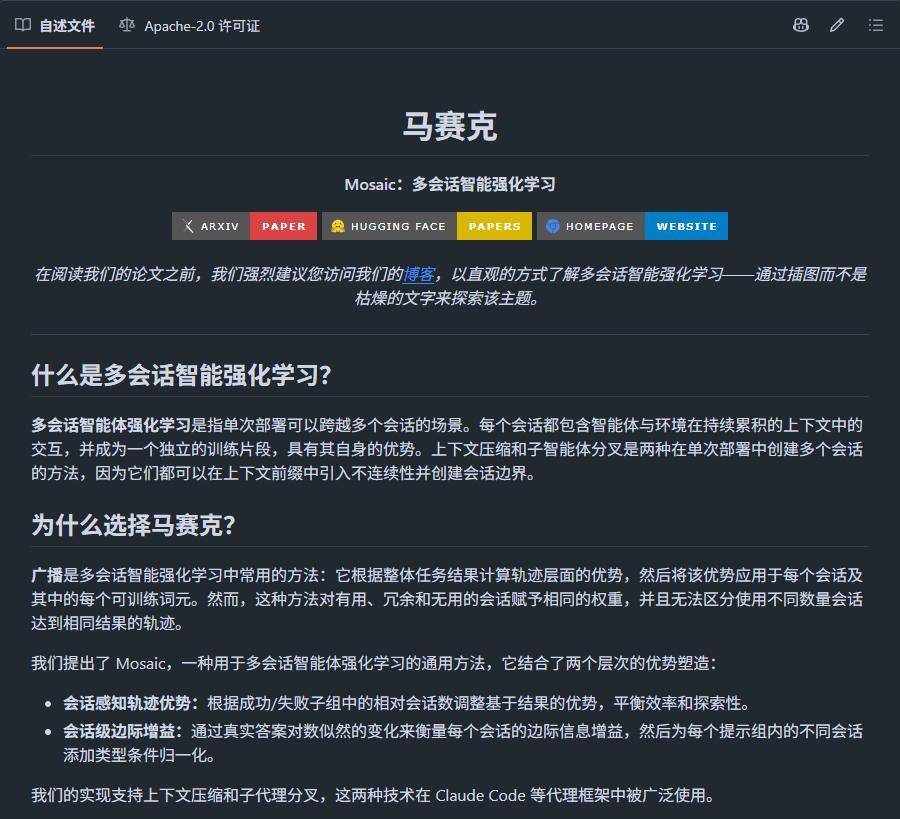
在 Mosaic(LARK-AI-Lab) 中,我做了 CPU 合成敏感性分析:人为改变部分结果标签,观察组内相对优势如何变化。它使用的是合成数据,不能推断真实训练运行受到了多大影响。
实验注记 · 当前阶段
两项 PR 目前仍在审查中。
链接:Tapestry PR #318 · Mosaic PR #3
084. skill-up(阿里巴巴):让评分结果更容易保留和检查
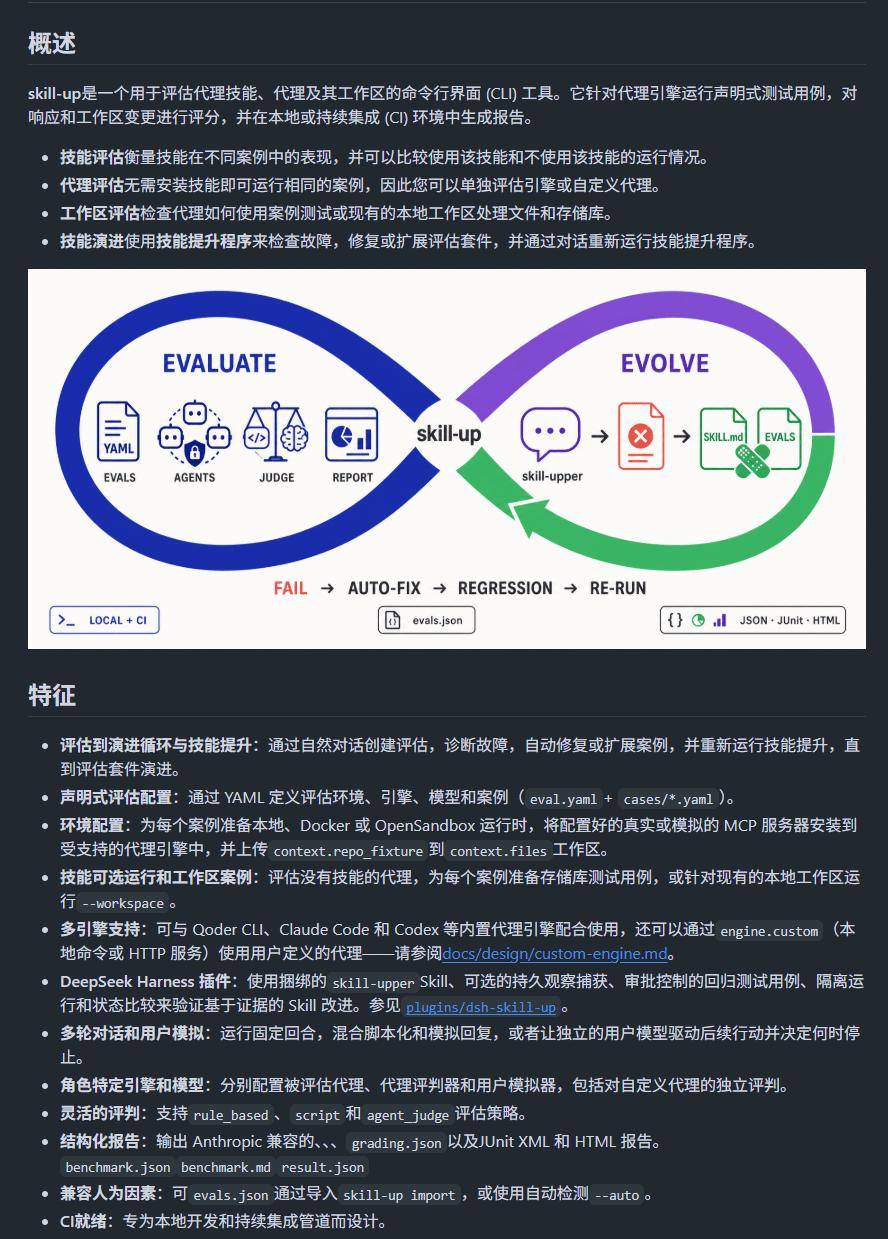
skill-up(阿里巴巴) 是一个技能训练与评测项目。我在一个仍在审查的 PR 中推进命名指标、脚本评测结果和状态保存,重点是让缺失、失败和真实的低分能够被区分,而不是在汇总时混成同一种结果。
实验注记 · 当前阶段
这个实现仍在审查,部分超时和执行状态的处理还需要继续核对。
链接:skill-up PR #347
095. ADK(Google):补充流式遥测测试项目背景
Google ADK 的一项问题讨论涉及流式响应:如果系统同时记录了逐段输出和最终完整输出,遥测记录可能重复。
我具体做了什么
我与原贡献者协调后,向其开发分支提交了补充测试,覆盖流中断时的错误传播与部分消息保留,以及最终结果只记录一次的情况。针对改动文件的测试通过; 这是补充测试,不是由我提交生产修复。
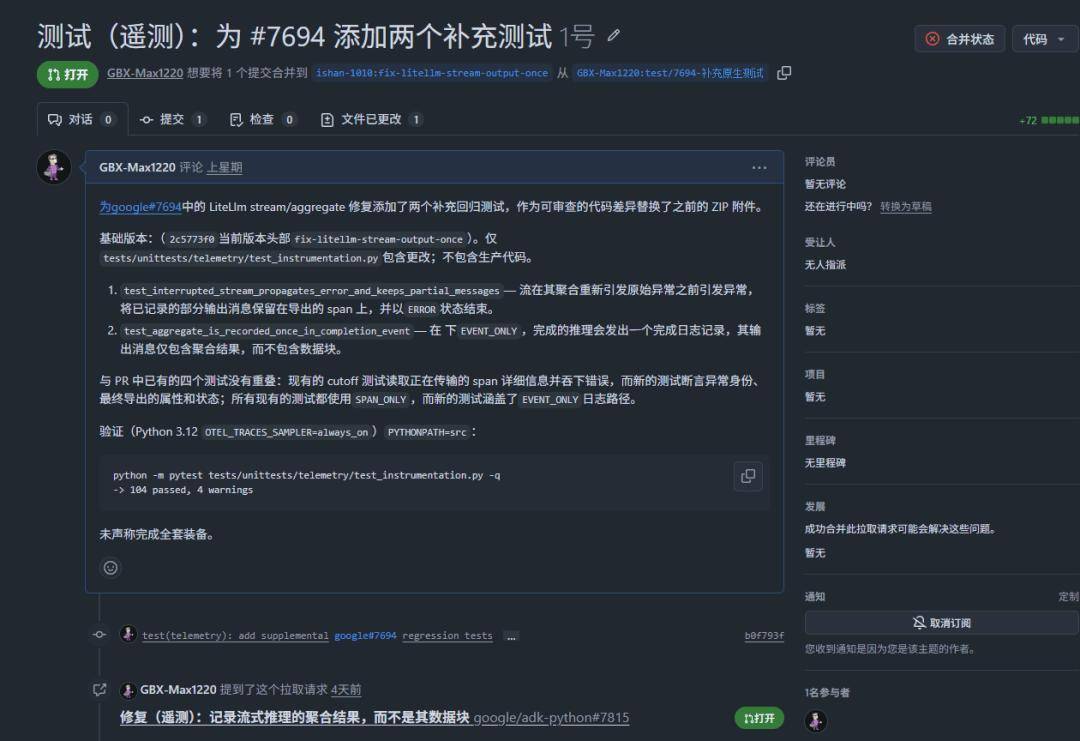
链接:问题讨论 · 测试 PR
106. 其他问题定位与公开讨论
除上面的 PR 外,我也持续跟进以下公开技术问题;其中一些讨论开始于更早的时间:
在 PydanticAI(Pydantic) 中讨论不同 Google 接口之间的签名回放边界;后续修复由维护者提交。
在 Alibaba-NLP/qqr(阿里巴巴/Alibaba-NLP) 中报告解析异常可能影响校准检查的问题;维护者确认了相关代码缺陷。
在 Scope(微软) 中讨论如何区分智能体运行波动与评测器自身的评分波动。
在 SaliMory(Meta/Facebook Research) 中提出:缺失标签不应被自动当成明确的负标签。
在 Agent-ECC(亚马逊/Amazon Science) 中提出一个研究问题:证据不完整时,如果某些任务更容易被排除,是否会改变最终可用训练信号的分布?
贡献类型
这些工作分别属于问题定位、讨论或研究提案,不能一概算作已经合并的代码。
另外,还在 NeMo Gym 的配对评测(NVIDIA)、NeMo Relay 的轨迹归因(NVIDIA)、Agent Learning 的动作级奖励(微软)、OpenEnv 的奖励防护(openenv)、ContrAgent 的历史回放(SponsioLabs)、HyperAgents 的后代准入(Meta/Facebook Research) 和 Agent Lightning 的策略遵循奖励(微软) 等问题中参与讨论。这些线程涉及的具体实现状态各不相同,不能把讨论当成已完成的代码贡献。
围绕“哪些证据值得用于更新”,我也在 Agent-Native Research Artifact(ARA-Labs)、AgenticBigBang(阿里巴巴) 和 UniOPSD(维护者 Zenghuang-Fu) 提出研究问题或参与方法讨论;在 teamai-cli(腾讯)、SkillOpt(微软)、SkillEvaluator(NVIDIA)、EGAgent(Meta/Facebook Research) 和 RL 语义规范(阿里巴巴) 的线程中讨论评测与反馈边界。这些都是公开问题和讨论,并非都形成了独立实验结果。
三、研究实验与工具
这一部分主要是离线分析与小规模预试。组件测试、合成结果和完整系统实验会分别说明。
111. WebWorld(通义千问/QwenLM):公开轨迹能回答哪些问题?项目背景
我具体做了什么
结果表明:现有记录适合开展一部分结构审计,但对于“同一任务和状态下,换一个动作会怎样”这个问题,可用的对照十分有限。因此我暂时停止把这批数据当作因果效果比较的依据。
这项工作没有运行真实模型,也没有得到下游任务表现提升的结论。
122. E-CommerceBench(通义千问/QwenLM):检查记忆操作的成本项目背景
E-CommerceBench(通义千问/QwenLM) 模拟智能体经营线上商店,并提供持久记忆工具。
我具体做了什么
我对官方记忆组件做了 CPU 测试,检查增删改查和容量限制,也确认一次记忆操作会推进模拟时间,错误操作同样有时间成本。这意味着未来比较不同记忆策略时,需要把调用次数和时间影响考虑进去。
实验注记 · 验证范围
目前完成的是组件级测试,完整经济环境尚未端到端运行。
133. Plan-RewardBench 与 TRACE(MSR-Orchard):奖励信号会不会受表面因素影响?
Plan-RewardBench 用计划偏好来评估奖励模型。我对公开偏好数据做离线检查,重点看计划长度、工具调用结构和编辑幅度可能带来的影响。现阶段结果提示这些因素值得进一步拆开,但不足以单独证明模型存在长度偏差。
TRACE(MSR-Orchard) 则涉及长轨迹中的步骤级奖励分配。我固定上游数学模块,用合成轨迹和不同强度的评分扰动检查步骤奖励与排序的敏感性;同时发现,简单把不确定的步骤奖励置零,在这组合成测试里反而增加了误差。
解释边界
两项工作目前都是离线分析,不能直接推断真实模型训练效果。
144. Mastra 与 Enterprise-Worlds:更新之后是否真的更好?
这两项预试都围绕同一个问题:系统获得新反馈后,更新记忆或行为到底有没有帮助?
Mastra 部分使用合成情境,比较正常信息和来源发生变化时的更新行为。Enterprise-Worlds 部分完成了任务划分、更新效用协议和本地测试。
它们目前都不是完整的真实 agent 对照实验;尤其 Enterprise-Worlds 的上游任务还没有实际回放,因此不能据此声称更新带来了因果收益。
155. DRACO(IBM)与 RLEC:检查归因和噪声校正
在 IBM DRACO(IBM) 的公开材料上,我做了固定判分条件下的引用增删敏感性检查,观察证据引用变化可能怎样影响步骤信用分配。
RLEC 则是一组 CPU 合成试验,检查整体层面的噪声校正能否掩盖特定子群仍然存在的问题。当前结果提示:总体指标改善,不代表每个子群都已经可靠。
这些都是受限条件下的分析,不能直接等同于真实模型的错误率或训练提升。
166. 记忆、摘要与证据绑定的预试
本周还推进了几类本地预试:
对长轨迹摘要进行小规模对照,检查不同模板是否会产生过长或重复的摘要;后续层级重建仍受运行环境限制。
对 MiniMax M3 证据绑定测试包做对抗检查,发现早期版本可能漏掉样本 ID 与内容对调的问题,随后补充了离线校验和回归测试。这是测试工具的离线检查,不能当成模型表现结论。
在 WhatFits(亚马逊/Amazon Science) 的公开代码上检查工作目录里的状态文件可能形成的额外反馈通道; 目前没有证据证明论文实验实际发生了信息泄露。
为 STATE-Bench(微软) 的历史交互数据准备候选召回与审计脚本,区分用户纠正、偏好和工具状态;总体效果仍需后续核验。
针对 PatientAgentBench(亚马逊/Amazon Science) 的评分解析逻辑,完成 CPU 小范围复现:当评委输出无法解析时,默认分数可能被当成通过。尚未证明这影响了公开榜单或模型排名。
为 ACES Evals 制作数据准入工具,用于检查评测文件与轨迹结构;真实数据尚未取得,分析仍未开始。
针对 Microsoft Scope 整理两份公开 readout 中的 55 次运行和 11 个配置,准备固定证据重复判分的后续研究。公开 readout 并非对同一份证据的重复评分,不能单独估计 judge 方差。
对 ExTS 的分数计算做公式级对照,检查全局分数范围变化是否可能改变节点排序;尚未完成完整上游搜索实验。
在已上线的离线评测实验室之外,补做策略选择稳健性分析,检查历史行动概率和奖励模型同时有误时,离线方法可能怎样选错策略。这是单步合成情境,不代表现实系统的出错比例。
为 Uni-Agent 准备本地适配器,验证工具调用与轨迹记录路径;真实模型推理和强化学习训练尚未验证。
做了一组小规模预测反馈预试,比较准确与误导性信息对点估计及区间的影响。样本只有 12 个情景,结果用于检查流程和提出后续问题,不足以证明某种反馈加权方法稳定有效。
对公开汇总数据做 verifier 排名稳定性复核,观察改变任务权重时不同方法的相对顺序是否变化;由于缺少逐题原始轨迹,这只能作为分布敏感性的探索。
项目背景
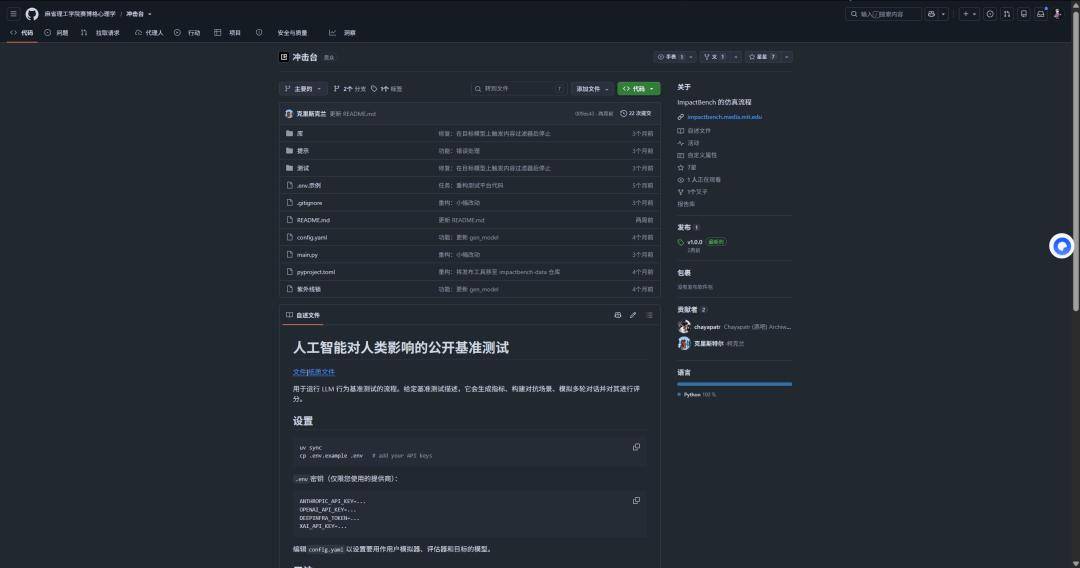
ImpactBench(mit-cyborgpsychology) 关注模型的心理与行为影响评测。我围绕三个具体问题制作了离线检查:JSON 中的字符串是否可能被错误转换为布尔值、换评测配置时缓存是否可能复用旧结果,以及缺失评分是否会改变模型比较。
我具体做了什么
本周交付了协议检查脚本、合成测试和排名分析工具。后者可以在取得合适数据后,区分明确的空值与缺失条目,并计算保守上下界。
数据尚未取得
真实逐样本评分数据没有取得,因此目前没有发现真实模型排名逆转,也不能报告实际缺失比例。这项工作完成的是分析工具与数据需求界定。
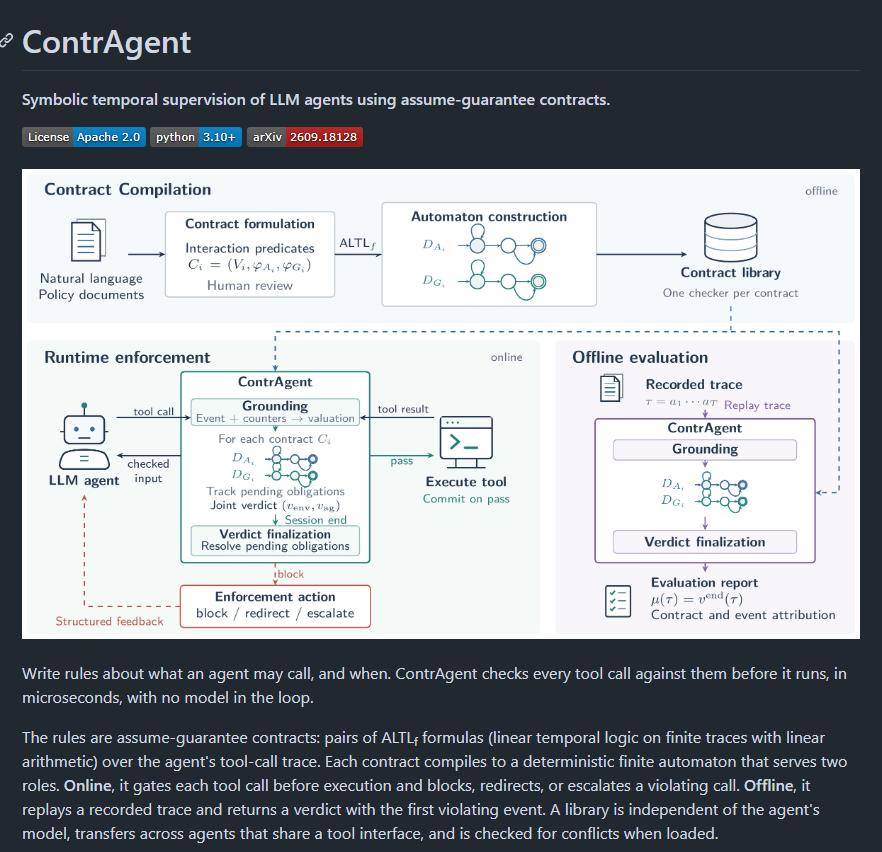
199. ContrAgent(SponsioLabs):规则改变后,怎样重放过去的决定项目背景
ContrAgent(SponsioLabs) 用规则约束智能体行为。我准备了一个合成记忆操作示例:同一段已记录行为,在旧规则和新规则下可能得到不同裁决。
我具体做了什么
示例用合成日志记录模拟的记忆写入和被拒绝的删除请求,帮助区分“日志记录了什么”与“按新规则会怎么判断”。交付包含示例配置、轨迹生成脚本和测试文件,没有调用真实模型或记忆服务。
规则遵循与内容可信
这个示例只检查规则执行;即使规则要求先调用验证工具,也不代表来源内容已经被证明可信。
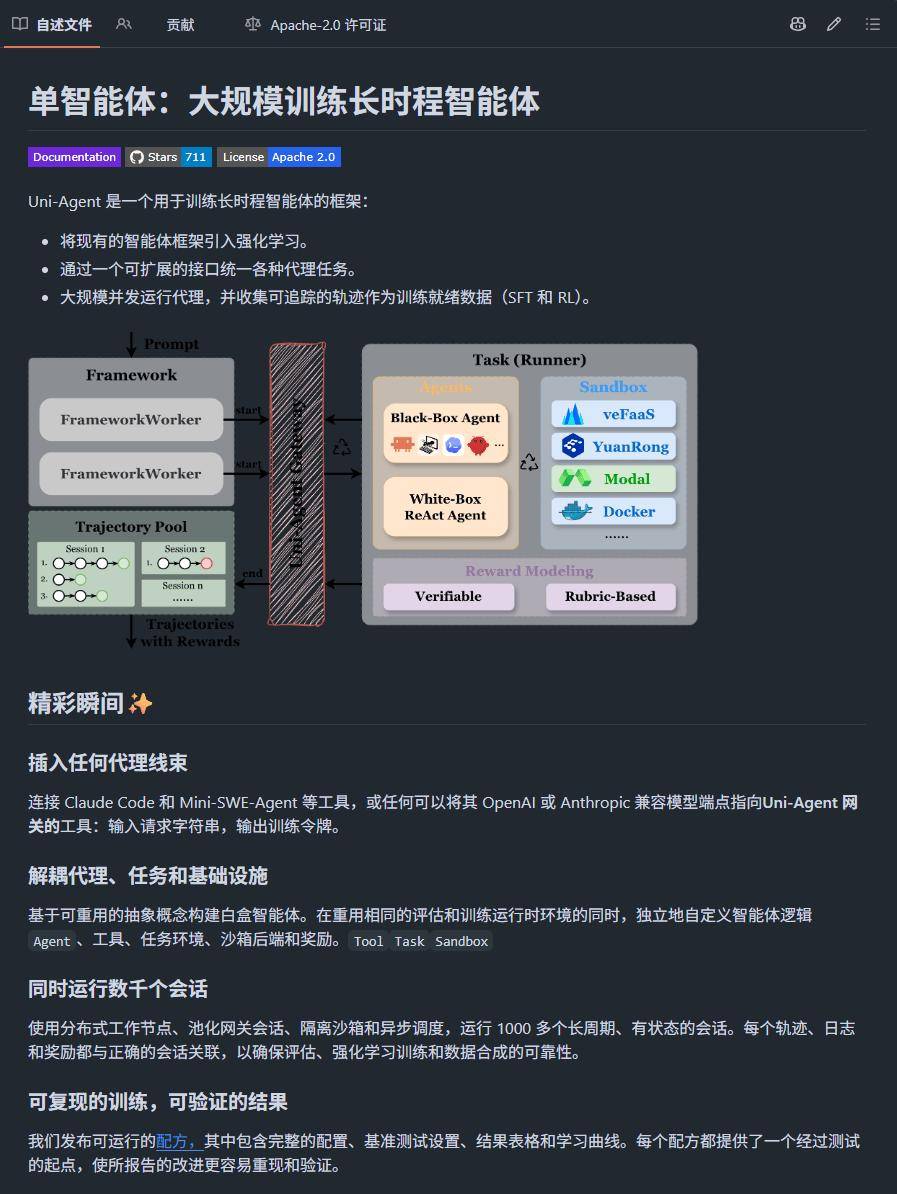
2010. Uni-Agent(verl-project):未完成轨迹与组内奖励归一化
除了本地适配器,我还按固定版本的 Uni-Agent(verl-project) 和 verl 代码路径,制作了 CPU 公式对照和日志审计工具。
我具体做了什么
对照检查的是:在特定数据路径下,未完成轨迹的奖励如果仍进入组内统计,会怎样改变其他样本的相对优势。日志工具要求明确的训练后处理分组、奖励和掩码记录,避免用轨迹文件名猜测实际训练分组。
实验注记 · 验证范围
目前是合成输入与工具级验证,没有真实训练日志,也没有实现生产补丁或证明训练效果改善。
2111. 其他合成对照与运行器准备
我还做了一个小型记忆核查成本对照:在 16 个人为构造的状态下,比较从不核查、选择性核查和每次都核查。它展示核查成本与错误损失之间的取舍,但结果完全依赖这组人为设定,不能当作真实系统的最优策略。
另一个固定输入的防御回放运行器完成了 mock 验证,覆盖调用记录、中断停止和响应处理;它没有接入真实服务,也没有开展付费模型实验。目前的交付是运行器准备,真实网络兼容性、费用限制和实验结论仍未验证。
四、本周小结
这一周的工作横跨网站、计算社会科学、开源工程和 AI 评测。它们的进展并不处在同一阶段:有的已经上线或合并,有的仍在等待审查,也有不少只是帮助我判断下一步该不该继续投入的预试。
对我来说,这些工作里反复出现的问题是:
提问
一条反馈从哪里来,它能支持什么判断,又是否足以改变系统之后的行为?
这个问题还没有一个现成答案,但它正在帮助我把工程、实验和长期研究逐渐连接起来。
MAX / WORKLOG
从公开页面到开源修复,再到评测预试:记录本周实际推进的工作。