Linux 创始人、长期担任首席维护者的 Linus Torvalds 借助 Anthropic 的 Claude Code 改内核。
10 月 13 日,他提交了一组 10 个补丁的合集。在他的 Ryzen Threadripper 上运行的合成基准测试中,这组补丁将吞吐量提升了 23 倍。但补丁还没正式合入主线,社区维护者就揪出了一个连 Linus 和 AI 都没发现的 Bug。
大神都有兜不住的Bug?这要从一个困扰了开发者们两年多的性能问题说起。
一、一个两年无解的内核瓶颈
2024 年,Oracle 工程师、资深 Linux 内核内存管理开发者 Matthew Wilcox 在处理客户工作负载时,发现了页缓存的 folio 引用计数争用问题,并标记下来。
根据 Hardware Busters 的测试数据,在 Linus 的 Core i7-8565U 笔记本上的 8 线程测试中,folio 引用计数争用占到了跨核 HITM 开销的 99.92%。
之前,为了解决页缓存引用计数的性能瓶颈,Linus 自己写过一版修复方案,断断续续用了 18 个月,但这个版本一直存在缺陷。其他开发者也尝试过不同的优化思路,同样没能彻底解决问题。
二、Linus 亲自承认用 AI 写内核代码
针对这个久攻未决的瓶颈,Linus 拿出了新的优化方案。令人震惊的是,该方案竟然是 Linus 借助 AI 完成的。
10 月 11日,Phoronix 的 Michael Larabel 发现,Linus 的内核代码树中出现了一个名为 noref-filemap-read-with-llm 的新分支。 熟悉 Linus 开发习惯的人都知道,他的代码树极少收录主线开发分支之外的内容。
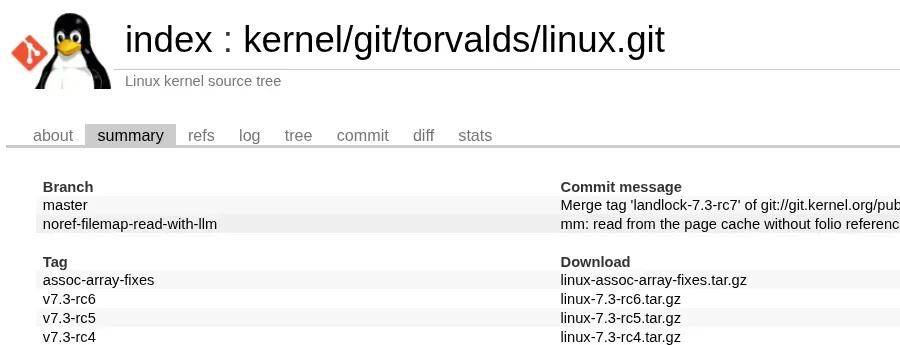
这个包含 8 个补丁的版本基于 Linux 7.3-rc6 开发,提交记录里清晰说明了 Claude Code 的具体分工。
在补丁信息中,Linus 确认了 AI 的参与:
“上述代码、测试程序、审查工作以及本文初稿都是在我的指导下,由一位 LLM 编码助理(Claude Code)完成的。基准测试都是在我的机器上运行的。”
这与 Linus 此前的公开立场形成了鲜明对比。他曾将 AI 描述为“90% 是营销”,也曾批评开发者“用 AI 写了 99% 的代码”。而现在,他不仅在内核之外用 Google 的 Antigravity 进行了一些虚拟编程, 还用 AI 辅助内核调试。
三、性能提升23倍,但也有代价
让业内意外的不只是 Linus 用上了 AI,更是他提交的这组补丁走了一条更大胆的技术路线。
早前有人尝试过的思路是:读取拷贝时不持有 folio 引用,读完再校验数据有效性,但该方案在内存回收、页替换场景下存在竞态条件。
而 13 日 Linus 推出的 10 补丁 rcu-free-v3 系列,是新增 PG_rcu_free 标志位,采用 RCU 延迟回收机制,只要用户态数据拷贝过程不触发缺页异常,就能在整个读取周期内安全访问 folio 结构。
根据 Threadripper 基准测试结果,两个版本的性能提升非常显著:
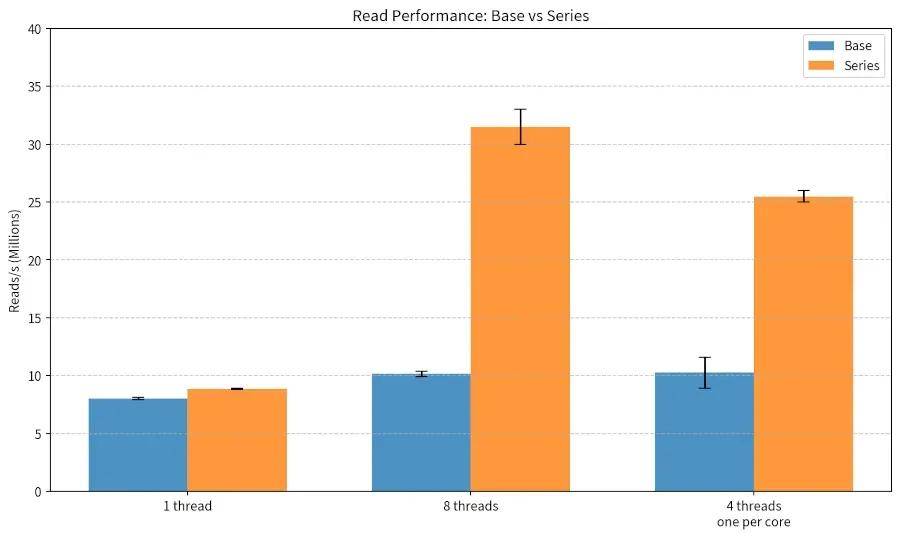
最初的 8 补丁版本在 Linus 的笔记本上就已经翻了近三倍的吞吐量:8 线程场景下,每秒读取次数从 1000 万提升至 3300 万,单次读取消耗的内核周期数从约 2950 降至 725。
而优化后的 10 补丁版本,在 64 线程 Threadripper 的高并发争用场景下提升更夸张:吞吐量从每秒 1330 万次读取跃升至 3.04 亿次,单次读取的内核周期数从近 2 万降至 735,也就是 23 倍的性能提升。
但 Linus 也明确提醒,在实际工作负载中,基准测试的性能涨幅会小很多。这是极端合成基准的结果,不代表 Linux 整体性能提升。
而性能提升也并非没有代价。
据 Hardware Busters 报道,在 8 补丁最初实现版本中,只要单个 CPU 的待回收页面队列超过 1024 个,延迟回收机制就会触发强制快速宽限期,加急完成页面回收。
此外,针对未映射的用户页读取操作,在回退到原有流程前会额外触发一次缺页异常,导致单线程下 16 字节读取的周期数从约 4150 攀升至 6550。
目前这一性能回退问题在 rcu-free-v3 版本中是否已修复,还没有明确结论。
四、维护者质疑,大神也有没兜住的Bug?
针对 Linus 的方案,最早发现该内核瓶颈的Matthew Wilcox 对新增的 PG_rcu_free 标志位提出异议,建议改用页面类型标识,同时配合在 RCU 宽限期后回收非活跃链表中的 folio。
Linus 否决了这两种思路。他认为,该标志位必须在 folio 仍可被映射到用户空间时就完成设置,而非活跃链表回收机制无法覆盖文件截断(truncate)和打洞(hole-punch)两类操作场景。
此前针对该瓶颈提交过优化方案的内核开发者 Kiryl Shutsemau 也参与了讨论。他提议将该标志位的使用限定在 64 位系统上,这一方案得到了 ARM 工程师、Linux 内存管理子系统维护者 David Hildenbrand 的支持。
真正关键的是,Shutsemau 还在 filemap_read_rcu_batch() 函数中发现了一处竞态条件:folio 替换完成后再扩展文件大小(i_size),可能会暴露从未实际写入的数据。Linus 建议提前读取文件大小,并合并 folio 校验逻辑,Shutsemau 已将该方案整合进了修订版补丁。
随后,Linus 将后续开发工作移交给了 Shutsemau。
10 月 19 日,Shutsemau 发布了一组补丁集。这套补丁基于之前 Linus 的代码思路改造实现,核心是修改 Linux 内核内存管理逻辑,做到不需要持有 folio 引用就可以完成页缓存读取。
他在补丁说明中解释了背后的原理:
“当多个 CPU 对同一个文件执行小块读取时,每个 CPU 都要对同一个 folio 做一次引用获取、一次引用释放,导致引用计数在多个 CPU 之间来回颠簸。该补丁集让 filemap_read() 函数以及共享内存(shmem)场景,都可以跳过引用获取步骤,直接从页缓存拷贝数据。这是对 Linus 原 RFC 方案的重构:读取进程正在拷贝的 folio 页,只会在 RCU 宽限期结束后才会被释放。”
他还在 EXT4、TMPFS、XFS 三种文件系统以及原始块设备上验证了这套优化的效果。测试基于 AMD Ryzen Threadripper 处理器,采用 64 线程并发,分别在开启和关闭默认 CPU 安全缓解机制的场景下完成。
测试结果相当亮眼:
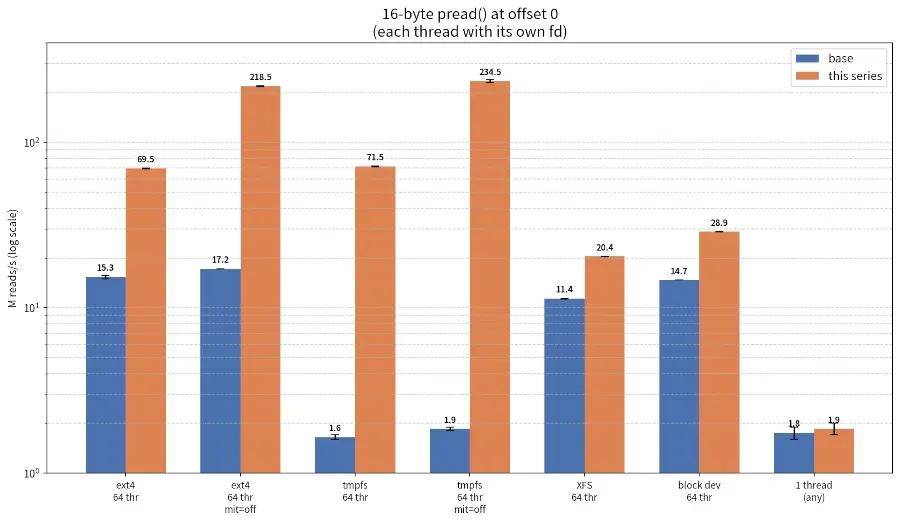
提升效果相当惊艳。这组补丁目前还处在 RFC 征求意见阶段,仍有部分设计细节没有最终落地,但这些问题预计很快就能解决,距离合入内核主线已经不远了。
五、结语
Linus 曾批评“AI 写了 99% 代码”的浮夸论调,而这次 AI 辅助开发、人类审查兜底的实践,恰恰给出了最明确的答案:AI 是提升开发效率的利器,但工具终究只是工具,人对代码质量的把控,始终是最后一道防线。
>>>>参考链接
- https://www.phoronix.com/news/Linus-Torvalds-Claude-Code
- https://thenewstack.io/torvalds-claude-code-kernel/
- https://www.phoronix.com/news/Reading-Page-Cache-WO-Folio-Ref
整理丨dbaplus社群
*仅为提供参考和学习交流,不代表dbaplus社群立场!dbaplus社群欢迎广大技术人员投稿,投稿邮箱:[email protected]