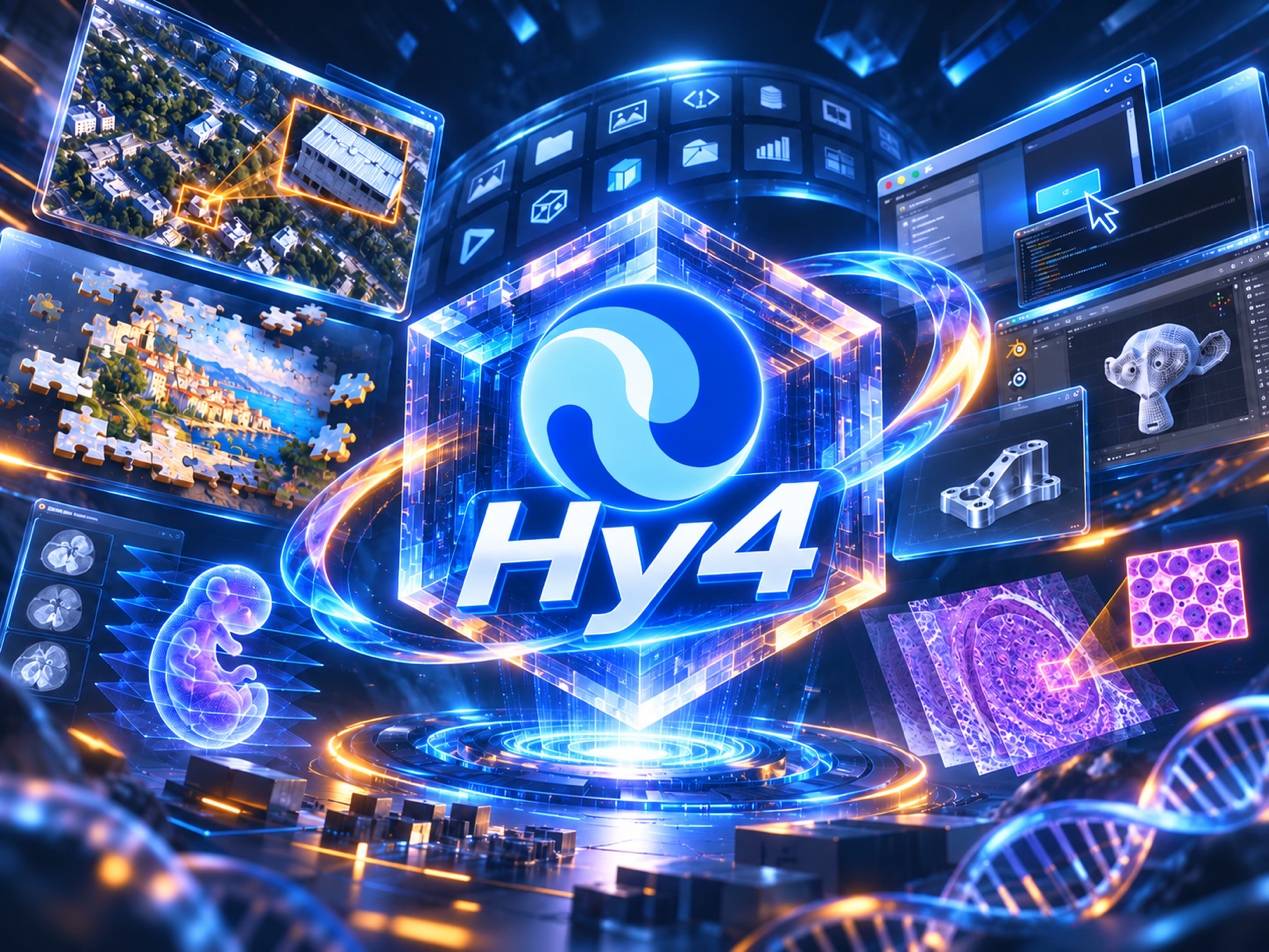
8月28日,“为真实生产力而生”第一次出现,那是 Hy4 的预览版。当时它像一个承诺。现在正式版上线,模型首次跻身最强开源模型之列。这个承诺是怎么落地的,我们按照能力、环境、案例、短板、自我研发、价格六件事拆开讲清楚。
01 视觉不是终点,看懂屏幕才是
很多人盯着这次的视觉理解能力。Hy4 首次引入视觉,可以结合感知、推理和工具调用,做细粒度图像处理和复杂图表分析。但看图不是终点——看不懂屏幕,就不知道下一步点哪儿。
它同时也首次支持电脑操作,而且不是二选一:命令行和图形界面可以灵活结合着用。图形界面加命令行一起用,模型才算真的坐上了工位。
而这次真正新的东西在训练侧:训练被塞进了 Blender、CAD 这类专业软件。这类软件的特点是,改一步、画面就变一截,得自己看懂了再决定下一步。官方的说法是,针对 Blender、CAD 等专业软件和跨应用长程任务开展了专项训练,持续优化专业任务的规划与执行力。
02 比能力清单更重要的,是训练环境
官方提到,混元与腾讯云 Agent Runtime 团队协同构建了沙箱环境,里面部署了数百款应用软件,让 Hy4 一遍遍操作、核对、错了退回来重做。Agent Runtime 本身也已对外开放。
这件事的意义容易被低估。这种活儿脚本写不出,刷榜也刷不到——脚本只能走预设路径,而真实软件里的弹窗、报错、状态变化是无穷的;榜单考的是一次性答对,长程任务考的是连续几十步不塌。
训练环境的规模,决定了模型见过多少种“不对劲”。
03 三个案例,挑最有说服力的讲
官方给的场景很多,这里只挑三个。
第一个是看。二十八亿像素的航拍图里,定位出一个两米宽的屋顶构件。难点不在识别,在于二十八亿像素没法整张塞进去,得先判断该往哪看,再放大确认。
第二个是拼。九百片拼图,拼回莫奈的《博尔迪盖拉》。拼图是典型的「局部都对、整体未必对」的任务,每一步都在考验它记不记得住全局。
第三个最狠。六百九十九万个细胞、八十四张乱序切片,做小鼠胚胎的三维重建;没有配准工具、没有标注,它自己把镜像翻转的问题纠了过来,一个半小时,没人插手。能跑流程不稀奇,脏数据里自己找补,这才是干活的样子。
04 幻觉率下降,生物实验自认“差距明显”
幻觉率官方给了两套数字,任务集不一样,这里不硬凑:
一套是自建测试里的幻觉率,从 15.76% 降到 5.45%;另一套是猜测导致的错误率,从 23.1% 降到 5.6%。两套口径不同,不取平均,也不合并讲。
但后一套里有一行值得单独说——靠猜下结论的错误,从 23.1% 降到了 5.6%。长任务里每一步都猜一点,整条链就塌了;降的是这个乘法的底数,不是某一道题的分数。
生物实验这项只拿了 30.4 分,满分一百,出自 Hy-BioExperimentBench。官方自己的判断是:开放式实验设计能力尚未达到高风险阈值,基础生物知识扎实,但把知识转化成可执行实验方案这一环仍然有限。原文写的是“差距明显”这一类表述,没有绕。
安全上,训练阶段只纳入了与 PoC 生成、漏洞修复相关的防守性数据,漏洞利用、逆向、渗透这些攻击性内容被剔除;后又请腾讯玄武和科恩实验室的专家,围绕密码分析、逆向工程、漏洞利用做了审计,结论是进攻性能力上未展现出突出风险。
另外官方文档也直说了:Hy4 虽是最强开源模型之一,与顶尖闭源模型仍有较大差距,尤其在前沿数学、长程开发、模型迭代、视觉问答这些高难测试集上。不藏上限,也不把克制当谦虚。
05 协同研发:它开始帮着造模型了
这是这次发布里最容易被略过、但其实很有价值的一条。
结合 Hyra 2.0 脚手架,Hy4 优化了内部同架构小模型的预训练基础设施,自动定位到训练里的卡点,把整体训练吞吐提了 20.1%;还自动训出了一个在多项评测上优于官方版本的 Jev 模型。
同时开源了两个由它协同研发的基础模型:单细胞表征的 HyCell,物理场的 HyPDE。这不是 demo,是扔给社区能直接用的工具。
数学上还有一件。交换代数方向的 Méndez–Pinto–Villarreal 猜想,反例是它找出来的;找到之后还提出了新的条件把猜想补完整,最后用 Lean 做了形式化验证——反例、修正、验证,三步是一溜干下来的。
所以这条的落点不是“答题更准“,而是“活儿能一溜干到底”。
06 价格没动,Hy4 flash近期上线
据了解,本次Hy4正式版,API 价格维持不变,按每百万 Token 计:输入 6 元,输出 18 元,缓存命中 0.3 元。
优惠这条要说准确:腾讯云 TokenHub 那边有为期一个月的五折,按刊例价计,截止 2026 年 12 月 31 日。是限时活动,不是长期价。
更轻更快的 Hy4 flash 官方说近期发布,主打性价比和推理速度。
一句提醒:网上流传的“12 项跑分 83.18 分、通过率 96.15%”出自 WorkBuddy 的办公场景评测,不是模型的综合分,别当通用成绩引用。金融那组众测数字同理,那是自家组织的评测,横向比较看看就好。
至于模型权重,官方说计划开源,并已联合 vLLM、SGLang 社区与 Inferact 提供生态支持,系统卡片也会随后发布。
07 结语: 八月那句话,现在有了形状
8月28日那句“为真实生产力而生”,当时是个定位;现在它有了形状:
更真的工位——图形界面和命令行一起用,专项训练进了 Blender、CAD;更诚实的上限——30.4 分照写,与闭源的差距照认,攻击性数据照剔;一条自己会往前走的链——找反例、补条件、验证明,顺手把训练吞吐提了 20.1%。
三维重建那八十四张切片里,它自己发现镜像翻转不对,退回去重来。训练这件事本身被升级的地方大概就在这儿:不是让它答得更像,是让它错了能自己退回来。