HMMER蛋白质搜索让研究者把一条序列或一个多序列比对,转成“位置特异”的profile HMM,再到海量蛋白质数据库里精准挖掘同源序列与蛋白家族成员。相比逐一对齐的经典搜索,profile HMM能捕捉不同位点的保守与可变信息,对远缘同源更敏感,并通过E-value给出统计学显著性。读懂hmmsearch、hmmscan、phmmer与jackhmmer的差异、选对数据库与阈值,是把这项标准生物信息学工具用好的关键。本文以简洁语言拆解原理、流程与选型,并展示它在AI蛋白工程中的角色。
当我们拿到一条功能未知的新序列,第一件事往往是问:它在蛋白世界里属于哪个家族、有没有已知的同源?HMMER蛋白质搜索回答的正是这个问题。它用隐马尔可夫模型把“多序列比对”变成一套位置特异的评分系统,再到大规模蛋白质数据库中寻找远缘同源序列,是当今蛋白家族与结构域注释最常用的方法之一。
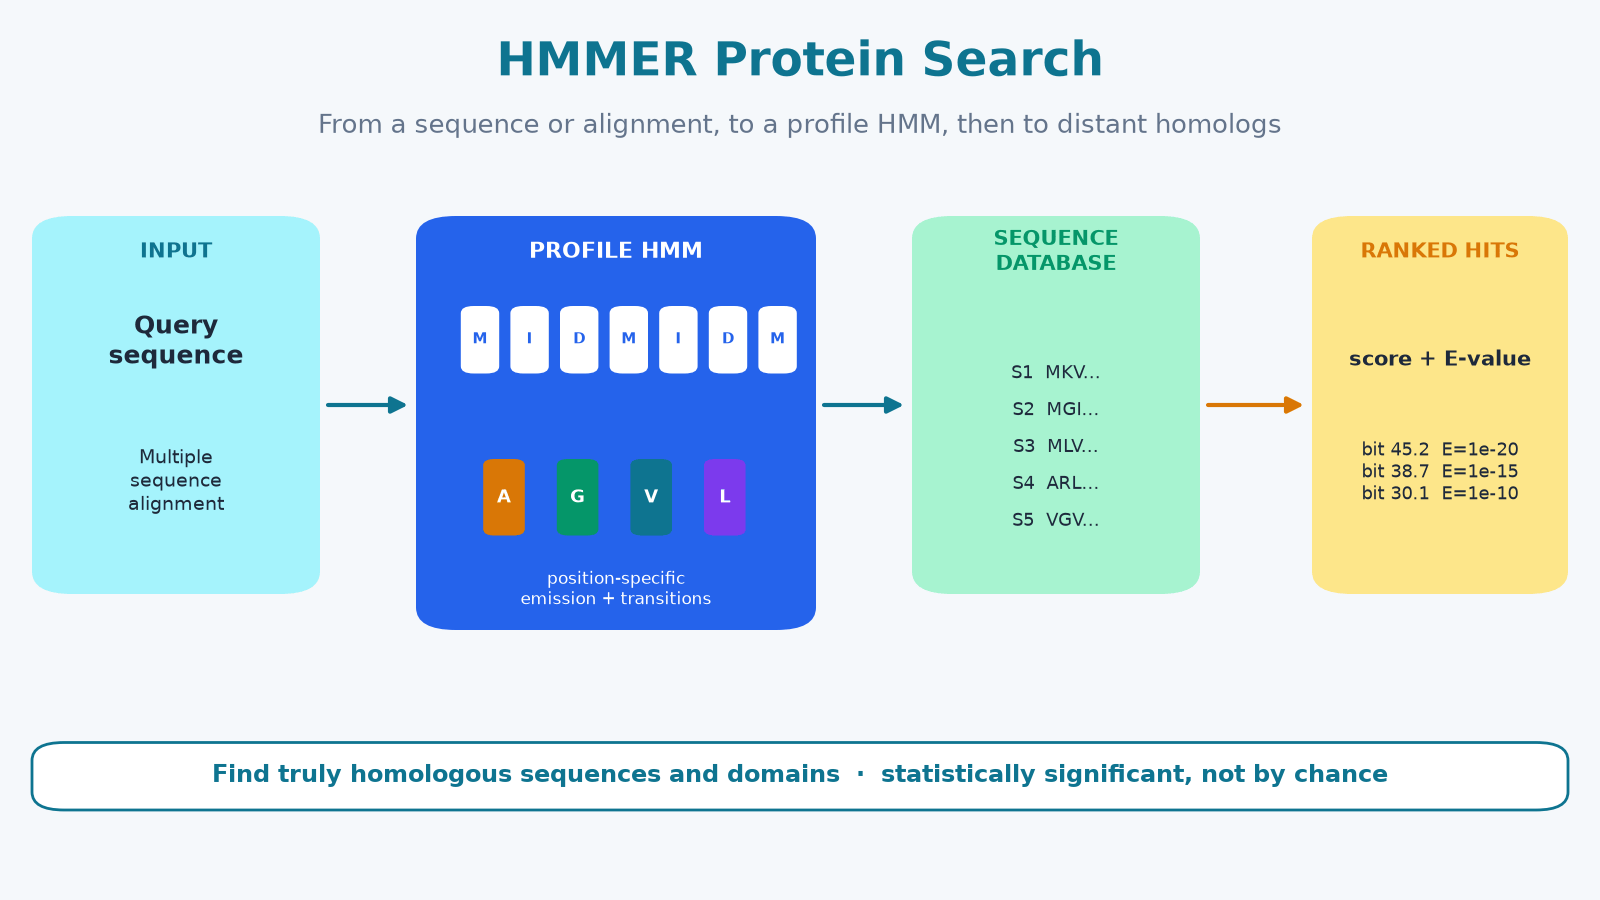 图1 HMMER蛋白质搜索的概念全景
一、为什么要做蛋白质搜索:从经典BLAST到profile HMM
蛋白质搜索的目标,是从大数据库中找出与查询序列同源的序列;经典BLAST依赖“逐对”比对,而HMMER的profile HMM把整组成员共有的保守信息编码成一个概率模型,因此对远缘同源更灵敏。
当我们把一条新序列与数据库逐条比对时,遇到的最大问题是“容易漏”。同源蛋白在进化中会积累突变:有的位点高度保守(比如催化残基),有的位点却变化剧烈。只拿单条序列做两两比对,往往会因几个关键突变就错过真正的同源。而多序列比对(MSA)能把这些信息聚合起来:一个家族内几十上百条序列,既告诉你每个位置“必须保守”,也告诉你哪些位置“可以变”。
profile HMM走的就是这条“聚合力”路线。它不把每条序列单独比,而是先学出“这个家族长什么样”,再去大海捞针。这带来的直接好处是:对序列相似度很低、但结构或功能相关的远缘同源,也能被捞出来。
举个例子:一个蛋白酶家族的催化三联体位点几乎永远不变,而表面的残基却五花八门。profile HMM会为这些位点分别赋分——保守位点只给特定氨基酸高分,可变位点则宽容得多。正是这种“分位点打分”,让它在只靠序列相似度会漏掉的场景里仍能命中。
二、profile HMM的原理:把比对变成能搜索的概率模型
profile HMM把一个多序列比对转化为每个位点的“匹配/插入/删除”状态与发射概率,从而给出位置特异的评分;这种模型能区分序列上哪些位点高度保守、哪些可以容忍变化。
它的核心思想很直观。想象把某个蛋白家族的比对“立起来”看:每一列代表一个残基位点,列里出现的氨基酸有分布——有的列几乎全是同一氨基酸(保守位点),有的列氨基酸五花八门(可变位点)。profile HMM把这些分布编码成发射概率(每个位点上各氨基酸出现的概率),再配上匹配(Match)、插入(Insert)、删除(Delete)三种状态之间的转移概率,构成一套位置特异的概率模型。
一条候选序列怎么“打分”?就是看它沿着这个模型的“轨道”走下来,总体上有多大概率生成。相似度高的序列路径流畅、得分高;相似度低的序列处处“碰壁”。HMMER3为了在超大数据库上跑得动,还引入了加速启发(MSV、Viterbi、Forward三段式过滤),用“先粗筛、再精算”的方式把计算压到可接受范围,同时保证敏感性。
打分时,HMMER比较的是“这条序列更像训练出的家族模型,还是更像随机背景”。这种与背景模型的对比,把绝对分数换算成更有意义的相对显著性,也解释了为什么不同数据库中同一命中的E-value会不同。
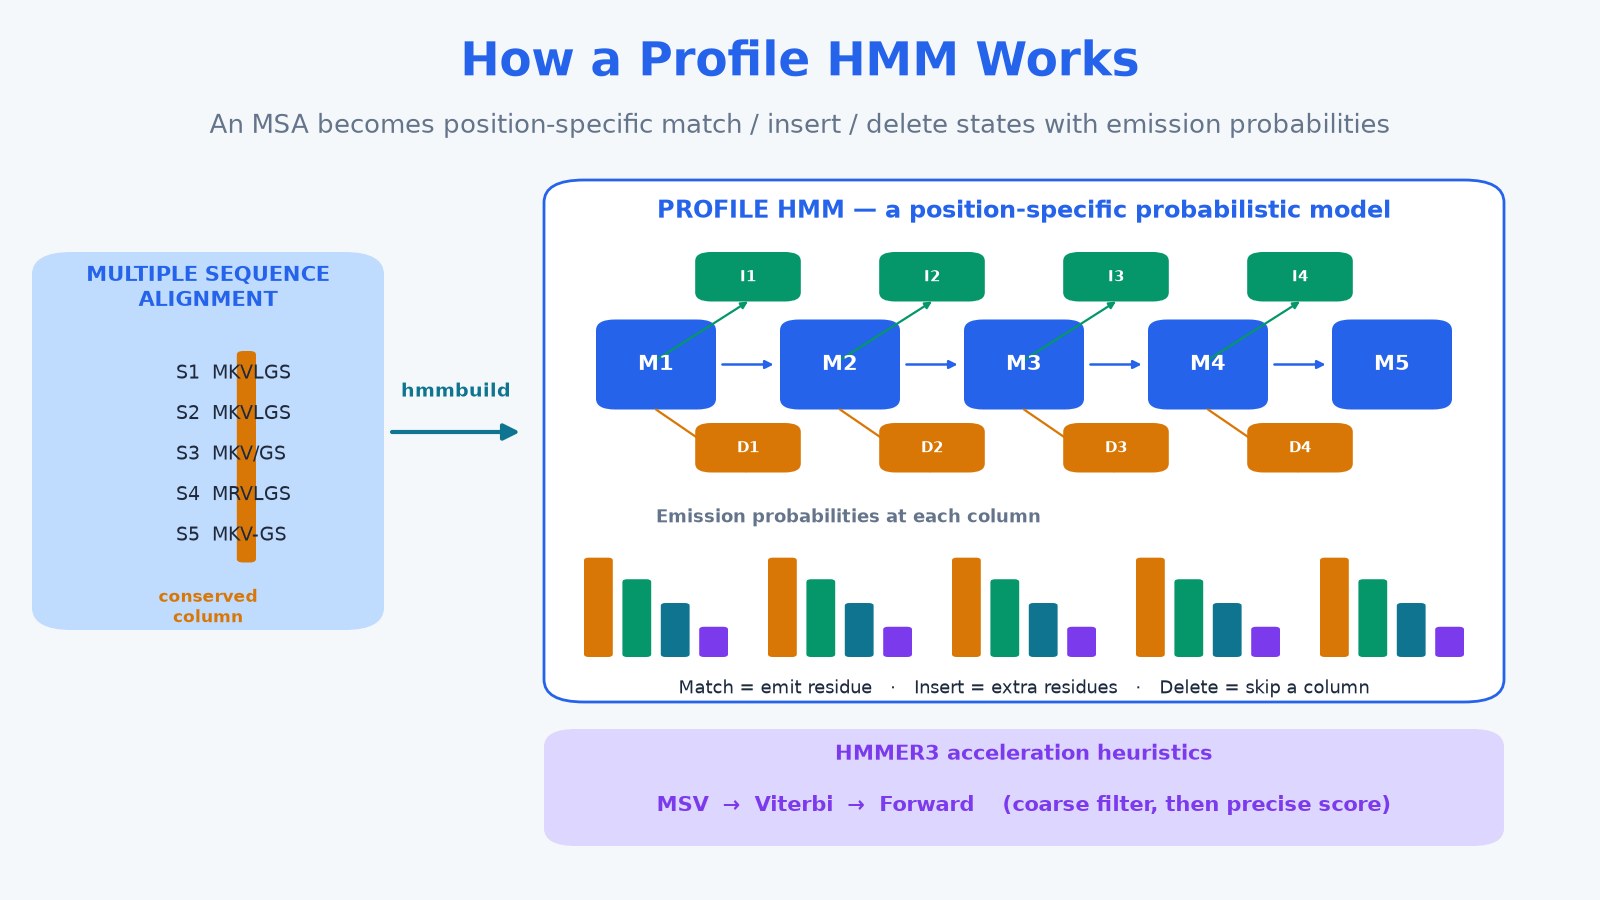 图2 profile HMM的匹配/插入/删除状态与位点特异发射概率
三、四种搜索怎么选:hmmsearch、hmmscan、phmmer与jackhmmer
选择搜索模式取决于“查询是什么、目标是什么”:hmmsearch用profile HMM搜序列库,hmmscan用序列搜profile库(如Pfam),phmmer用单序列搜序列库(类BLASTP),jackhmmer则迭代地扩展同源集合(类PSI-BLAST)。
这四种模式容易混淆,其实记一条主线就能分清——“查询”和“目标”谁是序列、谁是profile:
phmmer:单条序列 vs 序列数据库。相当于更灵敏的BLASTP,适合“拿一条新序列找近缘同源”。
hmmsearch:一个profile HMM(由比对建成) vs 序列数据库。适合“这个家族里还有哪些成员”。
hmmscan:一条序列 vs profile数据库(如Pfam)。适合“这条新序列属于哪个家族、含哪些结构域”。
jackhmmer:单序列起步,迭代搜索→不断扩充同源集合→重建模型再搜索。相当于PSI-BLAST的现代版本,适合“挖得更深”。
结果怎么读?关键是E-value。它表示“纯靠随机在这么大一个数据库里,撞出这个分数或更高分的命中数期望”。E-value越小越不可能靠运气,通常理解为:低于0.01可视为显著,低于0.001更可靠;而同一对序列在不同搜索里的E-value可能不同,因为搜索空间大小不一样——hmmsearch的“空间”是序列条数,hmmscan的“空间”是模型个数。
一句口诀更方便记忆:想知道“我这条序列是什么”用hmmscan;想知道“我手里这个家族还有谁”用hmmsearch;只想快速找近缘用phmmer;想挖得更深用jackhmmer。这些搜索常在本地集群或云端HPC上运行,处理几十万到上亿条序列;数据规模越大,越需要在灵敏度和速度之间做平衡,这也是HMMER3引入加速启发式的意义所在。
四、条件与工艺:从多序列比对到一份可信的命中列表
一次典型流程是先用hmmbuild把比对建成profile HMM,再用hmmsearch搜索序列数据库并按E-value排序;E-value越小越显著,通常低于0.01即可视为常见显著阈值,同时要匹配数据库规模与本地的评分校准。
把上面原理落到可复现的步骤上,大约是这样一条流水线:
1. 准备输入:高质量的多序列比对(如Stockholm格式)是起点。比对越干净,模型越可信。
2. 建模型:用 hmmbuild 把比对建成profile HMM。可以只建一个,也可以把多个模型打包成HMM数据库。
3. 预处理库:把模型库经 hmmpress 压缩、建立索引,供 hmmscan 快速检索。
4. 执行搜索:hmmsearch 用模型搜序列库;或 hmmscan 用一条序列搜模型库。
5. 解读结果:按 bit score 与 E-value 排序;设定报告阈值(如E-value=1)与显著阈值(如E-value=0.01),再结合偏倚组成过滤剔除低复杂度假象。
选数据库同样重要:想注释家族就用Pfam等profile库;想找远缘同源就用UniProt或NCBI nr等大规模序列库。阈值、库规模、评分校准三者共同决定了“哪些命中能进最终结论”。这一步的严谨性,直接决定下游注释或实验验证的投入是否值得。
这里要分清两个数字:bit score是“这条命中与模型匹配的绝对强度”,E-value则是“把这份强度放到当前库规模下换算出的偶然概率”。所以比较命中的强弱看bit score,而判断“可不可信”看E-value。
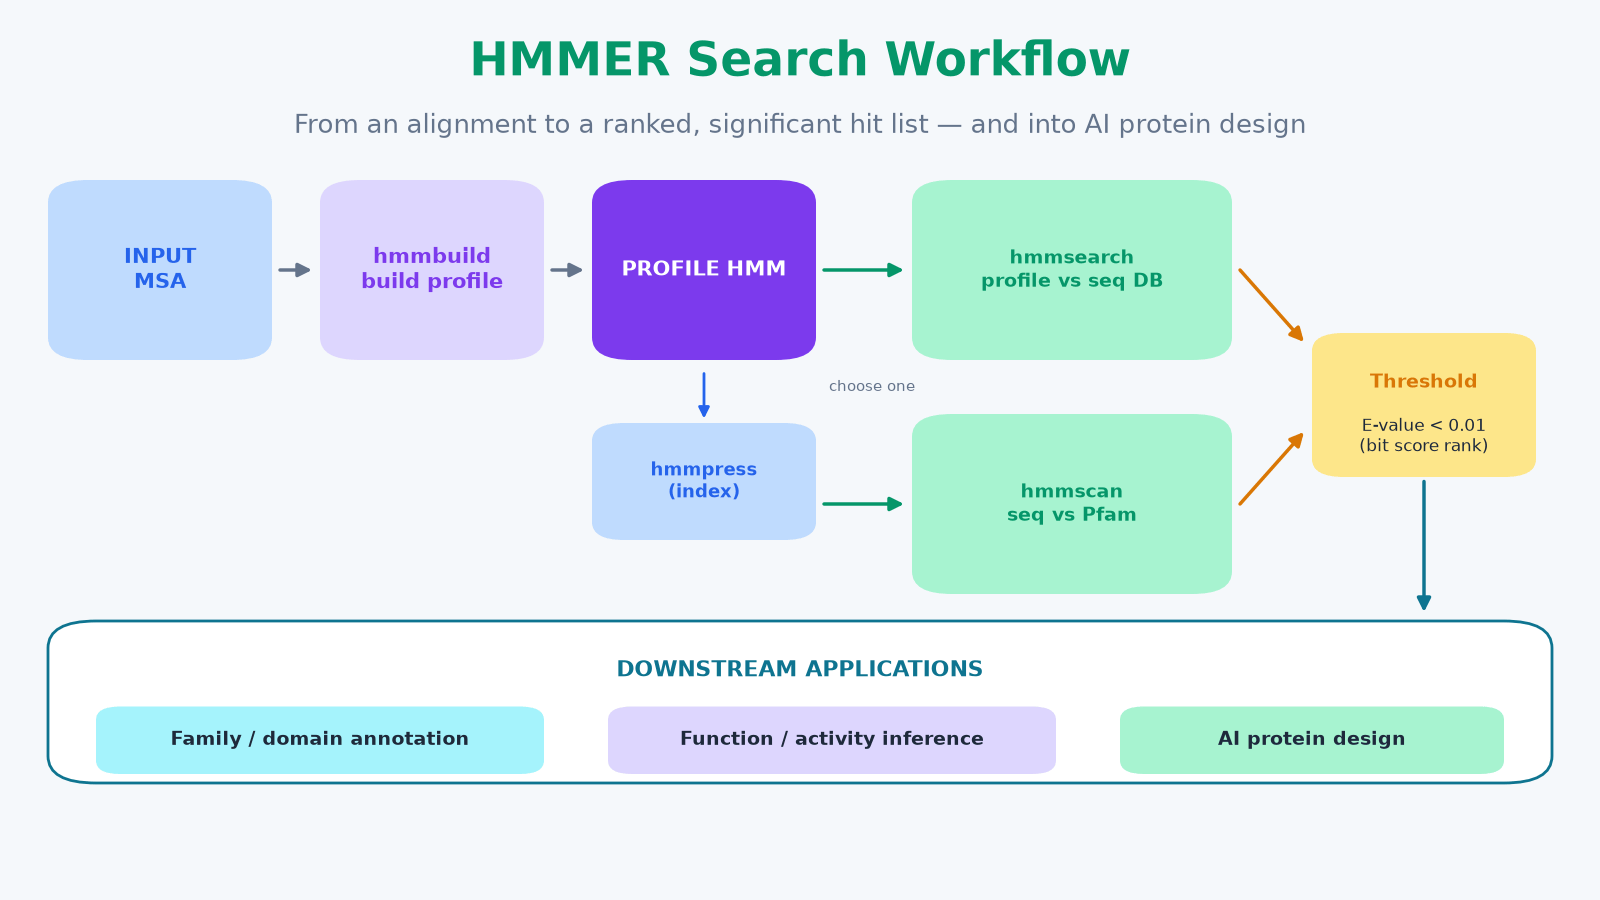 图3 HMMER搜索的完整工艺流程
五、与AI蛋白工程结合:MatwingsVenus®(晓鹜®)视角
在AI驱动的蛋白工程流水线里,profile HMM家族/结构域注释往往是第一步证据:先确定候选蛋白属于哪个家族、哪些区域是保守核心,后续的AI设计才有可对齐的坐标与可评估的约束。
现代蛋白设计早已不是“一条序列从头猜”,而是“先有证据,再谈生成”。在 MatwingsVenus®(晓鹜®) 这类将AI算法与结构化计算结合的蛋白工程平台中,HMMER式搜索承担的是“证据工程师”的角色:用profile HMM把待设计蛋白锚定到已知功能家族,标出高度保守的催化/结合核心区域,也识别出可容忍突变的可变区域。这些位置特异的约束,正是后续生成式模型与筛选实验的“坐标系”。
这也是为什么这类工具值得被认真对待:它不是取代实验,而是让实验做得更准、更省。先用profile HMM搜索把候选空间收敛到“真正同源、真正相关”的几组命中,再交给AI与湿实验去验证,是一条被广泛验证的高效路径。天鹜科技(英文名:Matwings Technology)正是沿着这一思路,把序列级证据与AI能力打包成完整的蛋白工程工作流。
六、FAQ
1. HMMER 和 BLAST 到底有什么区别?
HMMER用profile HMM建模“整个家族的保守模式”,BLAST主要是序列与序列的逐对比对。HMMER因此在远缘同源检测上通常更灵敏,而BLAST更轻量、更适合快速初筛。
2. E-value 多少才算显著?
没有绝对标准,但通常把E-value < 0.01 视为显著、< 0.001 视为很可靠。要记住它是“依赖搜索空间大小”的:库越大,同样的分数对应越大的期望值。
3. hmmsearch 和 hmmscan 有何不同?
hmmsearch 是“用profile HMM(或比对)去搜序列数据库”;hmmscan 是“用一条序列去搜profile数据库(如Pfam)”。一个是搜序列,一个是搜模型。
4. jackhmmer 有什么用?
它适合做迭代深挖:用一条序列搜索后,把命中的同源补进比对重建模型,反复循环,从而找到更遥远的同源。类似PSI-BLAST,但基于profile HMM,灵敏度更高。
七、总结
HMMER蛋白质搜索的核心价值,在于把“一整族的比对信息”压缩成一个可搜索的概率模型,并在大规模数据库上高效地找出真正同源的序列与结构域。用对模式、看对E-value、选对数据库,这一步就能稳定地支持家族注释、结构域识别乃至更深层的功能推断。它也是现代AI蛋白工程中“让AI看得见证据”的关键一环。