大模型、多模态与AI Agent的持续扩张,正让算力系统的关注点从“算得快”延伸到“数据供得上”。亿铸科技公司简介所对应的,就是一家沿此思路布局的企业:以通用存算一体架构为技术主线,面向数据中心、云计算与大模型推理提供AI大算力芯片。作为国内首家基于通用存算一体架构的AI大算力芯片公司,亿铸科技2022年正式开启规模化运营布局,总部位于苏州,团队近300人,研发人员占比超80%。
一、公司画像:定位、团队与业务范围
1. 定位与主营业务。 亿铸科技主营业务主要围绕基于通用存算一体架构的AI大算力芯片展开。公司2022年正式运营,总部位于苏州,定位为国内首家基于通用存算一体架构的AI大算力芯片公司,在上海、杭州、成都、长沙设有子公司。
2. 团队与研发能力。 研发覆盖工艺与器件、架构设计、电路设计及软件生态全链条,工程团队核心成员平均拥有25年以上高端集成电路设计与量产经验。
3. 产品与生态。 已构建算力卡、工作站、一体机到推理集群的全栈产品矩阵,自研YICA平台兼容主流软件生态,支持算子一键生成与优化。
二、架构创新:把计算放进存储阵列
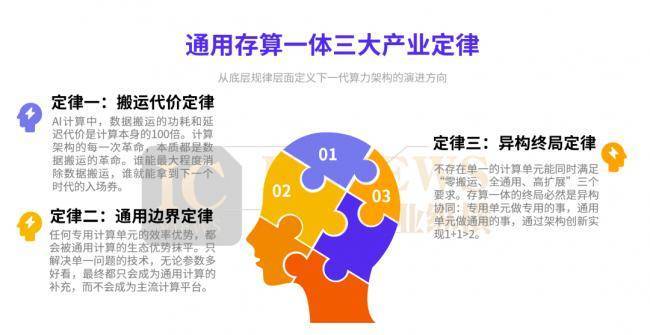
1. 存算分离的代价。 传统AI芯片以计算单元为中心,数据在多级缓存与内存之间反复搬运。熊大鹏的“搬运代价定律”认为,数据搬运的功耗与延迟代价可达计算本身的百倍量级。
2. 近存计算的边界。 3D堆叠、HBM缩短了存储与计算的物理距离、提升了带宽,是缓解存储墙的可行路径,但计算结构仍沿用传统形态。
3. 全数字通用存算一体的差异。存算一体本质是一类IP、覆盖类型相对聚焦,因此与通用SIMT单元组合:存算一体单元承担参数固定的矩阵与线性运算,通用单元处理激活函数、归一化、数据重排等不规则计算,在保留GPU编程模型的同时获得能效收益。
三、3D DRAM:通用存算一体的存储底座
存储介质的选择,直接决定芯片能装下多大的模型。在亿铸科技的技术路线里,3D DRAM承担的正是这个角色。
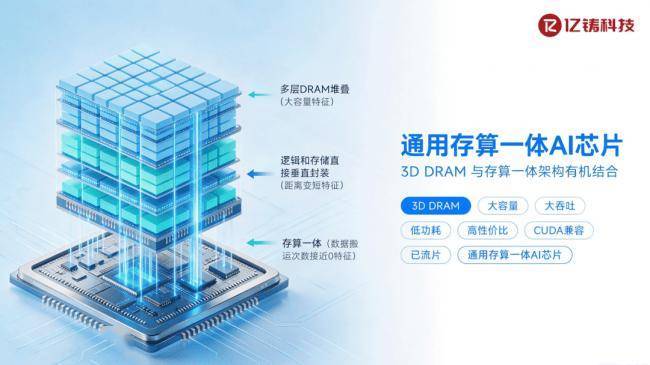
1. 产品定位。 3D DRAM是通用存算一体芯片的片上存储底座,直接决定单芯片可承载的参数规模与上下文长度,也是迈向GB级容量的物理基础。
2. 性能优势。 容量之外,堆叠结构同时拉高了带宽与吞吐,对Token逐字生成这类依赖数据供给的流程形成支撑;容量、稳定性与性价比的综合表现,是公司持续加码的原因。
3. 应用场景。 主要面向数据中心推理服务器、云计算算力池与长上下文大模型推理等对容量和带宽同时敏感的场景。
4. 当前进展。 基于3D DRAM的全数字通用存算一体AI芯片已完成从架构到硬件的全链路验证,第一代商用产品已推出,后续沿容量与带宽迭代,并向超节点、大端侧延伸。
四、能效与成本:来自第三方验证的数据
1. 能效表现。 经第三方验证,在典型大模型推理负载下,该方案相对主流云端GPU可呈现约10倍的能效比优势,功耗约为五分之一。
2. 综合成本。 同等业务规模下,推理算力综合TCO最高可下降约88%。
3. 场景适配。 面向Agentic AI负载,方案支持1M超长上下文、混合精度与MoE稀疏计算、集群级KV Cache池化,可降低检索延迟;落到Pre-fill与Decode,通用单元在预填充阶段更从容,存算一体单元在解码阶段优势更明显。
五、产业判断:三条定律与路线图
1. 搬运代价定律。 谁能更大程度减少数据搬运,谁就更接近下一个时代的入场位置。
2. 通用边界定律。 专用单元的能效优势容易被通用计算的生态规模抵消,兼容CUDA、PyTorch等主流软件栈是必选项。
3. 异构终局定律。 没有单一单元能同时满足零搬运、全通用、高扩展,终局是异构协同。
按这三条判断,未来两三年GPU与通用存算一体架构以协同为主,中期走向融合;这也是亿铸科技同步投入3D DRAM、自研ISA与软件生态的原因。
从近存计算走向存算一体,行业正在重新给“数据搬运”定价。亿铸科技公司简介所呈现的路径,是以3D DRAM解决容量、以全数字方案解决精度、以异构融合解决通用性,再把这套组合落到数据中心、云计算与大模型推理的真实负载上。这条路上仍有工程问题待解,但对希望压低推理成本、提升长上下文吞吐的用户而言,它值得持续观察。