我以前看万卡集群新闻,注意力常被“多少卡、多少算力”吸引。11月15日看完中科曙光万伟在中国超级算力大会的交流,反而觉得一条链路出故障之后怎么办,更能体现工程水平。
为什么一条链路值得重视
在大模型分布式训练中,计算节点要频繁交换参数和中间结果。集群越大,网络链路越多,故障、拥塞和异常端口出现的概率也随之增加。如果通信路径失效,部分计算设备可能不得不等待其他节点,甚至导致长时间运行的任务受到干扰。
、
 中科曙光在中国超级算力大会分享scaleFabric高速网络的链路恢复与大规模集群工程实践。
中科曙光公布了怎样的机制
据11月15日公司报道,scaleFabric高速网络采用多平面组网,支持毫秒级链路切换,并强调路由恢复耗时不会随着集群规模增加而持续拉长。这里指相关技术和工程设计能力,不代表任意故障下所有计算任务都完全没有损失。
怎么快速找到故障
配套的FabricView网络管理平台,可在任务开始前筛查异常节点,在运行过程中定位繁忙链路、异常端口等问题。和单纯换一台更高速率的交换机相比,提前发现风险、缩短排障时间,有时候对长期训练任务更重要。
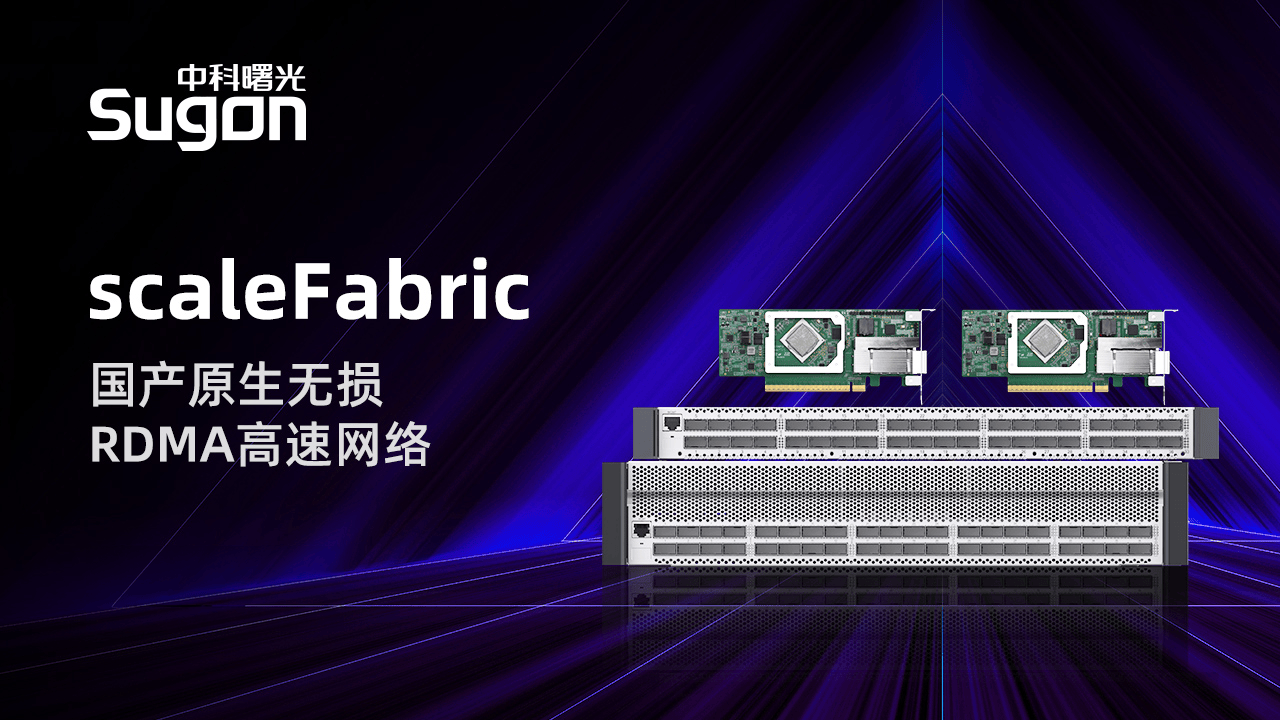 中科曙光scaleFabric支持毫秒级链路切换,FabricView可用于异常节点与网络端口定位。
从网络设备转向系统能力
万卡集群不仅需要高带宽,还要考虑通信框架、拓扑、存储和资源调度。公司披露的工程实践还涉及IBGDA及DeepEP框架适配。理解这些内容,能帮助投资者分清“理论互联规模”与“真实任务下稳定运行”之间的区别。