智猩猩AI整理
编辑:林夕
近日曝光的研发资料显示,智谱团队正在开展面向GLM-5.5的端到端编程后训练,内部32B、122B、256B模型经过后训练,正合并进下一代基座。
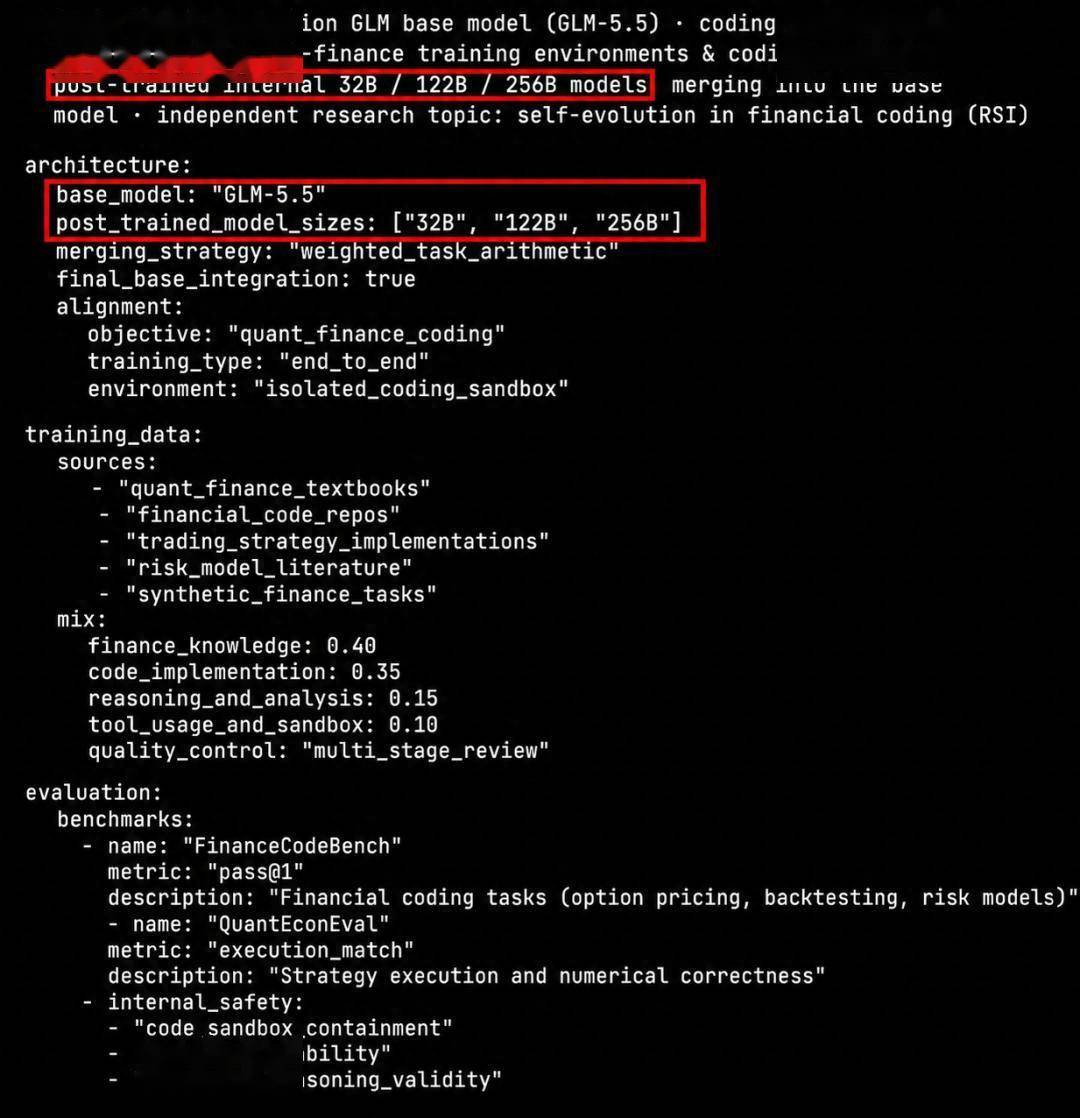
相关工作涉及量化金融训练环境、代码沙箱,以及金融编程领域的RSI。
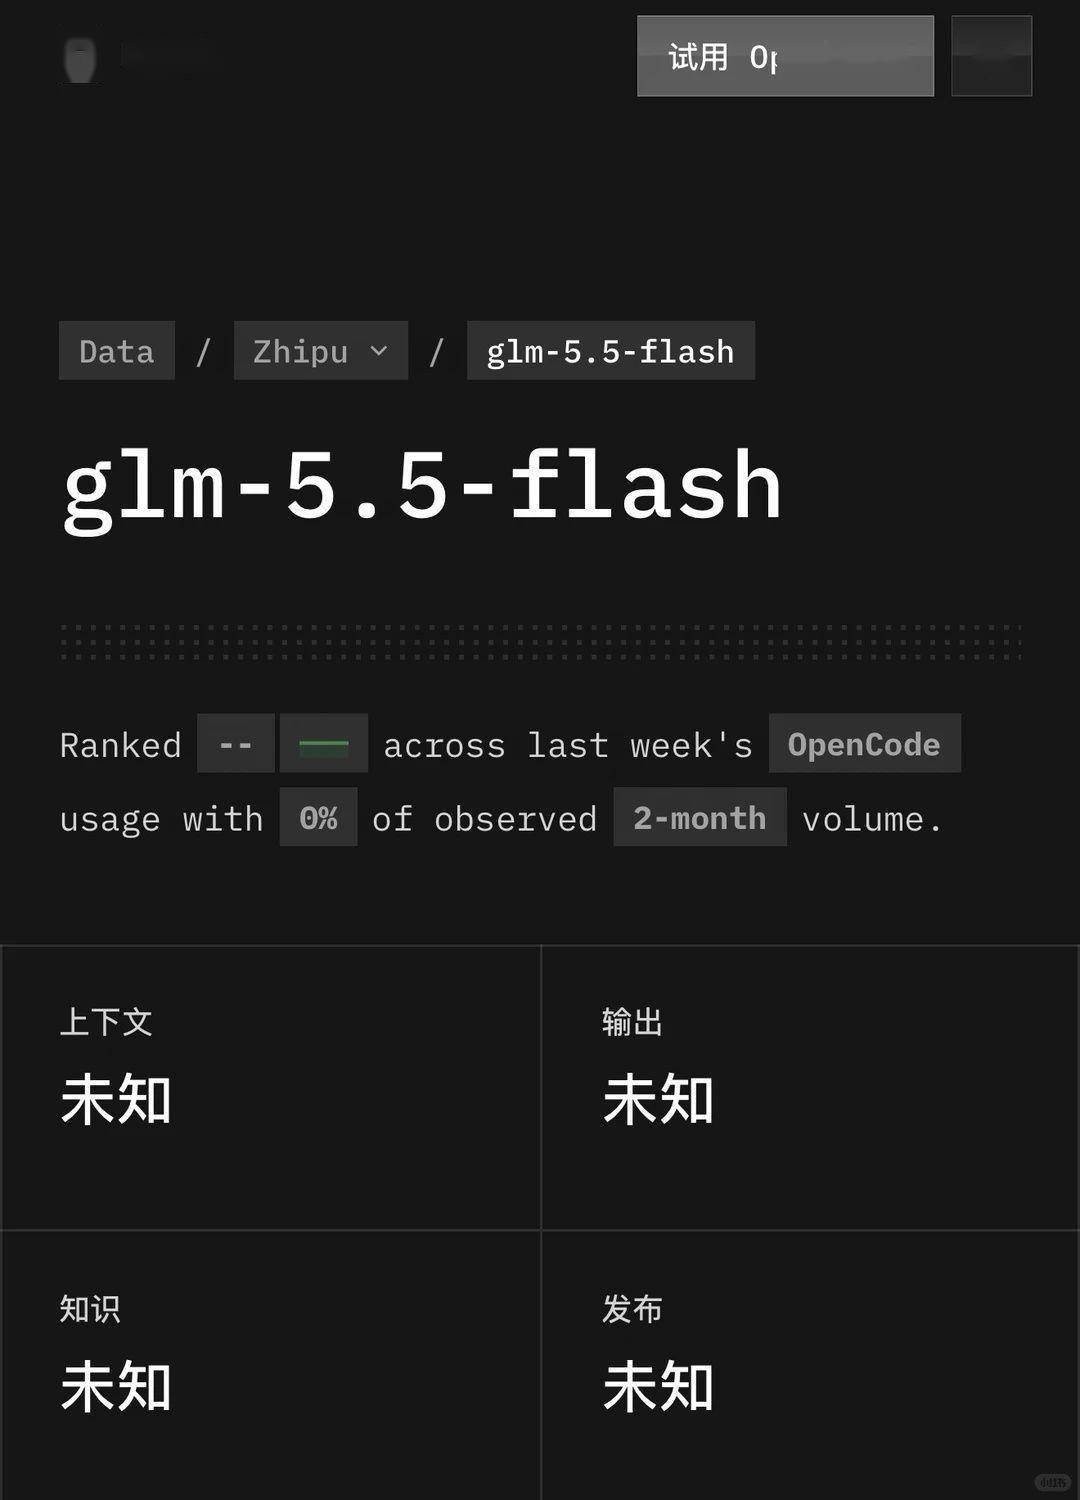
与此同时,OpenCode的数据页面中,也出现了名为 glm-5.5-flash的模型条目。
关于下一代模型,此前已有参数规模达3.5万亿的消息传出。
此次曝光的后训练记录,则进一步透露了GLM-5.5的具体研发进展。
此次线索来自一名智谱研究实习生此前公开的个人资料,其中直接提到“下一代基座模型GLM-5.5”,以及编程后训练、量化金融训练环境和代码沙箱等工作
11月2日,X上又有消息称,GLM-5.5后训练仍在推进,此前涉及32B、122B、256B内部模型的相关公开记录已被移除。
多个内部模型开展后训练,再向下一代基座汇集,成为这次曝光最值得关注的信息。
这种对后训练的重视,在此前GLM的迭代中已经体现。
我们曾报道,唐杰在解释GLM-5.3的升级思路时,强调在基座与架构不变的情况下,通过扩大任务环境和强化学习训练,继续挖掘模型潜力。
此次研发记录中,量化金融训练环境与Coding Sandbox的出现,则将训练进一步落到了具体任务场景。
智谱在编程方向上的投入也有迹可循。
早在2025年5月,面对DeepSeek R1带来的市场压力,智谱就调整了模型路线,将推理、编程和Agent能力融合训练。
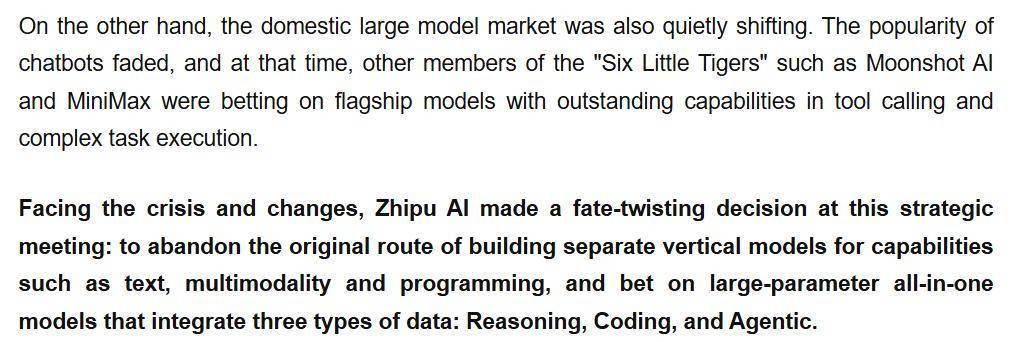
此后,编程逐步成为投入重点,相关强化学习环境与数据工程也获得更多资源。
我们此前在唐杰分享GLM通往AGI路线的报道中,也介绍过预训练、后训练与Agent继续Scaling的思路:
模型能力从代码生成向长程任务延伸,需要进一步提升规划、工具调用和错误恢复能力。
与GLM-5.5同时出现的金融编程自我进化研究,则让这次升级多了一层看点:
Agent执行任务时产生的经验,能否继续用于改进模型。
另一份流出的资料提到,以“100% RSI”为研究目标,先从Coding Agent开展闭环,再向医疗Agent扩展,同时探索让编程智能体生成自身训练数据。

团队此前已经在Agent自我改进上开展探索。
此前,唐杰团队提出的HarnessPro,已尝试让Agent回看执行记录、分析失败与浪费,再自动修改运行框架,在提升任务表现的同时,将单任务成本降低26.1%。
更早的工程实践,则是由GLM-5.3驱动Infra Agent,参与GLM-5.3-Flash推理基础设施的设计、调试与优化,让模型反过来改进承载自身运行的系统。
从优化运行系统、修改Agent框架,到探索生成自身训练数据,智谱在自我改进方向上的工作,正在覆盖更多研发环节。
但让模型持续迭代,还需要解决一个关键问题:它如何知道自己有没有变得更好?
10月31日,唐杰提出“规模化正确性”,主张系统检验小规模实验结论在扩大规模后是否继续成立,并通过不同规模下的曲线比较,提高对大规模训练表现的预测能力。
他将这种能力称为“自净化”。
这也延续了我们此前报道的GLM-6.0全自训练思路。
唐杰当时就将自主判断对错、决定何时停止与纠正错误,视为模型实现自主训练的核心难题。
自我改进之外,唐杰近期还透露了过往GLM的数据工程细节。
过往GLM数据覆盖网页、文档、书籍、代码、视频和音频,规模分别达1万亿页、20亿份、5000万本、5亿个仓库、100亿条及3亿小时。
不同来源分别涉及质量筛选、版面重排、代码执行测试与语音转写,唐杰同时将数据配方的重要性形容为预训练人员的“命”。
在数据规模上,唐杰还透露了下一阶段的目标:100T Token,约为GLM-5所用28.5T的3.5倍。
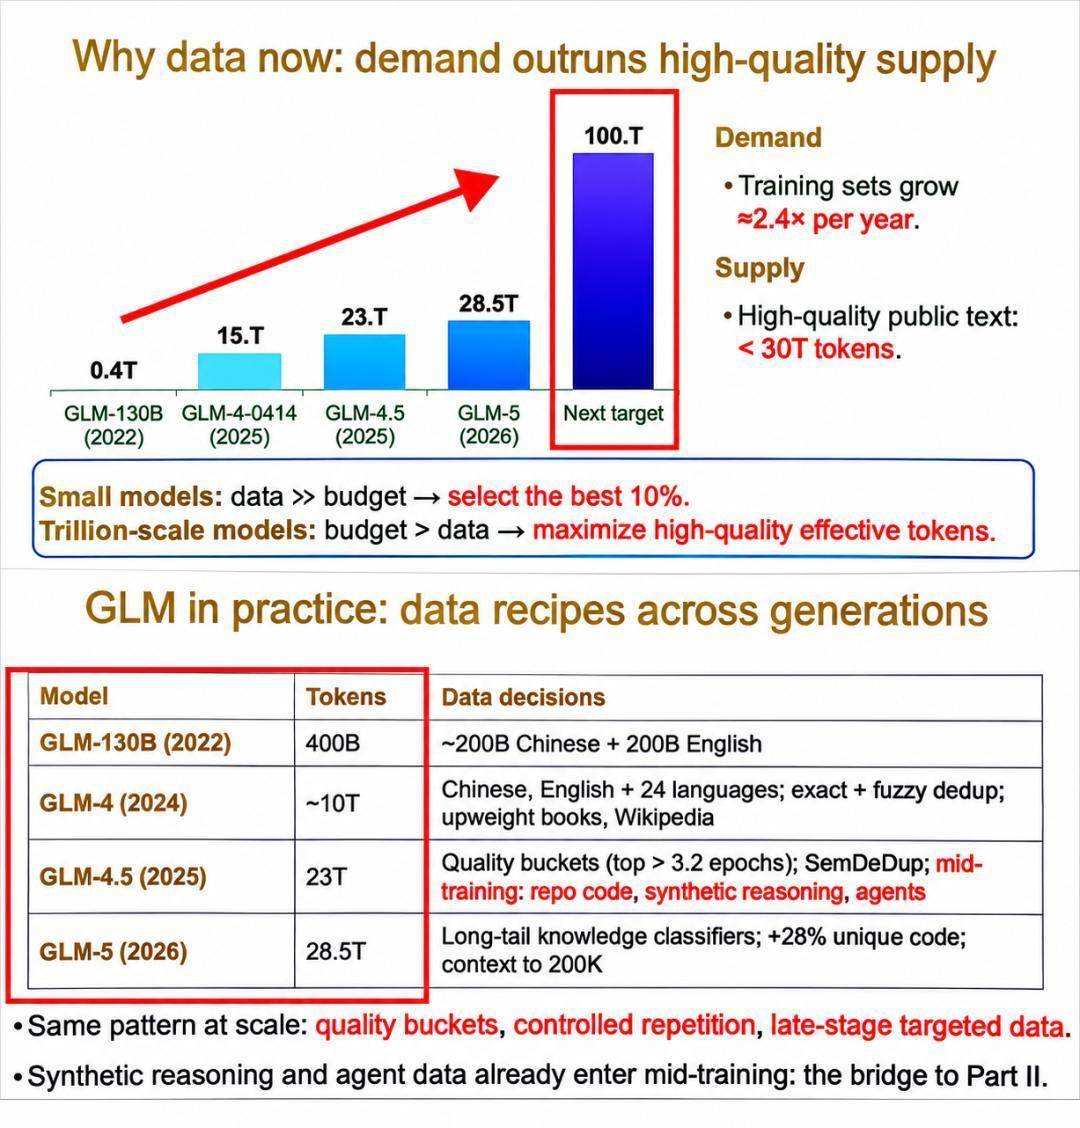
不过,材料同时指出,高质量公开文本供给不足30T Token,如何扩大有效数据规模,将成为后续训练的重要问题。
推理部署同样需要取舍。
唐杰透露,团队曾考虑每秒约1000 Token的超快版本,但在所述配置下,一台机器只能服务一个用户,成本很高,最终需要降低速度以换取更高并发。
多模态则是另一条已经出现的研究线索。
我们此前报道的GLM-Omni论文,研究了一个直观的问题:
模型通过图像生成学到的信息,为什么难以被文字问答调用?
团队尝试通过图文交错训练,以及先生成图片、再回答问题的视觉思维链,改善这种知识迁移。
GLM-Omni与GLM-5.5的版本对应关系尚未披露,但它说明,智谱也在探索视觉生成、知识访问与推理之间的连接。
此次内部三档模型的后训练与基座合并记录,则让下一代模型的研发轮廓更加具体。
从此前加码后训练,到如今编程环境、内部模型合并与自我进化研究接连曝光,GLM-5.5能否把这些积累转化为复杂编程和长程任务中的实际提升,将成为发布时的主要看点。