统一管理中心,四套系统的总入口
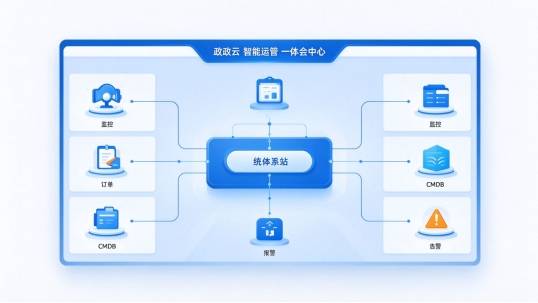
第一站是勤源的统一管理中心主界面。
它最大的价值,就是把四套产品全部打通,实现数据互传。
平台支持多租户、多用户管理,用户在做相关操作的时候,可以做到分权分域、多租户隔离。
也就是说,一朵云里几十个单位各用各的、各管各的,互不干扰。
OpManager:把全机房资源都采进来第二站,加载各类软件系统。
我们在这个平台上加载了OpManager,它可以对用户机房里的IT软硬件资源做数据采集,把用户关心的资源信息都采到平台上来。
不管是网络设备、服务器、交换机、存储、虚拟化资源,还是数据库、自建系统、标准服务,都能实现很好的数据采集。
从告警到趋势,资源状态一目了然采集上来之后,我们能在系统里通过不同方式查看当前资源的运营情况。
比如看一台交换机的使用情况:名称、IP地址、核心资源,使用过程中有没有产生告警,都能看到。
采集时还可以自定义采集指标项,给每个指标设定不同阈值。
点进交换机,能看到各个接口的情况,每个接口的使用情况都能分析——比如发送速率的历史信息,可以按需选择时间段,看指标项的最大值、最小值和平均值,掌握整体工作趋势。
工单系统:告警自动触发、台账自动沉淀第三站,流程工单系统。
它可以和OpManager的数据打通,把OpManager采集到的数据传到工单系统里,做两件事:第一,一旦产生告警,就能触发工单,自动实现工单流转;
第二,与工单系统自带的CMDB对接,把数据传送到CMDB,形成资产台账。
在这个台账里,可以根据需求做定制,比如通过流程对某个配置项进行变更和修改,和实际运维操作相匹配。
Q-Brain告警平台:事件收敛、AI根因分析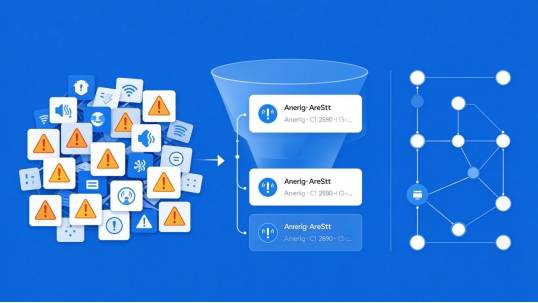
第四站,统一告警平台(Q-Brain)。
平台可以与不同数据源对接,先把OpManager接入,就能接收到它传来的各种告警信息。
在平台里,可以看到收到的告警内容,按严重程度、状态进行排列,也可以点开某条告警查看详细内容、了解它一共产生了多少次。
告警接入后,平台会自动做去重操作。
这里最关键的是“事件”的概念:平台把不同的告警信息产生为不同的事件,事件一旦产生,AI会自动生成事件摘要,也可以手动修改;
还能请AI智能体为事件内容给出解决方案、做根因分析。
服务拓扑:告警与业务链路自动关联在告警平台里,我们还能把零散的告警信息生成应用级事件,并生成服务拓扑,形成告警与服务拓扑之间的自动关联。
系统里可以定义服务拓扑,或者与CMDB对接,把CMDB中的拓扑自动导入,生成告警与拓扑之间的映射关系。
一旦产生告警,就能在拓扑上看到它发生在哪个节点、哪个服务、哪个应用;
同一应用里不同服务产生告警时,也能做区分。
关联规则:只把主要的告警推出来最后是关联规则。
平台可以基于链路、应用、服务,把有关联的告警关联起来。
举个例子:一台服务器上装的数据库宕了,产生的告警可能有服务器宕机告警、接口不通告警,还有其他延伸告警。
通过关联规则把它们建立成一个关联事件后,其中某一个告警产生时,只会报出数据库的主要告警,而不会把次要告警、延伸告警一起轰出来。
这一整套操作,都能在告警平台里实现。
一句话总结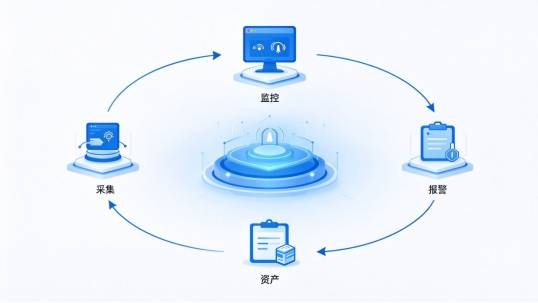
四套系统——统一管理中心、OpManager采集、流程工单+CMDB、Q-Brain告警——数据互通、环环相扣。
从资源采集、状态监控,到告警收敛、根因分析,再到工单闭环、责任追溯,运维的关键动作全部在系统里完成。
这就是我们说的:让每一条告警都有处可去,让每一次故障都有责可追。
(主播:黄瑞琪 · 勤源全链路智能运维)