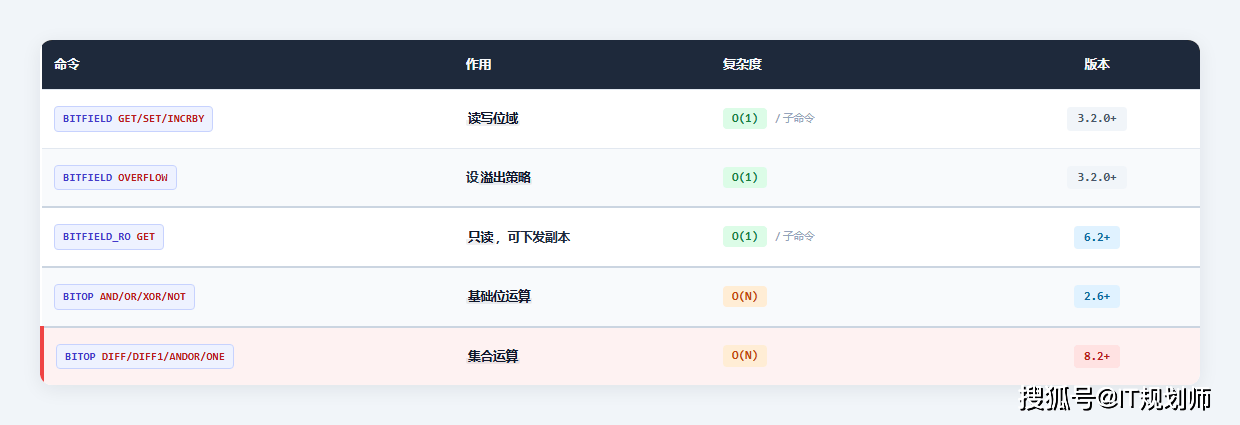
一句话:SETBIT 把 1 个比特当开关,BITFIELD 把连续 M 个比特当小整数——同一张 String,用几位干掉几个 key。 版本:BITFIELD 3.2.0+ · BITFIELD_RO 6.2+ · BITOP 基础 2.6+ · BITOP 新操作符 DIFF/DIFF1/ANDOR/ONE 8.2+(无 ANDNOT)。
三条最该先记住的结论:
① 溢出默认 WRAP 且完全静默,u8 255+1 变 0、i8 127+1 变 -128,必须显式 SAT/FAIL;
② BITFIELD 原子但非事务,FAIL 也不是"什么都没发生"(key 会被预扩展且不同步);
③ 收益来自消除 per-key 元数据(每合并一个 key 省约 77 B),代价是"布局即契约"。
适合谁读:写过 SETBIT 却没敢用 BITFIELD 的人;被"一个 key 一个计数器"撑爆内存、又被位域溢出坑过一次的人。前置:熟悉 String 命令、知道 SDS 与 redisObject,能在 redis-cli 和 .NET 之间来回验证。全篇 C# 代码基于 StackExchange.Redis 2.8.16,已用 dotnet build(net10.0)编译通过。一、位域定位与命令全集1.1 一个 String,两种视角
第 6 篇讲过:Redis 里没有 Bitmap 类型,它只是 String 的位视图。位域是同一件事的下半场:
- SETBIT 把第 N 个比特当一个开关;
- BITFIELD 把从第 N 位起连续 M 个比特当一个小整数。
两者共用同一张 String、同一套 SDS,只是视角不同。同一个 key 先 BITFIELD SET u8 0 200 写一个字节,再 GETBIT 看第 0 位,读的是同一段内存。
为什么需要下半场:SETBIT 只能存 0/1。真实业务常常要在一个对象上塞几十个小整数——8 个互动计数、32 个权限开关、一局游戏 6 个角色的血量。一个 bit 不够,一个 key 一个计数器又太浪费,因为key 自身的元数据远超数值本身。同样存 8 个计数器,8 个独立 key 约 1050 字节,一段位域约 145 字节。
三个现象说明了它的风险面:
- 数据错乱:u4 计数器到 15 后继续 INCRBY,不报错直接归零——默认 WRAP。
- 统计失真:一次 uid→offset 映射迁移后,新旧两张日活图直接 BITOP AND,交集全错——错在映射口径,不在 BITOP。
- 内存堆积:BITOP 产出的临时结果 key 忘设 EXPIRE,日积月累堆上万个。
三条主线由此而来:溢出策略、映射口径一致性、结果 key 的生命周期。
1.2 命令家族:BITFIELD 与 BITOP
BITFIELD 自 3.2.0 起可用,每个子命令 O(1)。一次调用可串联多个子命令,返回一个数组,元素与子命令顺序一一对应:
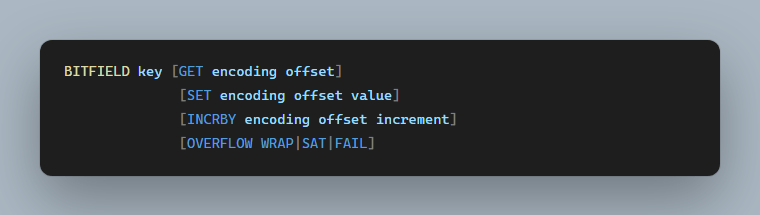


两个必须现在知道的边界:原子但非事务(子命令按序执行、不会被并发打断,但 FAIL 只跳过当前一条,前面成功的不回滚);先扩展后执行(即使全部写子命令被 FAIL 拒绝,字符串的预创建/预扩展也已发生,且不写 AOF、不传播副本,见 2.6)。
1.3 类型编码与位宽选择
类型 = 符号 + 位宽,i 有符号、u 无符号。
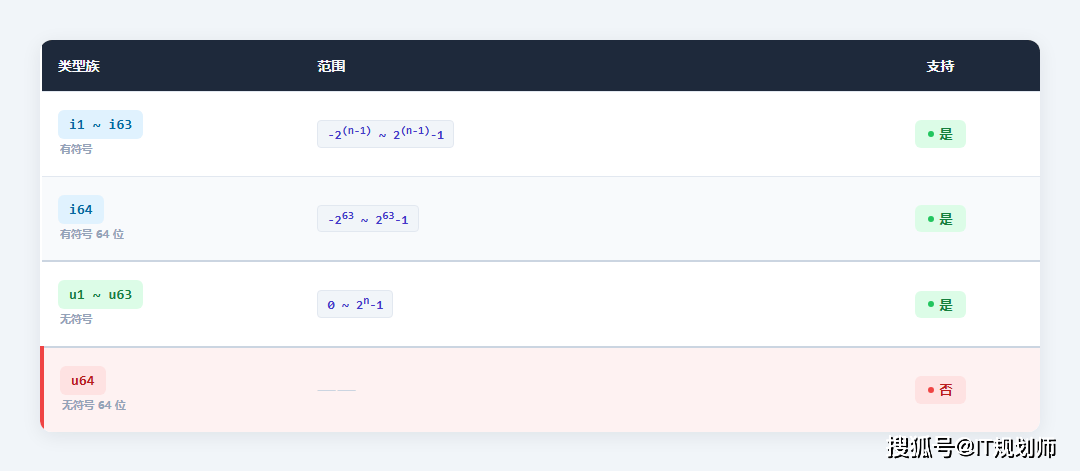
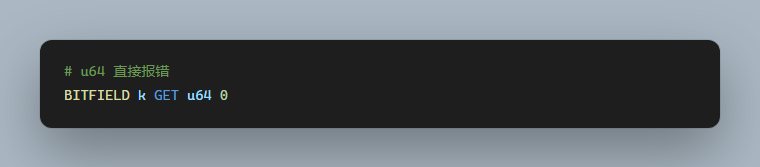
为什么 u64 不存在而 i64 存在:RESP 的整数是有符号 64 位。u63 的最大值 2^63-1 落在正数范围内,能正常返回;u64 的 2^64-1 超出这个容器。i64 正好塞得进去,所以支持。
常用位宽按业务上界选,上界拿不准才大一号,别为"整齐"超配:

记忆:无符号看"能到 2ⁿ-1",有符号看"正负各一半"——u4 到 15、i4 到 7。
两个常见反例:用 u4 存"连续签到天数",第 16 天静默归零;用 i4 存"评分"以为范围是 0~15,实际只到 7。位宽超配也有代价——8 个字段都多给 8 位,key 就从 32 字节涨到 64 字节,正好跨过一个 jemalloc 桶,"省内存"变成"多占一倍"。宽度选择的标准不是好看,而是"业务上界 + 一号余量"。
1.4 两种偏移与溢出语法

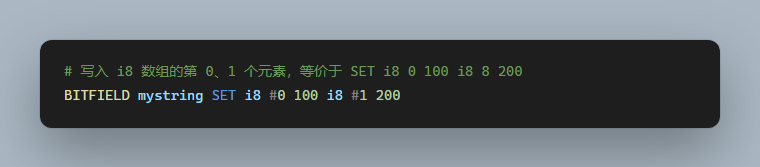
辟谣:网上说"纯数字是字节偏移、#n 才是位偏移"——错的,两者都是比特,#n 只是乘以位宽。把 SET u8 8 1 当成"从第 8 个字节写",结果差 8 倍且不报错。
# 的陷阱:乘数是当前子命令的编码宽度。同一个 #1,i8 下是 bit 8,i16 下是 bit 16。混用位宽时手写绝对偏移更安全。位域可以跨字节边界,但生产上建议按字节对齐,避免客户端 SDK 解析出错。
上例第二笔 200 超出 i8 上界 127,默认 WRAP 会静默回绕成 -56 写入(200−256),返回的 0 只是旧值。SET 的越界同样受 OVERFLOW 控制。OVERFLOW 只影响它之后、直到下一条 OVERFLOW 的 SET/INCRBY,对 GET 无效。
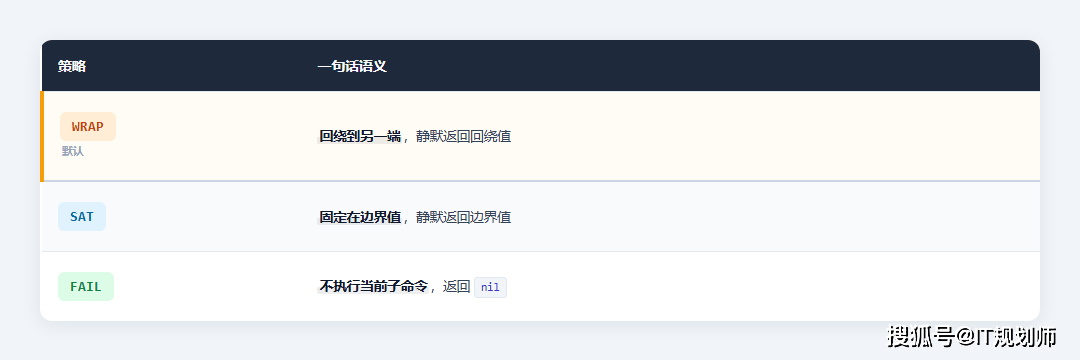
必须记住:服务器层面三种策略都不抛异常,默认 WRAP 静默回绕。要封顶或显式拒绝,必须手写 SAT/FAIL。
1.5 只读变体与 BITOP 8.2 新操作符
BITFIELD_RO(6.2+)与 BITFIELD 同源,但只接受 GET,任何 SET/INCRBY/OVERFLOW 都报错。存在的理由是:BITFIELD 整条命令带 write 标志,哪怕只含 GET,发到只读副本也会被 READONLY 拒绝。集群下 BITFIELD_RO 可路由到副本,BITFIELD 只能落主节点——统计类查询统一走 _RO。
BITOP op destkey key [key ...] 把多个位图按位运算写入 destkey,返回结果位图的字节长度。四个基础运算:AND(交集)、OR(并集)、XOR(对称差,不是"新增")、NOT(补集,只接受一个输入)。
三条边界:
- 长度取最长、短图尾部补 0,但不会算错。位图缺失的高位本来就是 0,补 0 补的正是真实内容,AND/OR/XOR/DIFF 在长度不一致时结果仍语义精确。长度差异真正影响三件事:结果 key 长度不可预测;NOT 输出截断在输入长度内、NOT+AND 两跳会丢高位;STRLEN 差异过大是映射口径漂移的信号。
- 结果 key 不继承源 key 的 TTL,用完记得 EXPIRE/UNLINK。
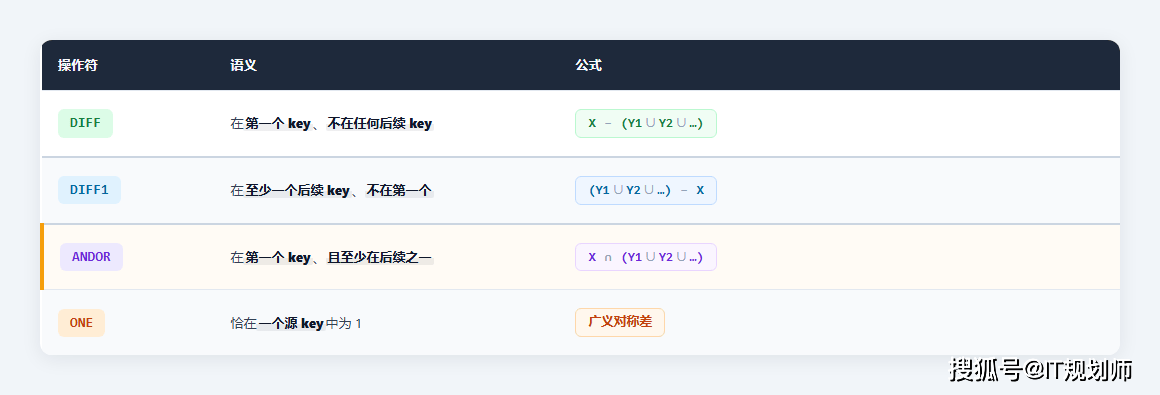
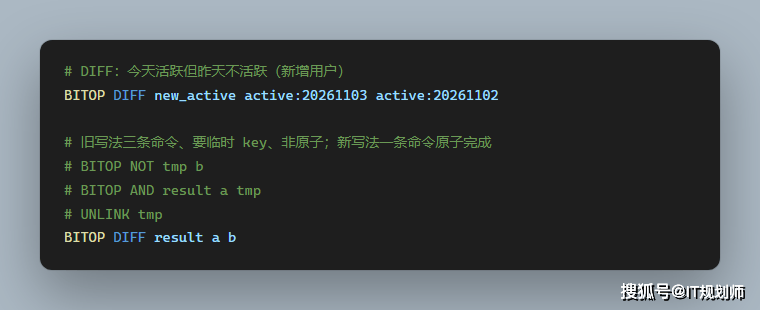
8.2 的四个新操作符把过去要写 Lua 的位集合运算变成一条命令:
1.6 .NET 解析:只有 ExecuteAsync
StackExchange.Redis 至今没有 BITFIELD 高层封装(社区 PR 未合并)。网上出现的 StringBitfieldAsync / BitfieldOperation 之类签名均不可信,所有版本都走 ExecuteAsync。
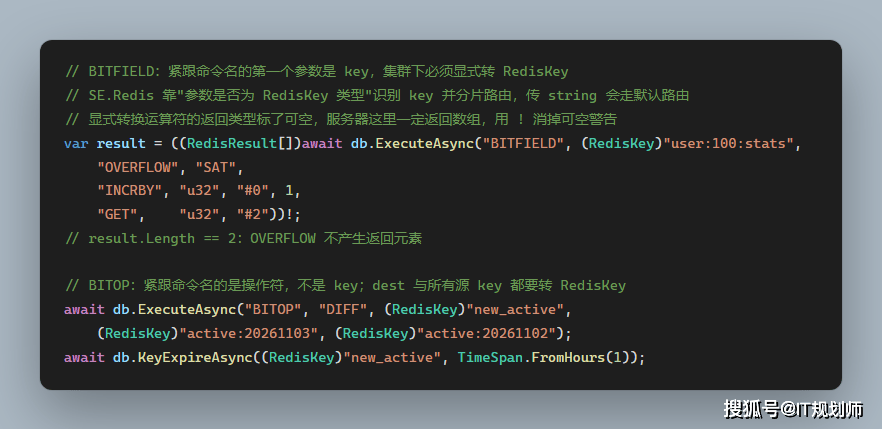
三个最容易踩的点:
- 返回值解析。RedisResult 有到 RedisResult[] 的显式转换运算符,整条结果先 (RedisResult[]);公开 API 既没有 AsArray()(内部 AsRedisResultArray() 为 internal),也没有 AsInt64()(同为 internal,实测 CS0122),单元素统一 (long)result[i],别调 .AsInt64()。解析前先判 IsNull:读场景可缺省为 0,写场景必须区分 nil(被 FAIL 拒绝)与 0(真值)。
- 参数数组一次传完。ExecuteAsync("BITFIELD_RO", key, argsArray) 会把 object[] 当单个参数装箱,命令帧拼错、服务端收不到并超时。
- u64 与类型名:类型字符串必须 i1~i64 / u1~u63,uint8、U8 都会 Invalid bitfield type。副本读只能 BITFIELD_RO;BITOP 多 key 必须同 Slot;RESP2/RESP3 响应结构可能不同,上线前两种协议各跑一遍。
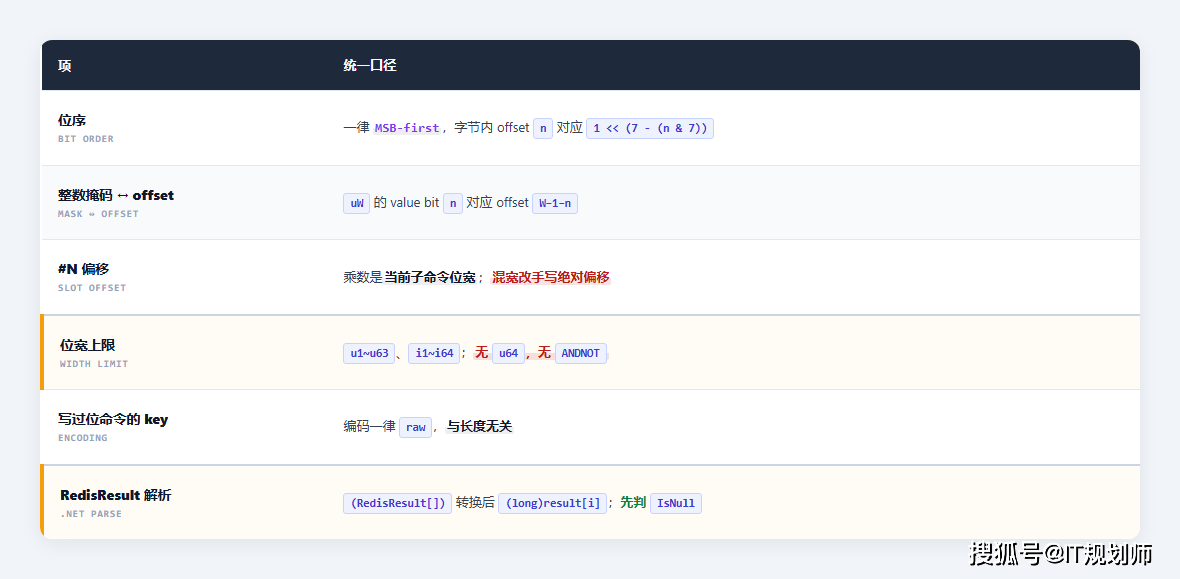
1.7 一页速查
2.1 位域住在 String 里
BITFIELD 操作的就是一段 SDS 字节串,和 SETBIT 完全一样。所以 TYPE key 返回 string;被位命令写过的 key 编码是 raw(写路径会 unshare,强制脱离 int/embstr),但由 SET 创建、只被 GET 读过的 key 仍可能是 embstr,别拿编码判断"这是不是位域";可以对它用 STRLEN/EXPIRE/MEMORY USAGE/UNLINK;禁用 APPEND/SETRANGE,它们会改长度和内容、破坏布局。
2.2 按需扩展,但绝不缩容
SET/INCRBY 写到超过当前长度,会自动扩展并按字节补 0:
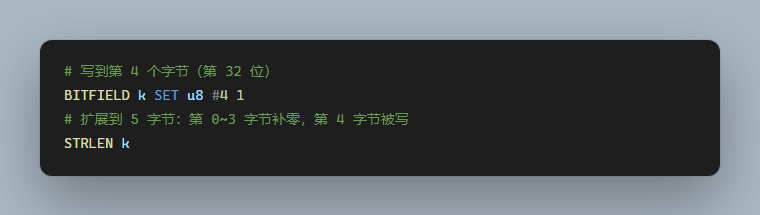
长度由你写入的最远位置决定,与真正用到的字段数无关。所以布局要按最远字段算容量——随手写 #1000000 会立刻分配约 1 MB(与第 6 篇的大 offset 陷阱同源)。
反向不成立:清零不会缩容。把字段 SET 回 0、整段清成 0,长度也不缩短,max_offset 不回退。这直接影响"定时任务把今日字段清零"的设想:key 一旦被大 offset 撑过就永久占着那块内存。要真正释放只能 DEL/UNLINK 重建;更省心的是 key 按日切换 + TTL。
2.3 MSB-first 与符号扩展
位序高位在前(大端 / MSB-first)。一个字节里,offset 最小的 bit 对应最高位。SETBIT k 0 1 写入的是 \x80(1000 0000),不是 \x01。
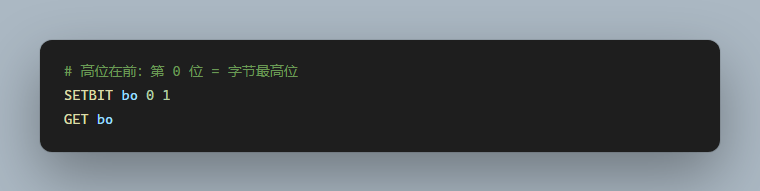
对你意味着什么:在应用层自己拆原始字节时,必须用 1 << (7 - (offset & 7))。照搬 1 << offset(小端直觉),整个字节位序反转,offset 0 与 7 对调——这就是"命令行验证正确、应用层解析全错"的根因。
符号扩展:同一段比特,按 i 读和按 u 读是两回事。i4/u4 共用 4 位:
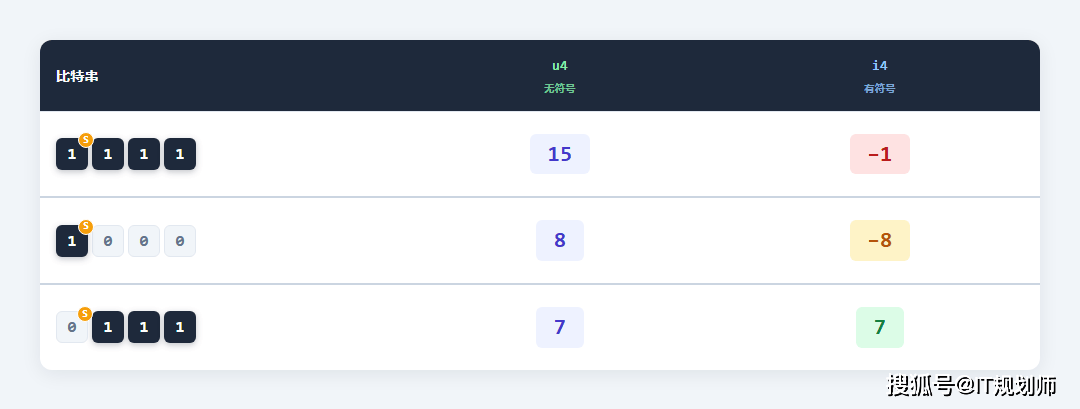
有符号读法把最高位当符号位(补码)。所以字段类型必须"一次定型",不要在同一槽位混读。
2.4 未初始化恒 0
GET 读超出长度的位、或从未写入的区域,一律返回 0,不报错。由此带来一个语义陷阱:用 u2 存状态(0=未激活、1=激活、2=冻结、3=注销),"真的未激活"和"从未设置"返回的都是 0,分不清。
两个解法:① 额外用一个 u1 标记"该槽位是否写过";② 值从 1 起编号,让 0 专表"未设置"。
2.5 溢出三策略与业务选型
同一个起点、三种结局(每条独立 key,从 255 起加 1):
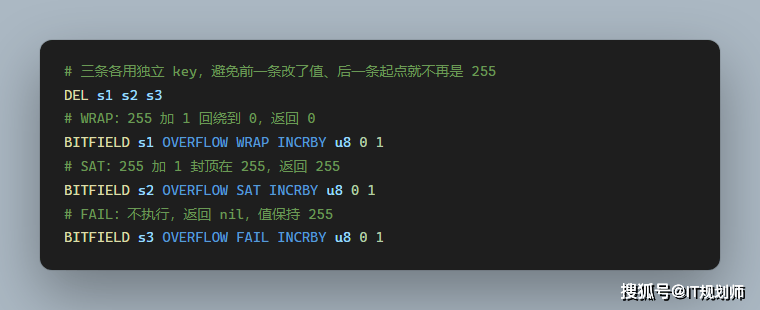
i8 的三种结局同理,只是方向更隐蔽:127 加 1 在 WRAP 下变成 -128(符号翻转)。
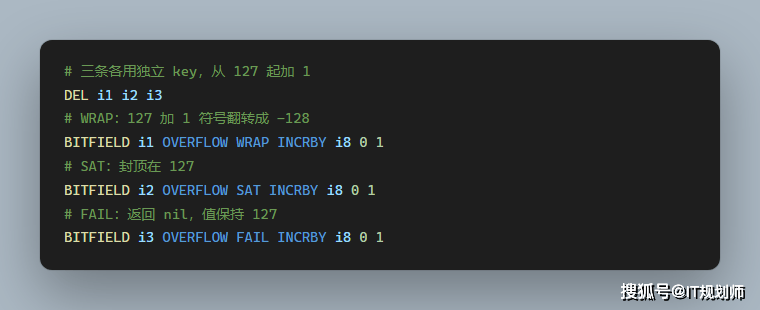
SET 同样会越界,而且更隐蔽——调用方以为写什么就是什么,返回的旧值又让命令看起来成功了。u8 写 300:默认 WRAP 静默存 44(300 mod 256);SAT 存 255;FAIL 返回 nil 拒绝。
业务选型三句话:
- 只增不减的计数器(签到、积分、累计消费)→ SAT 或 FAIL,绝不用 WRAP。SAT 封顶要能被感知(返回值 == 上限即信号,客户端埋点告警),否则报表静默停涨;对封顶敏感的指标改用 FAIL。
- 允许负增量的短期计数(余额、可撤销计数)→ 优先 SAT,但位宽要覆盖负界;扣减不可截断(少扣一分都不行)就用 FAIL + 应用层拒绝重试。
- "回绕即业务语义"(哈希、环形缓冲区序号)→ WRAP 才是对的。
2.6 FAIL 的边缘:全部失败,key 却已被预扩展
这是本篇最重要、最容易漏的一条。
BITFIELD 的执行顺序是先按最远触点创建/扩展字符串,再逐条执行子命令。即使所有写子命令都因 FAIL 返回 nil,预创建/预扩展已经发生;但因为没有任何 bit 写入成功,changes 计数保持 0,于是它不标记 key modified、不发 keyspace 通知、不写 AOF、不传播副本。
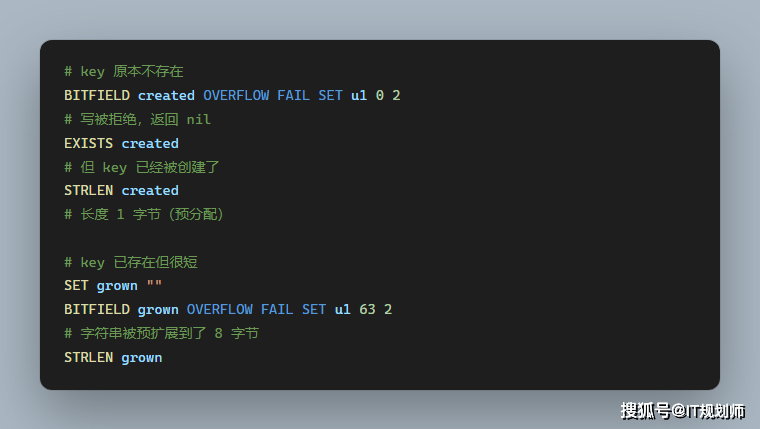
后果:主库的 key 长度/存在性已改变,但这个改变不写 AOF、不同步副本;主从从此可能不一致,AOF 重载后预扩展又消失(Redis issue #15599)。
规避:不要依赖"FAIL = 什么都没发生",对存在性/长度敏感的场景额外校验 EXISTS/STRLEN;需要"全有或全无"用 MULTI/EXEC 或 Lua;该行为在 7.x、8.0 上同样存在,修复状态以对应版本的 release notes 为准。
2.7 原子非事务,读改写不在保护范围
单条 BITFIELD 内部不会被并发打断,但没有事务语义:某个子命令 FAIL 只跳过它,前面成功的不回滚。
更关键的是跨命令的读-改-写:把 8 个值读回应用层、改一个、再 SET 写回,两个并发请求会互相覆盖(lost update),且无报错。BITFIELD 的"原子"只覆盖单条命令内部。
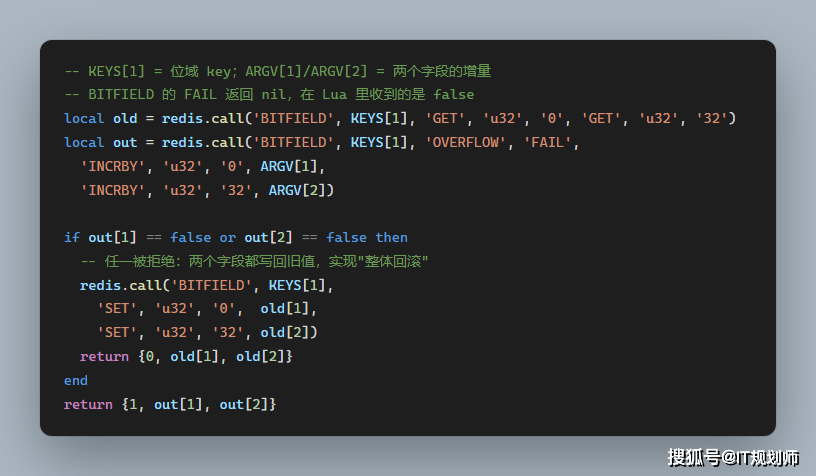
"全有或全无"的最小 Lua 样例(两个计数必须同时成功,任一被拒则整体恢复旧值):
2.8 亲手验证
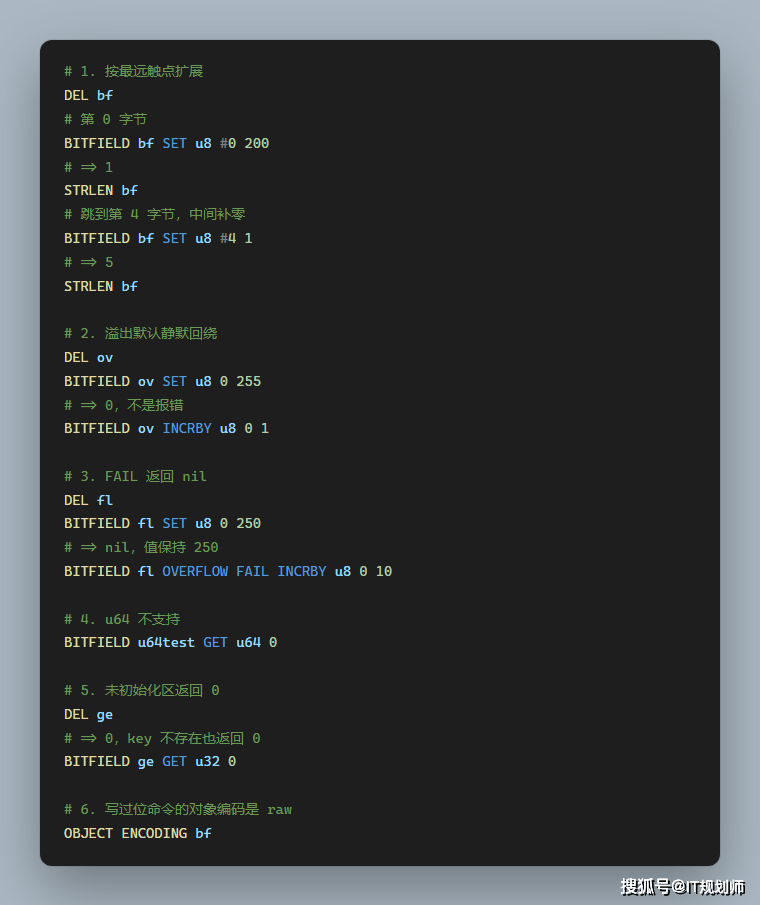
建议第一次读到这照着敲一遍,尤其第 2 步——亲眼看到"255 加 1 等于 0",比读十遍都记得牢。
2.9 位操作全家族总览
把本篇与前一篇的位能力放在一张图里,避免"该用哪个"反复纠结:
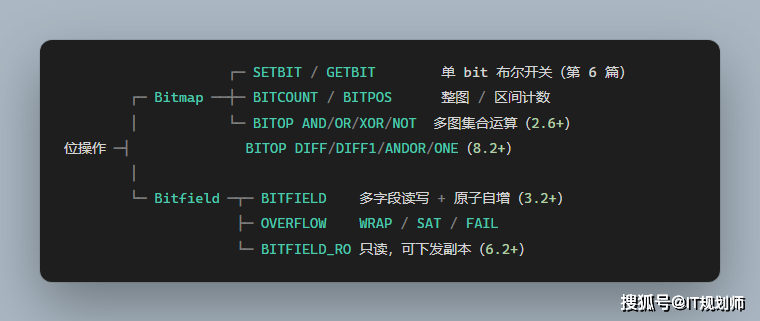
三条边界决定选型:一个 bit 表达一个布尔用 Bitmap;多张图之间做集合关系用 BITOP;一个对象上挂多个小整数用 Bitfield。三者在同一系统里可以并存,而且常常并存——日活图用 Bitmap、漏斗用 BITOP、每篇帖子的互动数用 Bitfield。
三、生产五大场景3.1 八计数器:一个 String 存 8 个 u32
内容社区每篇帖子维护 8 类互动数——浏览、点赞、收藏、评论、转发、举报、分享、打赏。一计数一 key,一篇帖子就是 8 个 key。
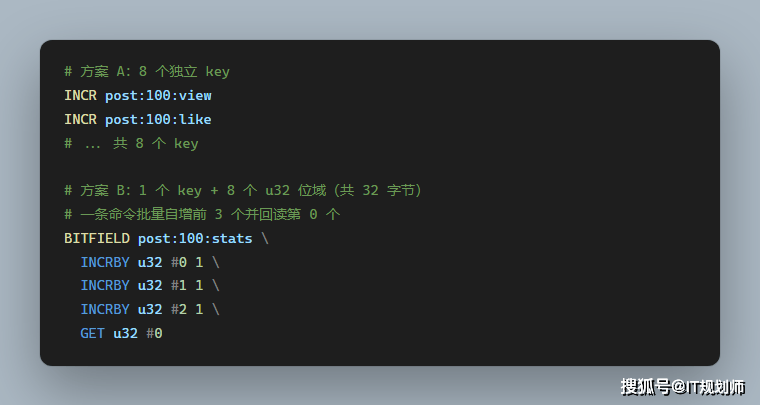
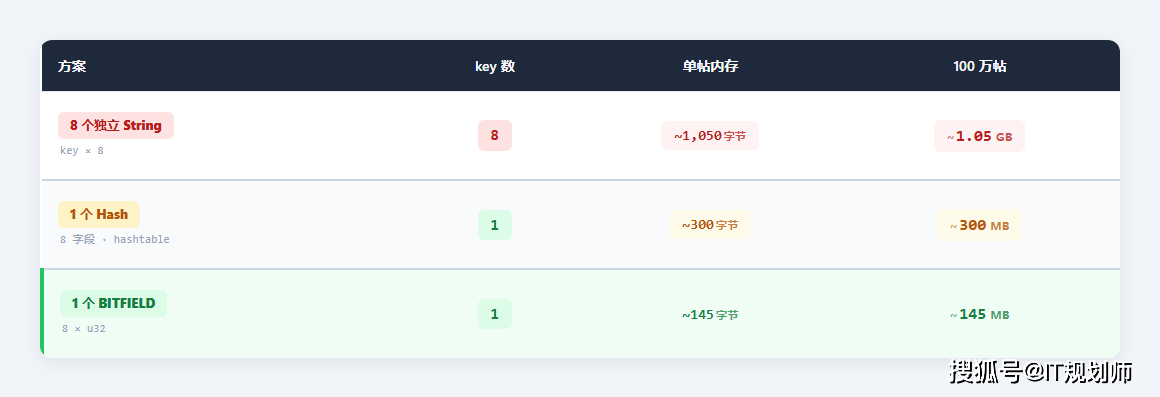
从 ~1.05 GB 到 ~145 MB,省约 86%——这就是"内存再砍 80%"的账单。
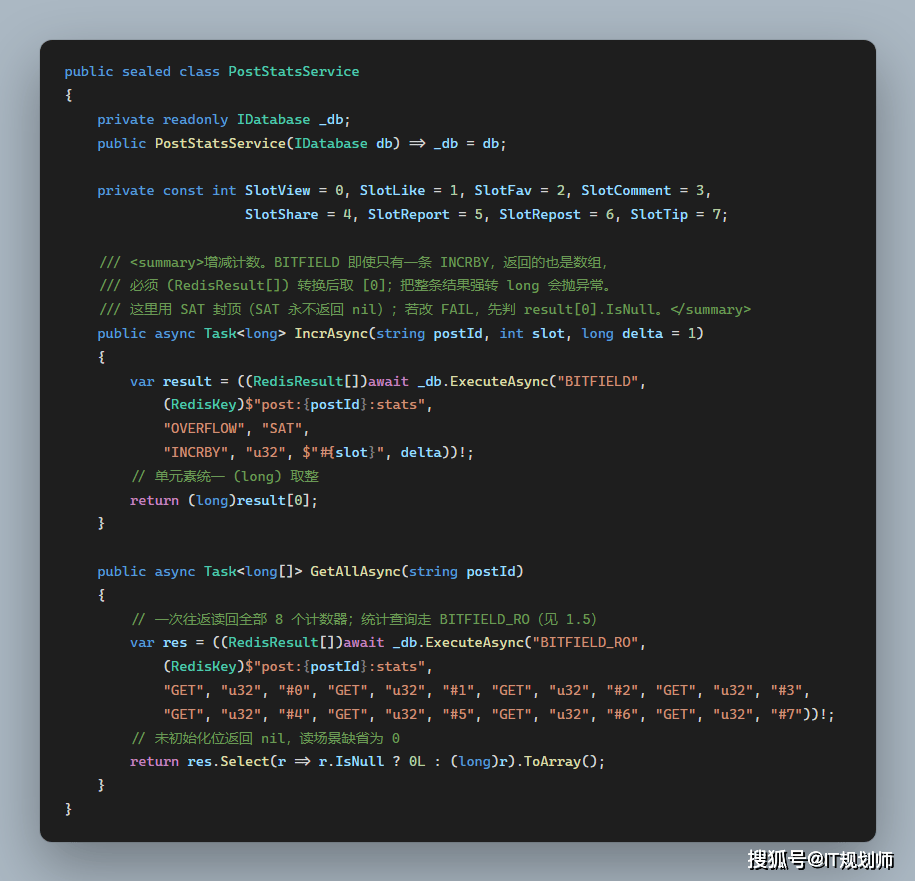
边界:8 个计数共享一个 key 的 TTL,不能单独过期;u32 上限约 42.9 亿,单篇千万级爆款够用,"累计曝光"这类指标要 u63 或拆字段。按日滚动的字段必须 key 按日切换 + TTL(如 post:100:stats:20261105)——如果用常驻 key 每天把 8 个字段 SET 0,不但多写一轮,还会因 2.2 的"清零不缩容"永久占着历史最大长度。热点帖子是单 key 热点,超热内容先在应用侧本地聚合再批量落盘,或拆 key 分散到多个分片。
3.2 权限位与多状态段:掩码与位段同一个服务
权限:32 个功能权限用 u32 的每一位表示,一个用户全部权限只占 4 字节。
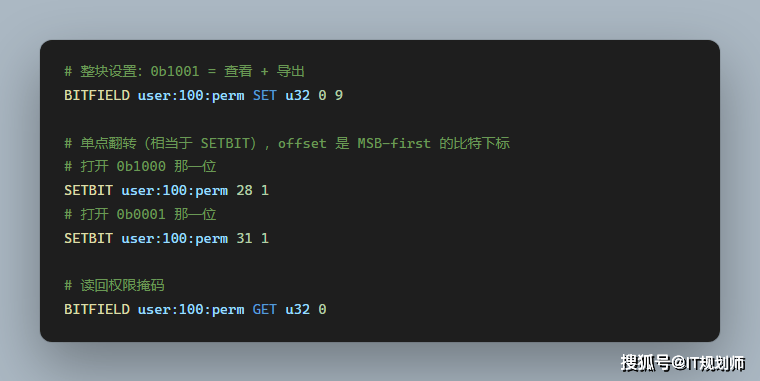
多状态段:一局游戏 6 个角色,各有血量 u16、等级 u8、状态 u2,每角色预留 128 bit。这里刻意不用 # 相对偏移——#N 的乘数是当前子命令位宽,混用 u16/u8/u2 时会落进错误区间并互相覆盖,改用绝对 bit 偏移:
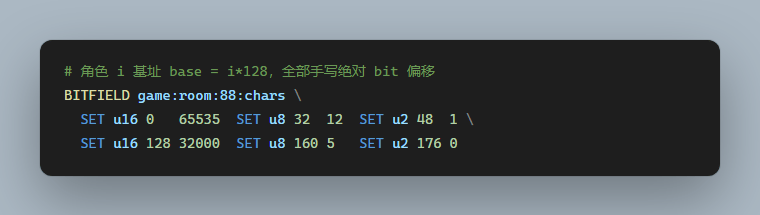
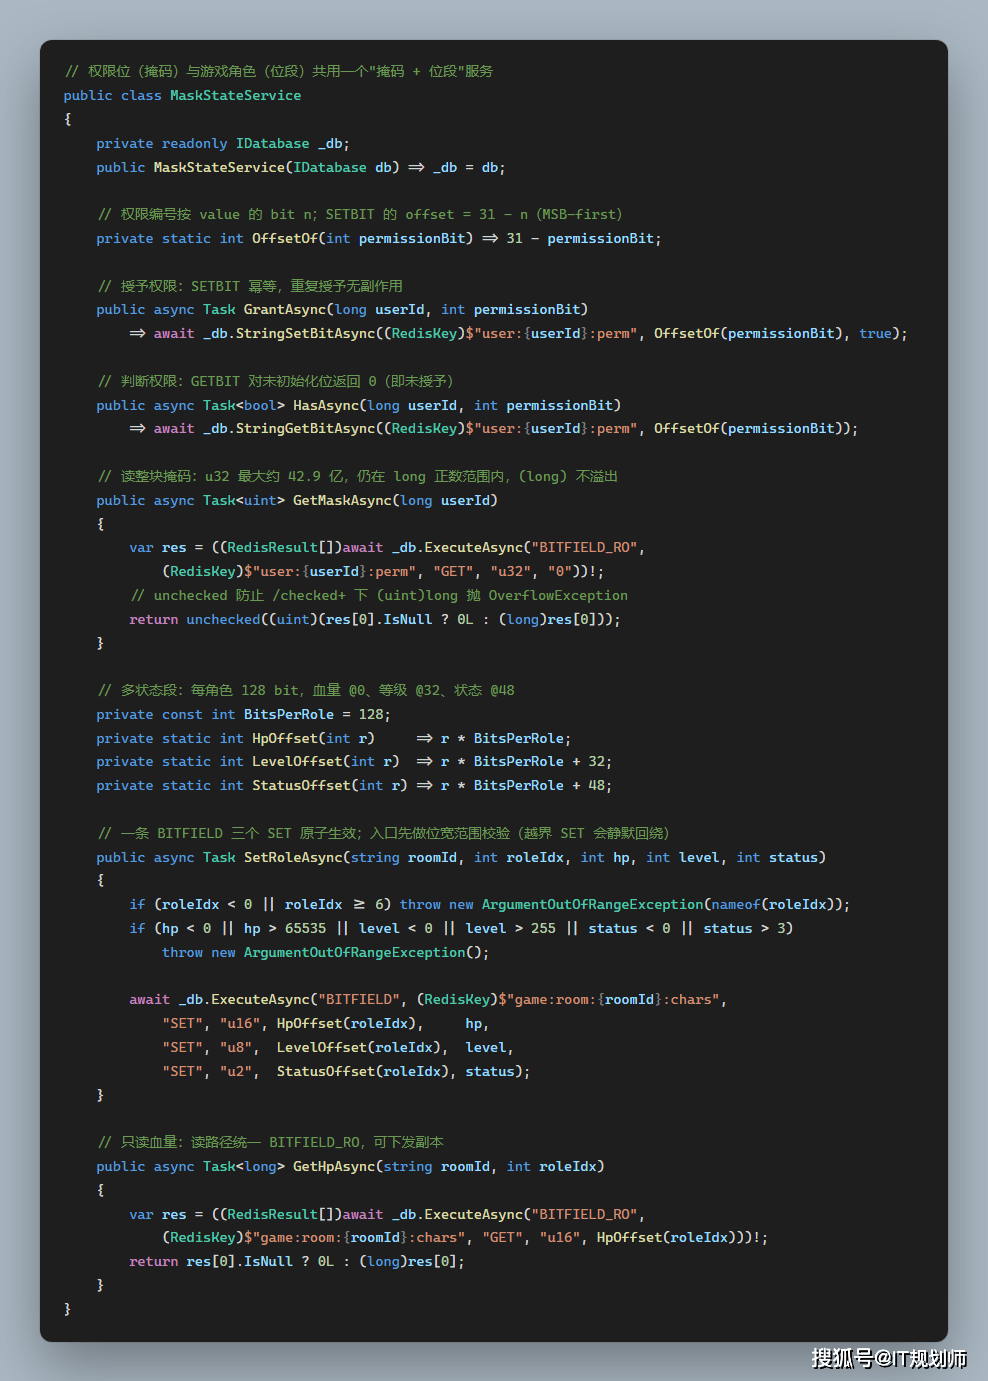
边界:布局是硬编码约定,发布后不能随意改(改了旧数据全错);跨字节边界读取时部分 SDK 解析易出错,建议按字节对齐;权限超过 63 个改用第二个 u63,更实际是换回 SETBIT 位图(offset 上限 2^32−1)。
为什么权限不用 SETBIT 位图? 两者都只占几字节,差别在"读法":位图按用户 ID 建图、一个用户一个 bit,适合"这批用户里谁有某权限"的批量筛选;位域按用户建 key、权限落在同一个 u32 里,适合"这个用户有哪些权限"的单点查询。权限数固定、按用户查,位域更顺手;要按权限维度批量圈人,仍该用位图 + BITOP。
3.3 滑动窗口:60 个 u16 秒桶
统计"最近 60 秒请求数",用 60 个 u16 桶(每秒一个)。
先说常见错误设计:把 60 个桶放一个常驻 key、读时全加起来——桶永不复位,算出来的是"有史以来累计"。要正确,key 必须带时间切面:按分钟切 key,桶对应这一分钟内的秒位。
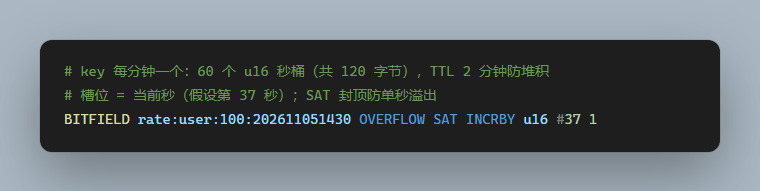
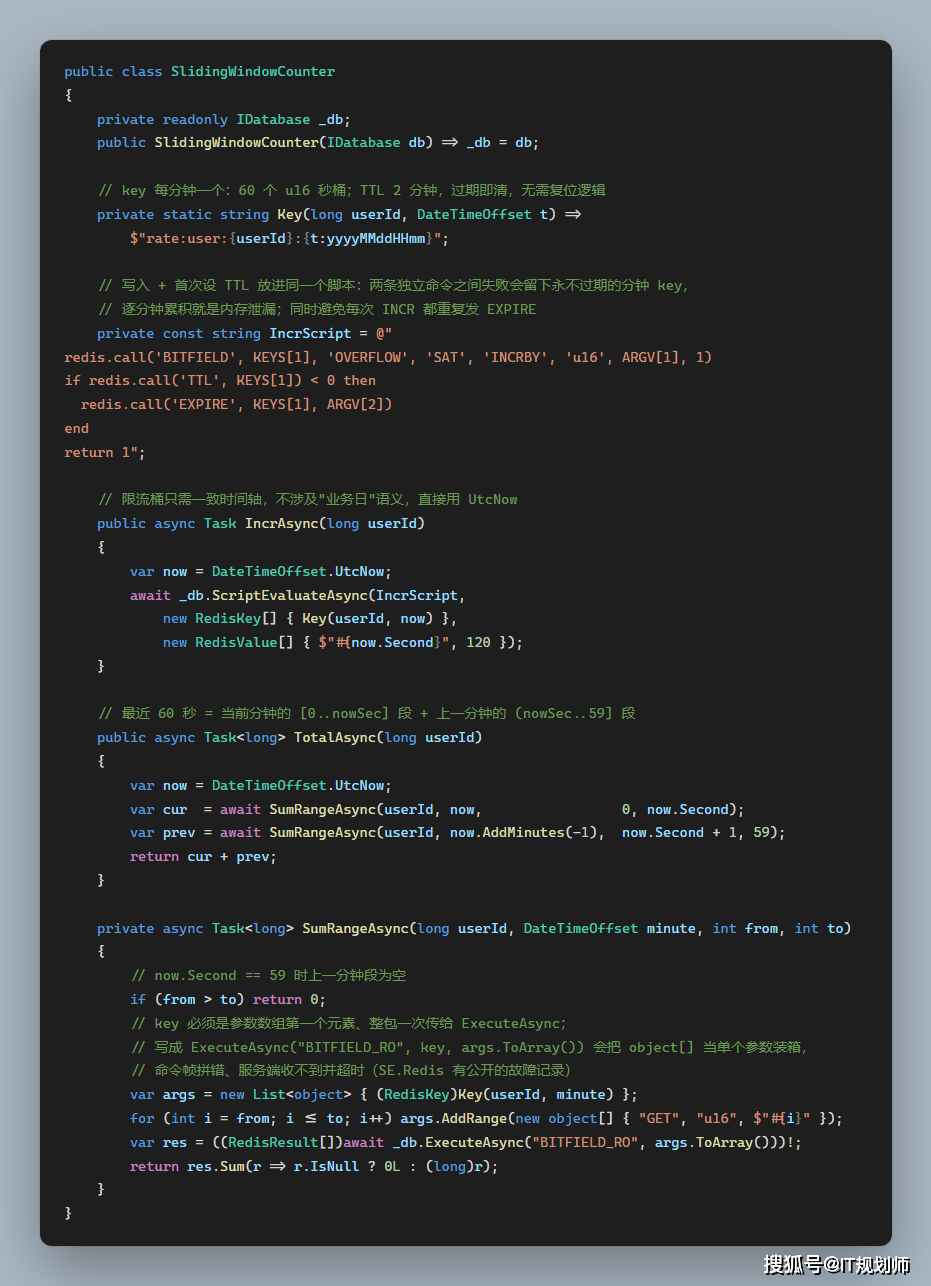
边界:跨两个 key 的求和有两次往返,精确限流要用 Lua 在服务端一次完成;桶宽 u16 上限 65535,单秒 QPS 极高换 u32;TTL < 0 分支只在 key 首次创建时触发。
3.4 漏斗与分组归属:位图 + BITOP 新操作符
运营要看"访问商品页 → 加购 → 下单"的漏斗,或"这批用户谁同时属于 A 活动、又没参与 B"。这类"多张位图之间的集合关系",正是 BITOP 新操作符的主场。
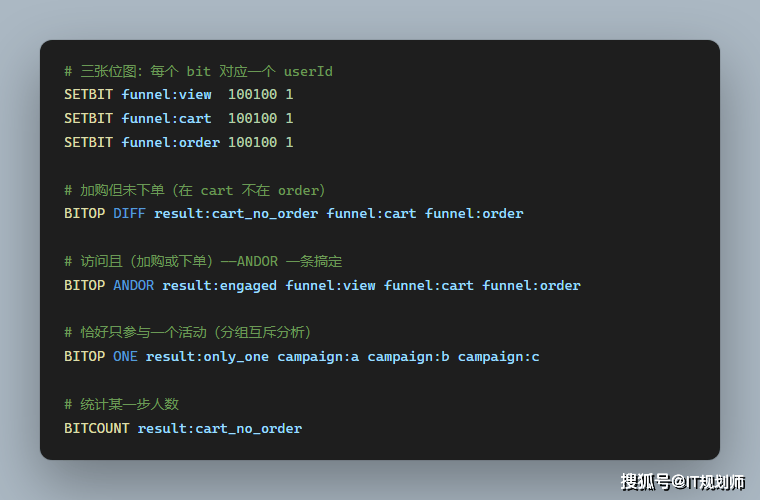
C# 端只需一条 ExecuteAsync(见 1.6 的 BITOP 示例),dest 与所有源 key 都显式转 RedisKey。
边界:需要 userId 稠密有界(大 offset 陷阱同第 6 篇);跨 Slot 的 key 用 Hash Tag 绑定;结果 key 务必 EXPIRE。
与 3.1~3.3 的分工:前三节用位域存"每个对象自己的多个小数字",本节用位图存"每个用户的一个布尔状态"再做集合运算——两者常在同一系统并存。
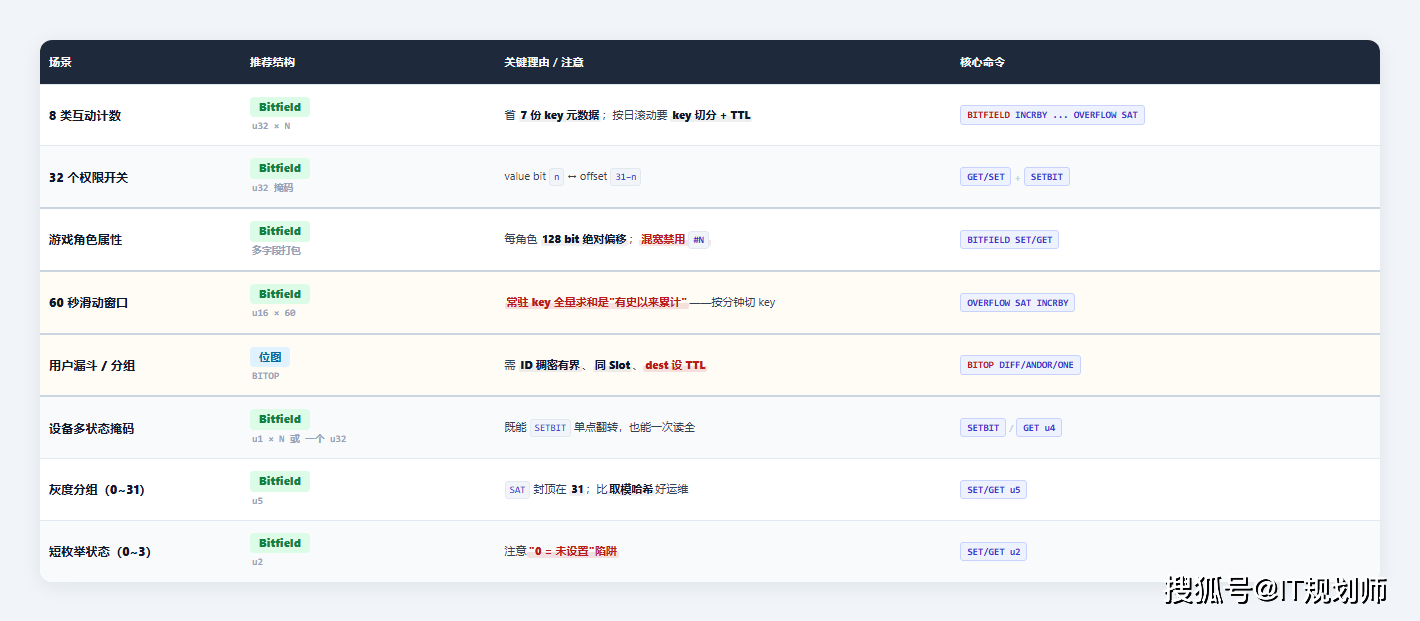
3.5 场景速查
4.1 内存构成:省的是 key 元数据,不是位宽
先算位域数据本身:
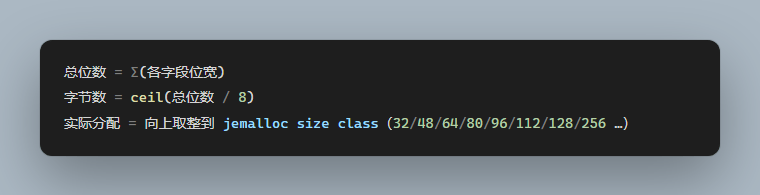
字段宽度之和决定理论字节数,真正占多少看 jemalloc 桶。只需要 130 位(约 17 字节),jemalloc 会给 32 字节的桶——所以"省内存"必须连桶对齐一起算。
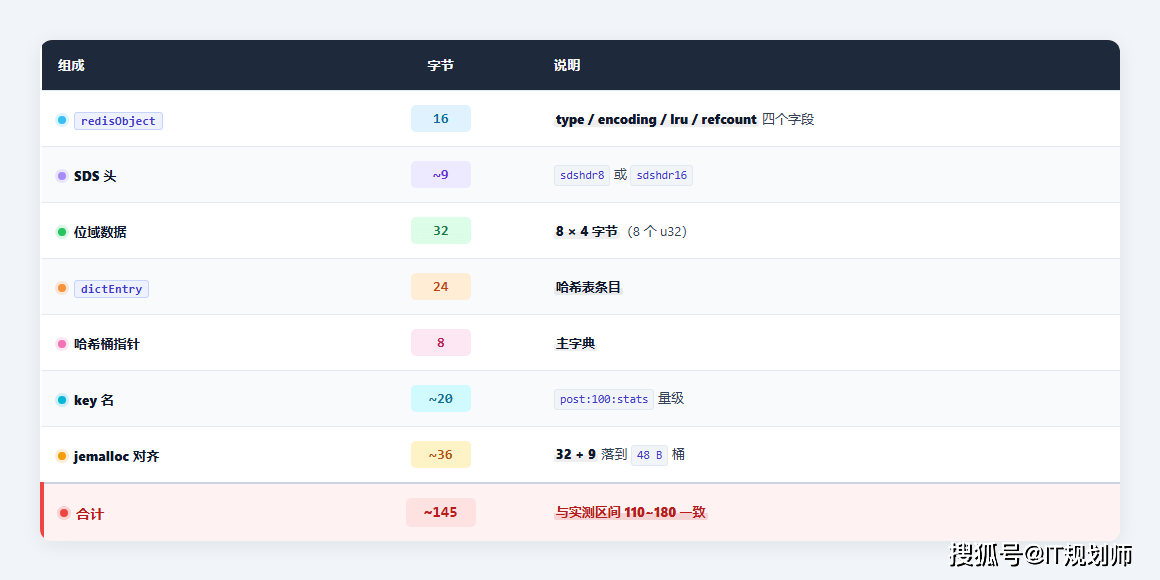
关键认知:位域省的不是"位域数据比 key 小",而是被合并掉的 key 的固定开销。一个 key 的固定开销约 77 字节(redisObject 16 + SDS 头约 9 + dictEntry 24 + 哈希桶 8 + key 名 20)。把 N 个独立计数 key 合并成 1 个位域 key,省下 (N−1) × 77 B,与位域数据本身多大无关。

所以"100 万个 u4 位域 = 500 KB,比 100 万个独立 key 的 77 MB 省 150 倍"是错的对比:左边只算位域数据、右边算完整 key,而且 100 万字段塞进一个 key 会得到 500 KB 的 value,是 64 KB 大 key 线的 8 倍,RDB fork、主从同步、集群迁移都会被拖累。真实布局是"每用户/每帖子一个位域 key",每个 key 同样付 77 B——收益只来自"合并了多少字段"。
单个 key 的内存构成(8×u32 为例):
4.2 三方案量化对比
同样存 8 个计数器,key 名均假设约 20 字节,统一 1000 进制:
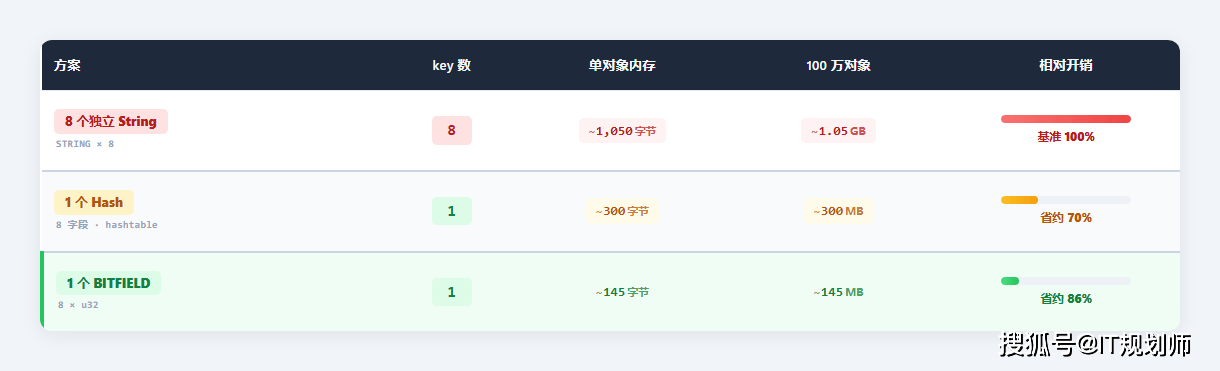
规模账:日活 500 万的内容产品,不压缩(每用户每类一行)是 4000 万个 key × 约 131 B ≈ 5.25 GB;位域压缩(每用户一个 key 含 8 个 u32)是 500 万 × 约 145 B ≈ 725 MB,省约 86%。省下的还有主从带宽、RDB 体积、集群迁移时间。
⚠️ 跨表引用数字先确认分母:6.2 的 1050 B 是"每对象 8 个 key 的合计",拿它乘 4000 万会高估 8 倍;77 B 是"每 key",131 B 也是"每 key",三者不能互换。4.3 64 KB 大 key 线与字段数上界
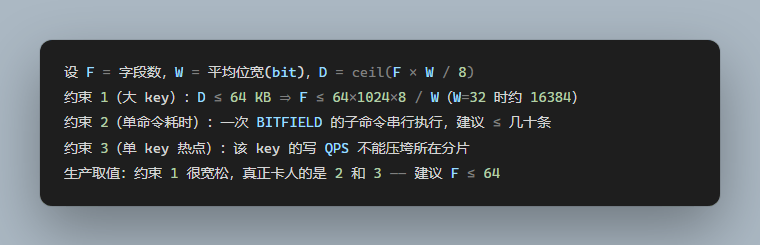
大 key 线:单个位域 value 超过 约 64 KB(约 51 万 bit) 就该拆分或改用 Hash——大 String 会放大 RDB fork、主从同步、UNLINK 与集群迁移压力。8×u32 只有 32 字节,离这条线很远;撞线的是"把一整张日活图塞进一个位域 key"这类误用。
每 key 放多少字段:
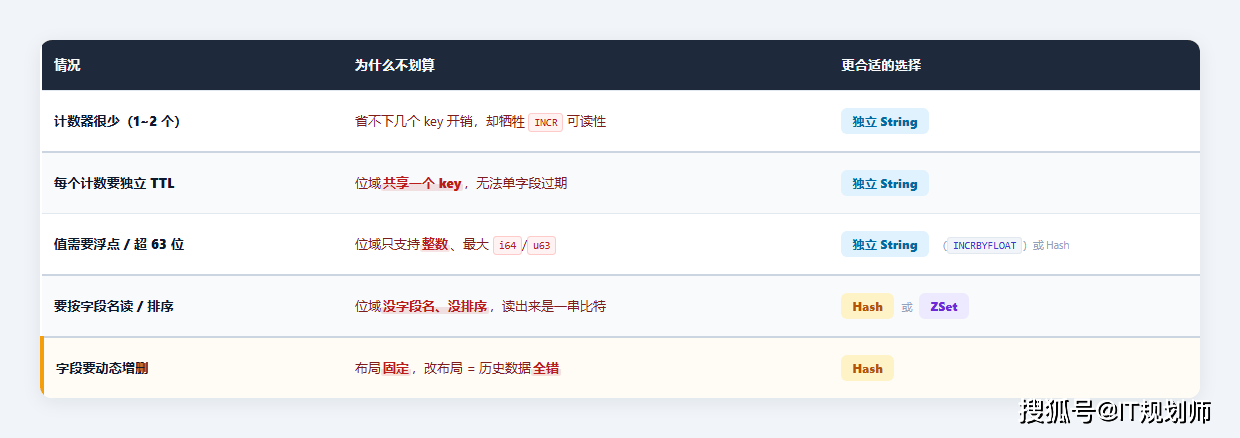
4.4 什么时候位域不划算
4.5 全套位指令选型决策树
选型不只发生在 String/Hash/Bitfield 之间,也发生在位操作的三个视角之间:
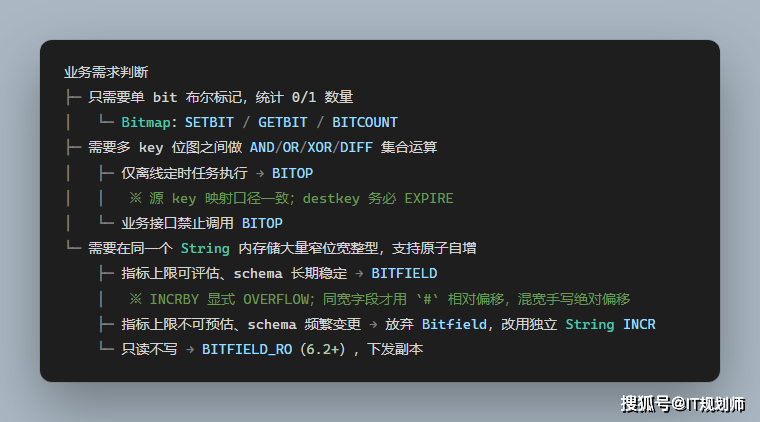
关键取舍:Bitfield 是"牺牲可维护性换极致内存压缩"。schema 一变,改一个字段位宽,后面所有偏移全部错位。字段固定、个数已知、值域是小整数三条同时满足才值得用;否则 Hash 或独立 String 更稳。
落到实操,按这个顺序问三句:① 这些值要不要各自过期? 要 → 独立 String,位域做不到。② 字段会不会增删、要不要按名字查? 会 → Hash,位域布局是冻结的。③ 值域是不是 1~63 位的小整数、写入频率可控? 是 → 位域;否则回退。三句都过,再算内存账确认收益足够覆盖维护成本。
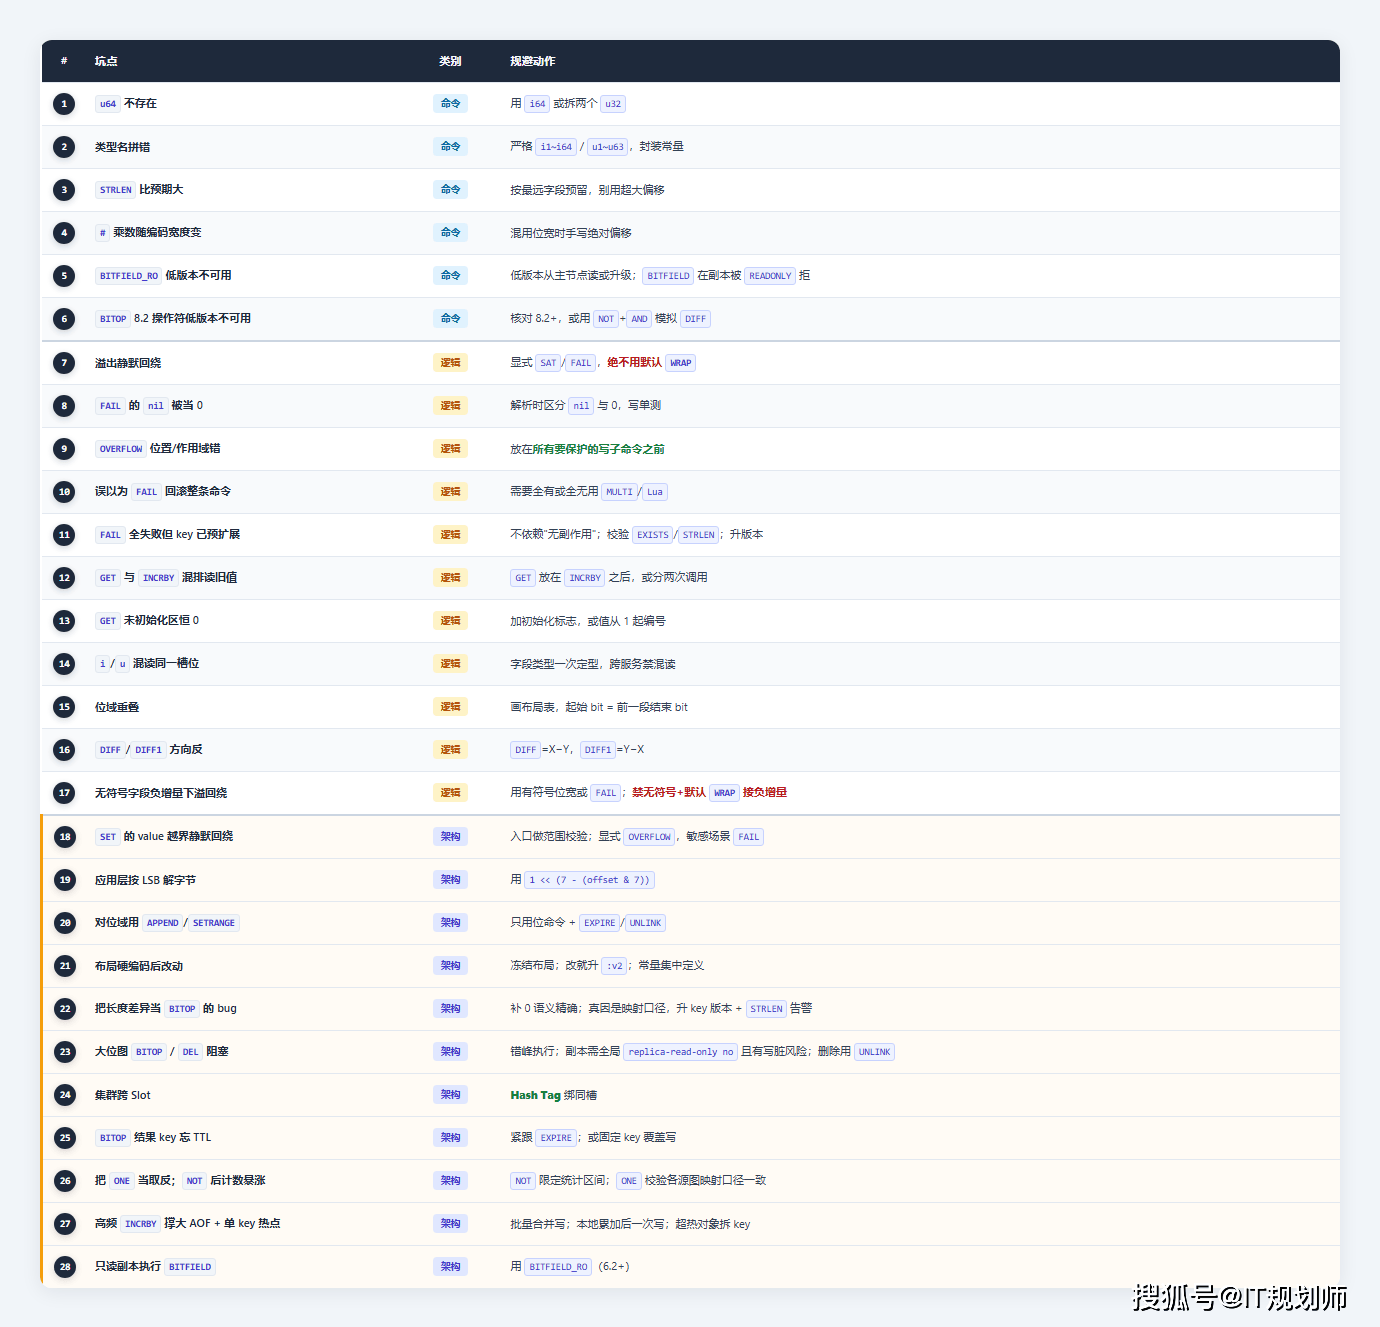
五、坑点速查与上线清单5.1 28 条速查表
5.2 三条必须展开的坑
坑 7|溢出静默回绕(最危险)。u8 涨到 255 后变 0、i8 涨到 127 后变 -128,日志无报错。根因是默认 WRAP,回绕是正常返回值;服务器不抛异常。规避:显式 OVERFLOW SAT 或 FAIL,绝不用默认。注意 SAT 封顶后报表会静默停涨——返回值等于上限也应埋点告警,否则体验和 WRAP 归零一样差。
坑 11|FAIL 全部失败但 key 已预扩展。全部写子命令返回 nil,EXISTS 却是 1、STRLEN 不为 0,主从可能不一致,AOF 重载后 key 又消失。根因:预扩展发生在子命令执行之前,且因 changes == 0 不落 AOF、不传播(issue #15599,详见 2.6)。规避:不依赖"FAIL = 什么都没发生",对存在性/长度敏感时额外校验。
坑 17|无符号字段的负增量下溢。库存/余额用 u32,扣到 0 后再 INCRBY u32 0 -1,值变成 4,294,967,295,比归零更离谱且不报错。根因:INCRBY 的 increment 可为负,无符号下溢在默认 WRAP 下回绕到最大值。规避:可能有负增量的字段用有符号位宽(i32/i64)+ SAT,或用 FAIL + 应用层处理拒绝,绝不让无符号字段在默认 WRAP 下接负增量。
5.3 两个故障复盘
故障 1[性能]:BITOP AND 合并 30 天日活,主线程卡顿数百毫秒。 30 张约 33 MB 的日活图(对应约 2.6 亿 ID 上界)≈ 1 GB 输入,按位运算约 1~2 GB/s 折算,单条命令要跑 0.5~1 秒,期间整个实例阻塞。换成 1000 万 ID 上界(1.25 MB/张)则只有 37.5 MB 输入、约 20~40 ms——别把前者耗时套到自己规模。排查路径:P99 周期性尖刺恰好落在留存任务窗口 → SLOWLOG GET 抓到该 BITOP AND 约 0.8 s → 按输入总字节折算确认是单线程阻塞。
一个反直觉的点:BITOP 的复杂度是 O(N),N 是最长输入位图的字节数,不是 key 的个数。30 张图不是"30 次小操作",而是"一次 33 MB 的逐字节扫描"——耗时随单图规模线性涨,和 key 数几乎无关。这也解释了为什么"把 30 天拆成 3 批各 10 天"没有帮助:每批仍是 33 MB 输入,只是分成三次阻塞。
修复:错峰执行;副本执行需先设 replica-read-only no(全局配置,改完该副本可被任何客户端写脏,full resync 即被冲掉,只适合一次性聚合);更稳的是按 ID 分片拆小位图、各算一次再应用层相加,或用独立统计实例;结果 key 设短 TTL。
故障 2[一致性]:两张日活图映射口径不同,BITOP AND 全错。 一次 uid→offset 映射迁移后序号基准变了,新旧两张图(一张 12.5 MB、一张 1.25 MB)直接 BITOP AND,交集统计全错。排查初期怀疑"BITOP 对长度不一致的处理有 bug"——方向就错了:补 0 与缺失位的真实内容一致,BITOP 无辜,错的是映射。修复:映射口径变更必须升 key 版本并迁移;定期 STRLEN 抽查,把"同上界的图长度差异过大"当口径漂移的告警信号。
其余四个故障(u4 归零、FAIL 预扩展、结果 key 堆积、应用层位反)的根因与修复分别对应坑 7 / 坑 11 / 坑 25 / 坑 19。5.4 上线前 10 项自检
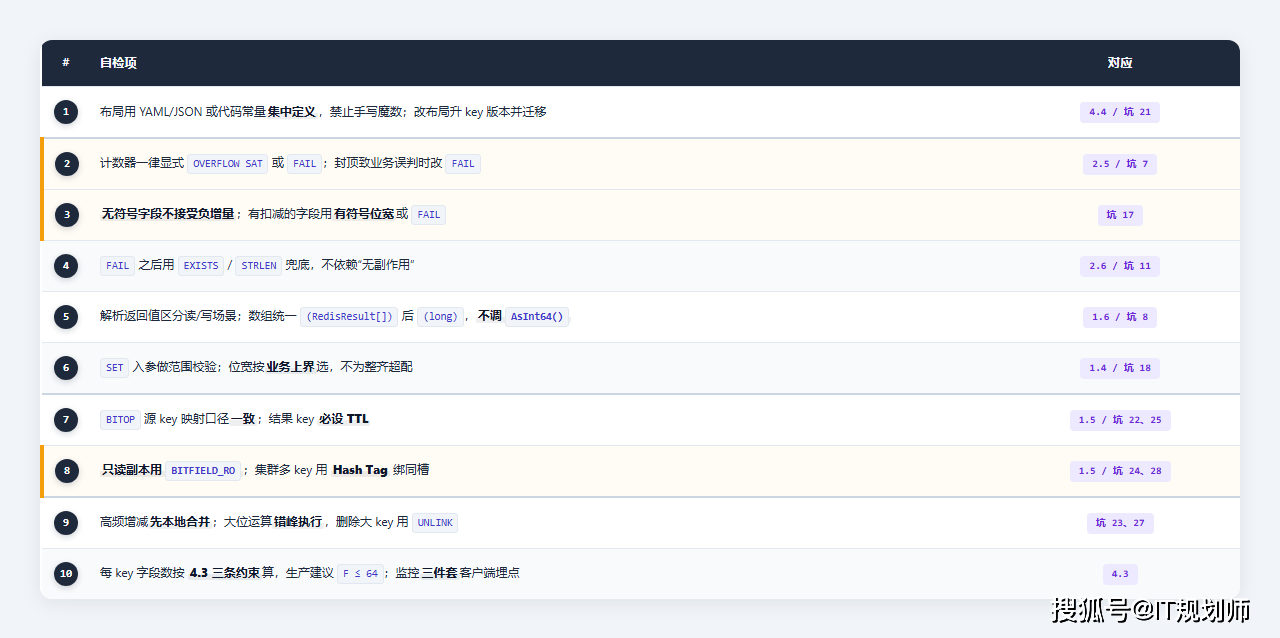
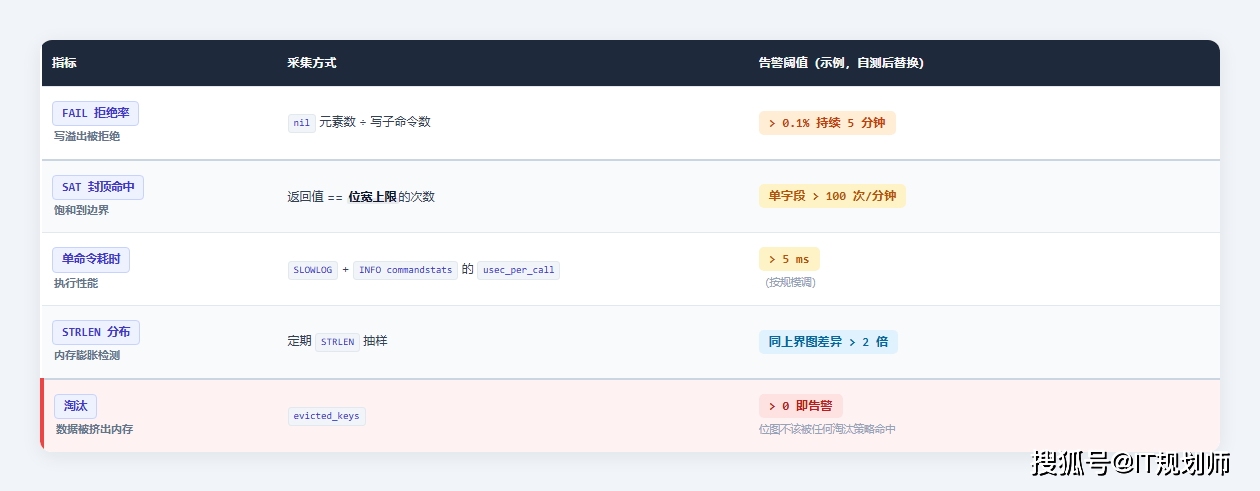
监控必须客户端埋点——服务端对这些没有指标,等 Redis 提供是等不到的:
6.1 FAQ
Q1|BITFIELD 和 SETBIT 什么关系? 同一张 String 的两种视角:SETBIT 管单个比特,BITFIELD 管连续多位。底层都是 SDS 字节串。
Q2|为什么 u64 不支持、i64 却支持? RESP 整数是有符号 64 位;u63 最大值能塞进正数范围,u64 的 2^64-1 超出无法表达。
Q3|写溢出会报错吗? 服务器层面都不抛异常:WRAP/SAT 静默返回回绕/边界值,FAIL 返回 nil。区别在客户端能否感知——只有 FAIL 给了显式拒绝信号,但需主动判 nil。SET 的 value 越界同样走这套策略。
Q4|# 和纯数字偏移有什么区别? 纯数字是"第 n 个比特",#n 是"第 n 个类型宽度的槽位"(offset = n × 位宽)。# 用于同宽数组;混宽时手写绝对偏移更安全。
Q5|GET 读不存在区域会怎样? 返回 0,不报错。所以无法区分"真 0"与"未写"。
Q6|OVERFLOW 影响哪些子命令? 只影响它之后、直到下一条 OVERFLOW 之间的 SET/INCRBY,对 GET 无效。
Q7|一个 String 能省多少内存? 省约 86%;小规模 Hash 走 listpack 时差距缩小到约 1.2 倍,选型前实测编码。
Q8|DIFF 和 DIFF1 有什么区别? 方向相反:DIFF 是 X−Y(在第一个 key 不在其他),DIFF1 是 Y−X。
Q9|应用层自己解析位图为什么左右颠倒? Redis 位序是 MSB-first,字节最高位对应 offset 最小的 bit;正确写法 1 << (7 - (offset & 7))。
Q10|两张位图 BITOP AND 交集偏小,可能是什么原因? 几乎不会是 BITOP 本身——长度不一致时补 0 与缺失位真实内容一致,结果精确。真正要查的是两张图是否用了不同的 uid→offset 映射,STRLEN 差异过大是口径漂移信号。
Q11|同一条命令里 GET 和 INCRBY 谁先生效? 按书写顺序串行执行。想读到自增后的值,GET 必须写在 INCRBY 之后;写在前面的 GET 读到的是旧值。
Q12|位域能存负数吗? i 类型可以(补码表示);u 类型不接受负值写入——SET u8 0 -1 会走溢出策略,默认 WRAP 静默回绕成 255,FAIL 则返回 nil。
6.2 小结
Bitfield 是 Redis 位能力里**"最反直觉、也最容易静默出错"**的一块:把 String 当成可按任意位宽、任意偏移读写的位域数组,收益是内存砍 80%,代价是溢出静默、布局强 Schema 绑定、位序与符号要自己守。
三条最该记住:
- 溢出默认静默。不写 OVERFLOW,u8 255+1 变 0、i8 127+1 变 -128,SET 越界同样回绕,无符号负增量还会下溢成天文数字。计数器一律 SAT;封顶致误判或扣减不可截断时用 FAIL;OVERFLOW 只向后生效。
- 原子但非事务,FAIL 也不是"什么都没发生"。单条命令只保证不被并发打断,不回滚;跨命令读-改-写要搬进 Lua 或 WATCH;全部写被 FAIL 拒绝时 key 仍可能已预扩展且不写 AOF、不同步副本。
- 用可维护性换内存压缩。收益来自消除 per-key 元数据(每合并一个 key 省约 77 B),代价是布局强 Schema 绑定、位序 MSB-first、符号一次定型。字段固定、个数已知、值域小整数三条同时满足才值得用。