作者|木许
编辑|重点君
一个模型还没有正式发布,大家已经开始猜它的名字、辨认它的身份,甚至提前盘算着它能跑在哪张显卡上。Qwen4还未诞生,就承载了很多期待。
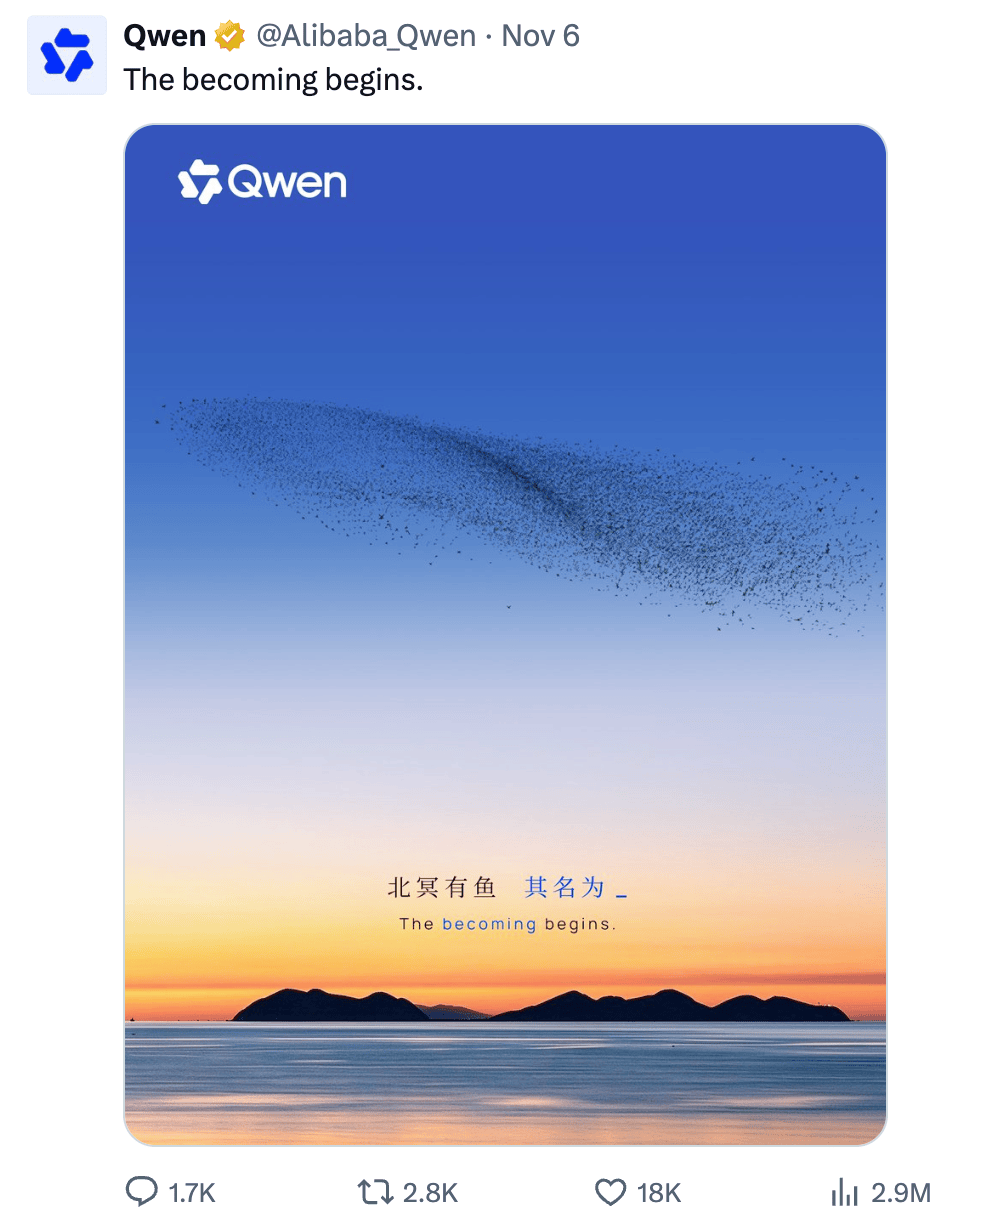
11月6日,千问官方账号发出一张预热海报。截止目前,这条预热帖已获得约 290万次浏览、1.8万次点赞。
五天后,Qwen4-Max预览版率先开放,官方直接邀请开发者用真实问题来试水。不过,在这则预览公告里,官方没有附上benchmark,也没有展开与其他旗舰的对比。
Qwen过去积攒的影响力,很大一部分扎根在开源社区。开发者下载、微调、量化、部署,把不同尺寸的千问装进自己的产品和本地显卡里。但作为旗舰,它终究要回答最核心的问题:智能的上限,能往前推多少?尤其是在林俊旸离职之后,外界对千问的审视又多了一层。这一轮大版本的代际更新,既要拿出足够有分量的硬实力,也必须经得起用户真刀真枪的上手检验。
11月16日,Qwen4-Max正式发布。当期待落到实处,我们就通过API和千问办公从几项真实任务看看Qwen4究竟有多能打?
海外已经测起来了 但漂亮只是第一关翻一翻X,Qwen4的早期体验里,视觉代码是一个很集中的方向。
有人让它搭3D场景,有人做游戏,也有人把科学原理写成可以操作的网页。Arena 发布的首批体验视频介绍,列出的测试就包括三维场景、网页设计和交互式解释。
我们先来实测一道直观的题:用网页演示一枚火箭从海边发射,到一级助推器落回海上平台的全过程。
要求也很明确:画面要有三维体积和光照,点火时有尾焰与烟雾,升空后能级间分离,回收时展开支腿、反推减速。用户可以暂停、加速、拖动时间轴,也能切换镜头。
Qwen4-Max通过API返回了一个完整的HTML文件,生成约用时7分11秒。蓝调的天空、海面的反光、发射塔和回收平台都被搭了出来。点火时镜头靠近发射台,升空后转为跟随,到了回收段,再把视线拉回海上平台。
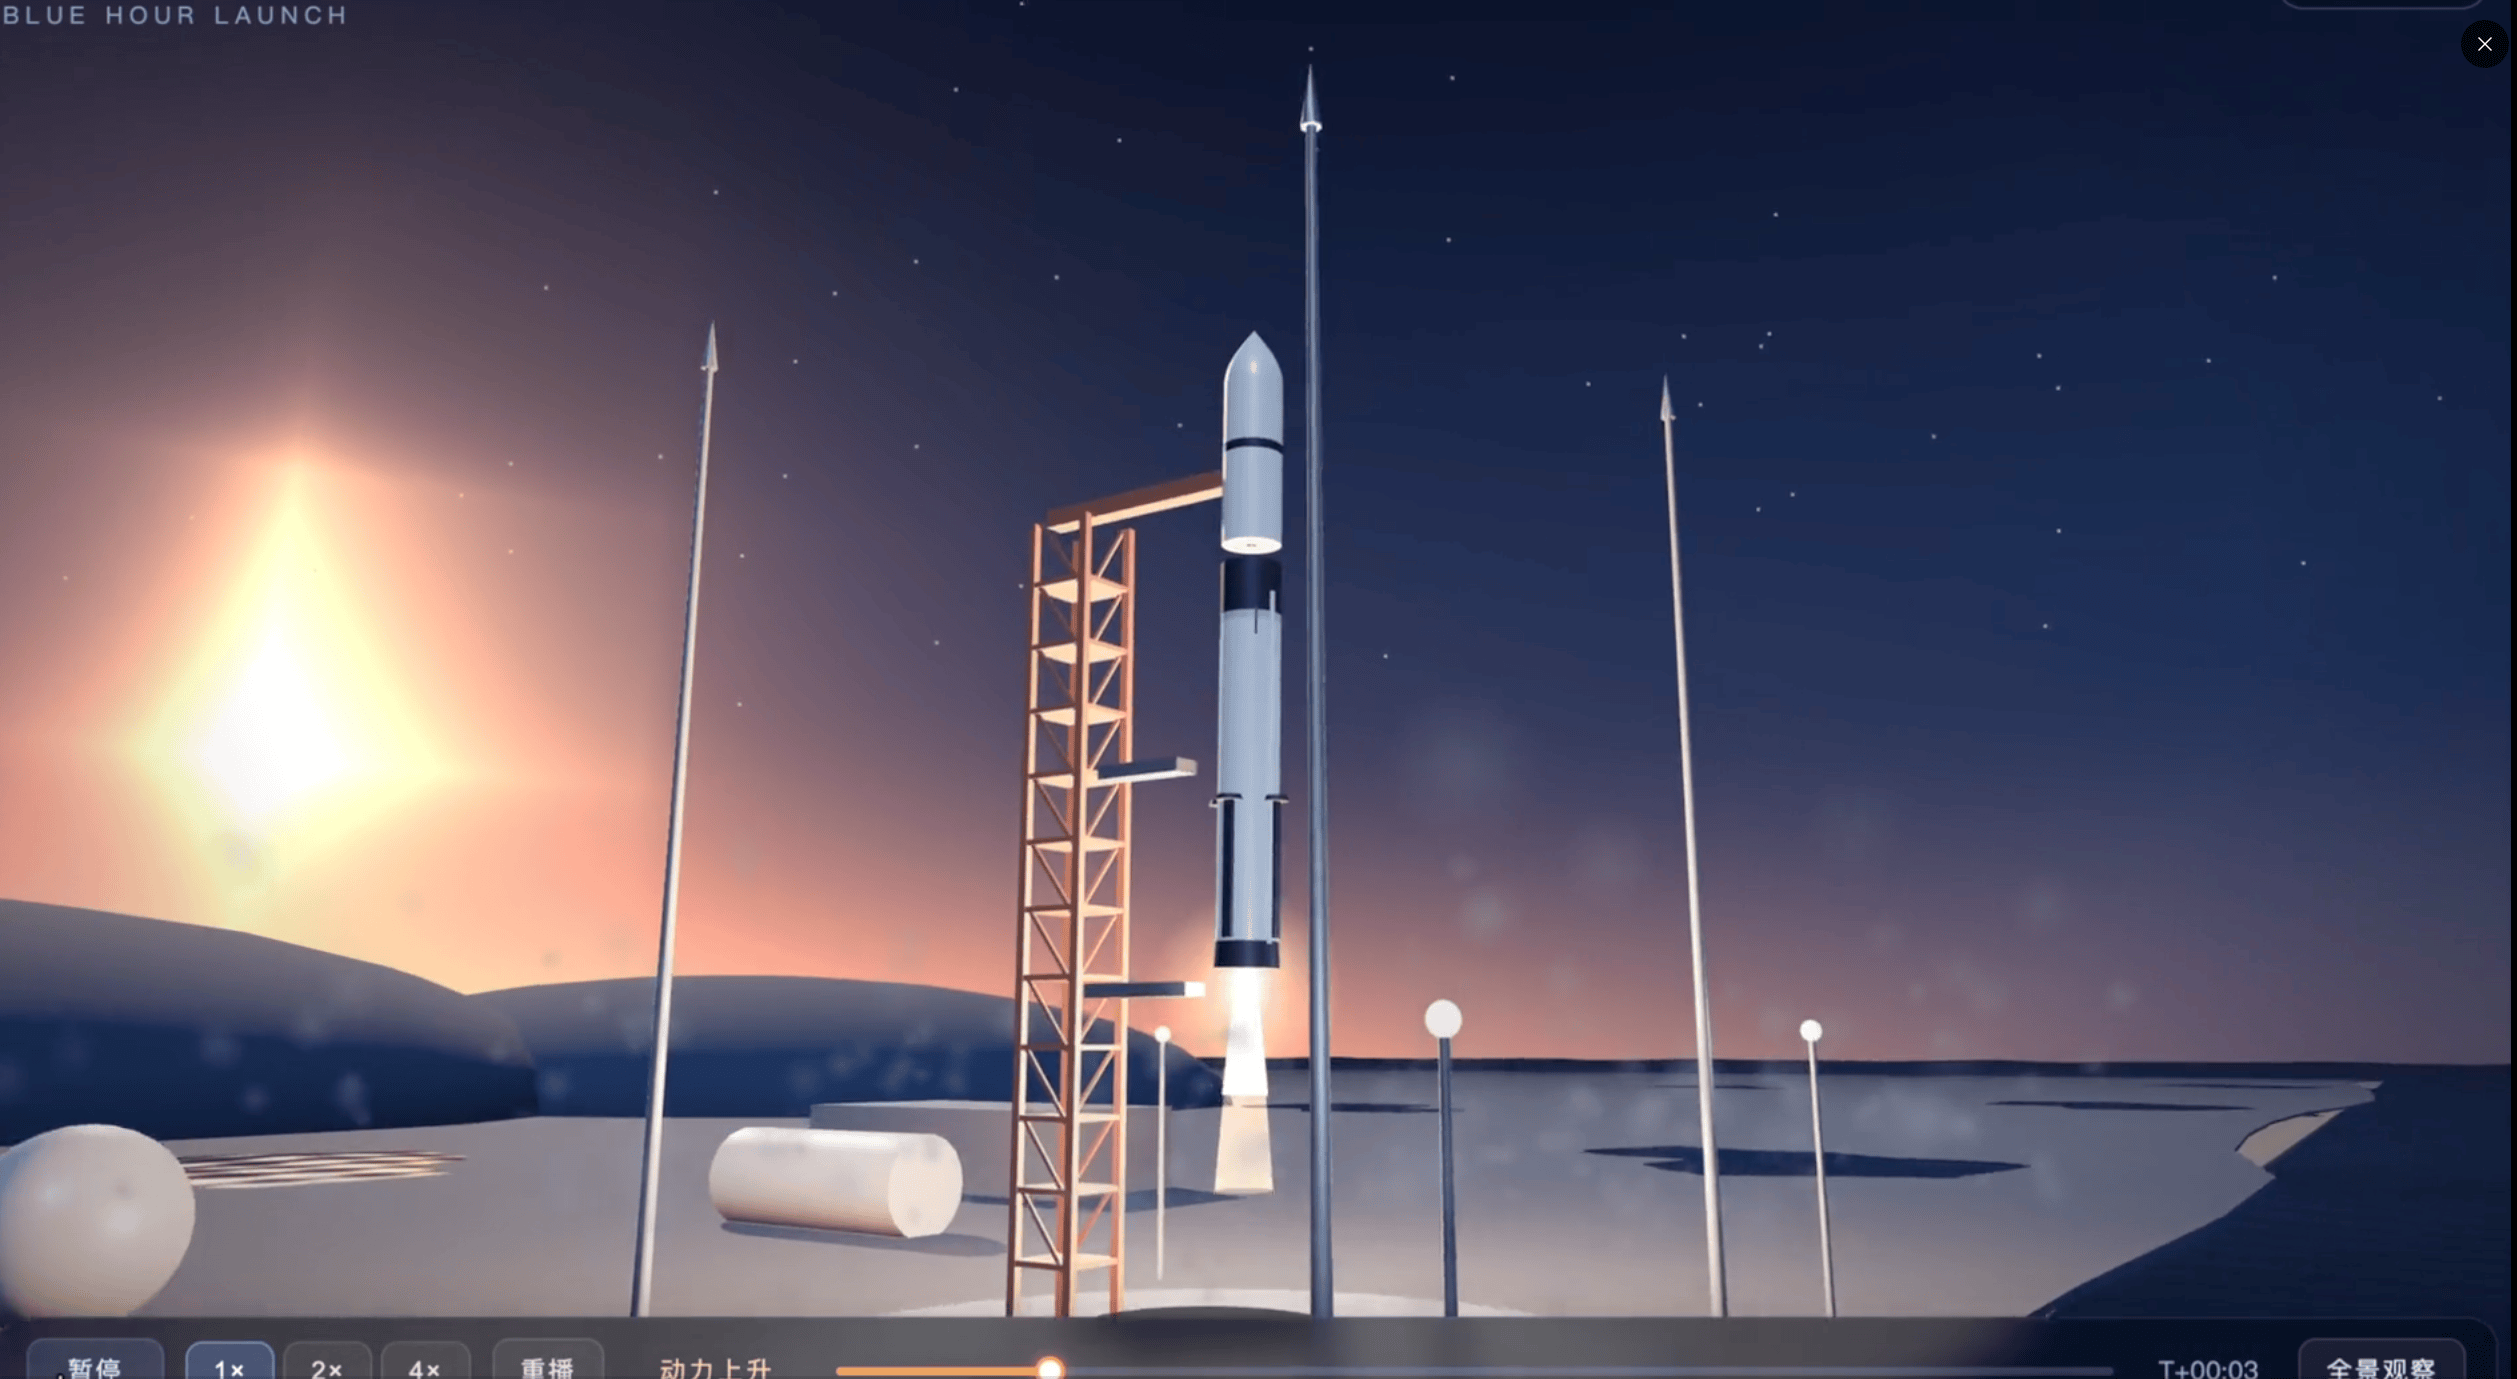
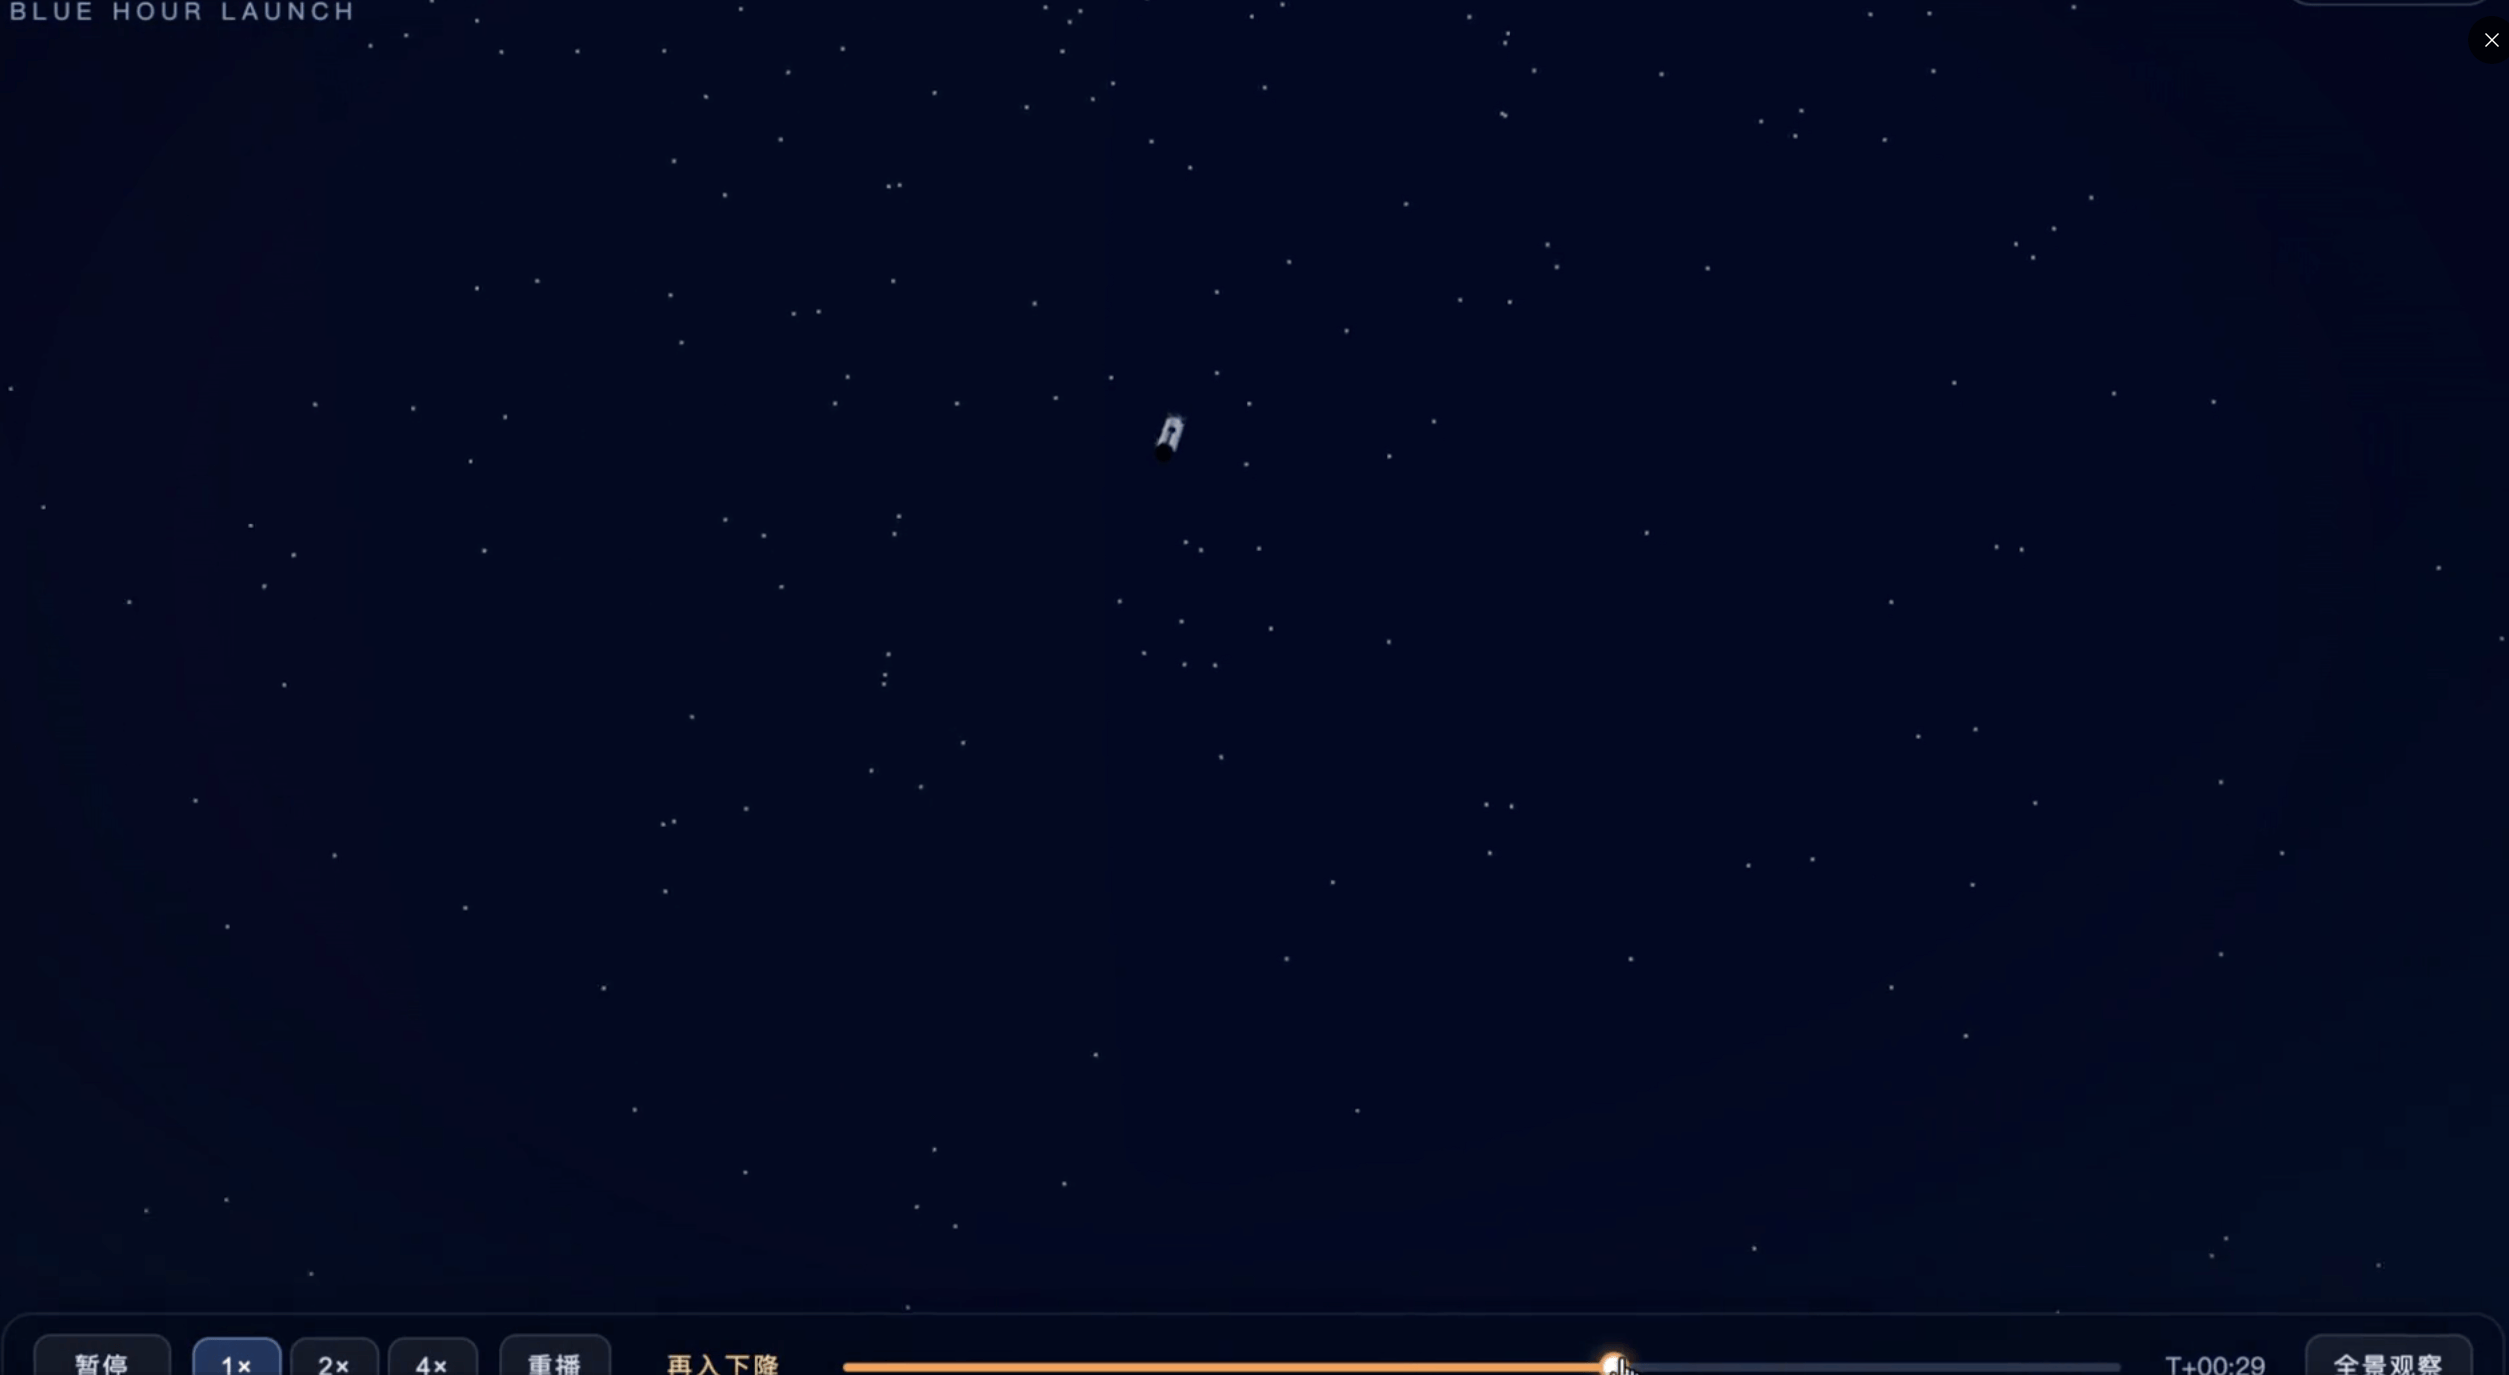
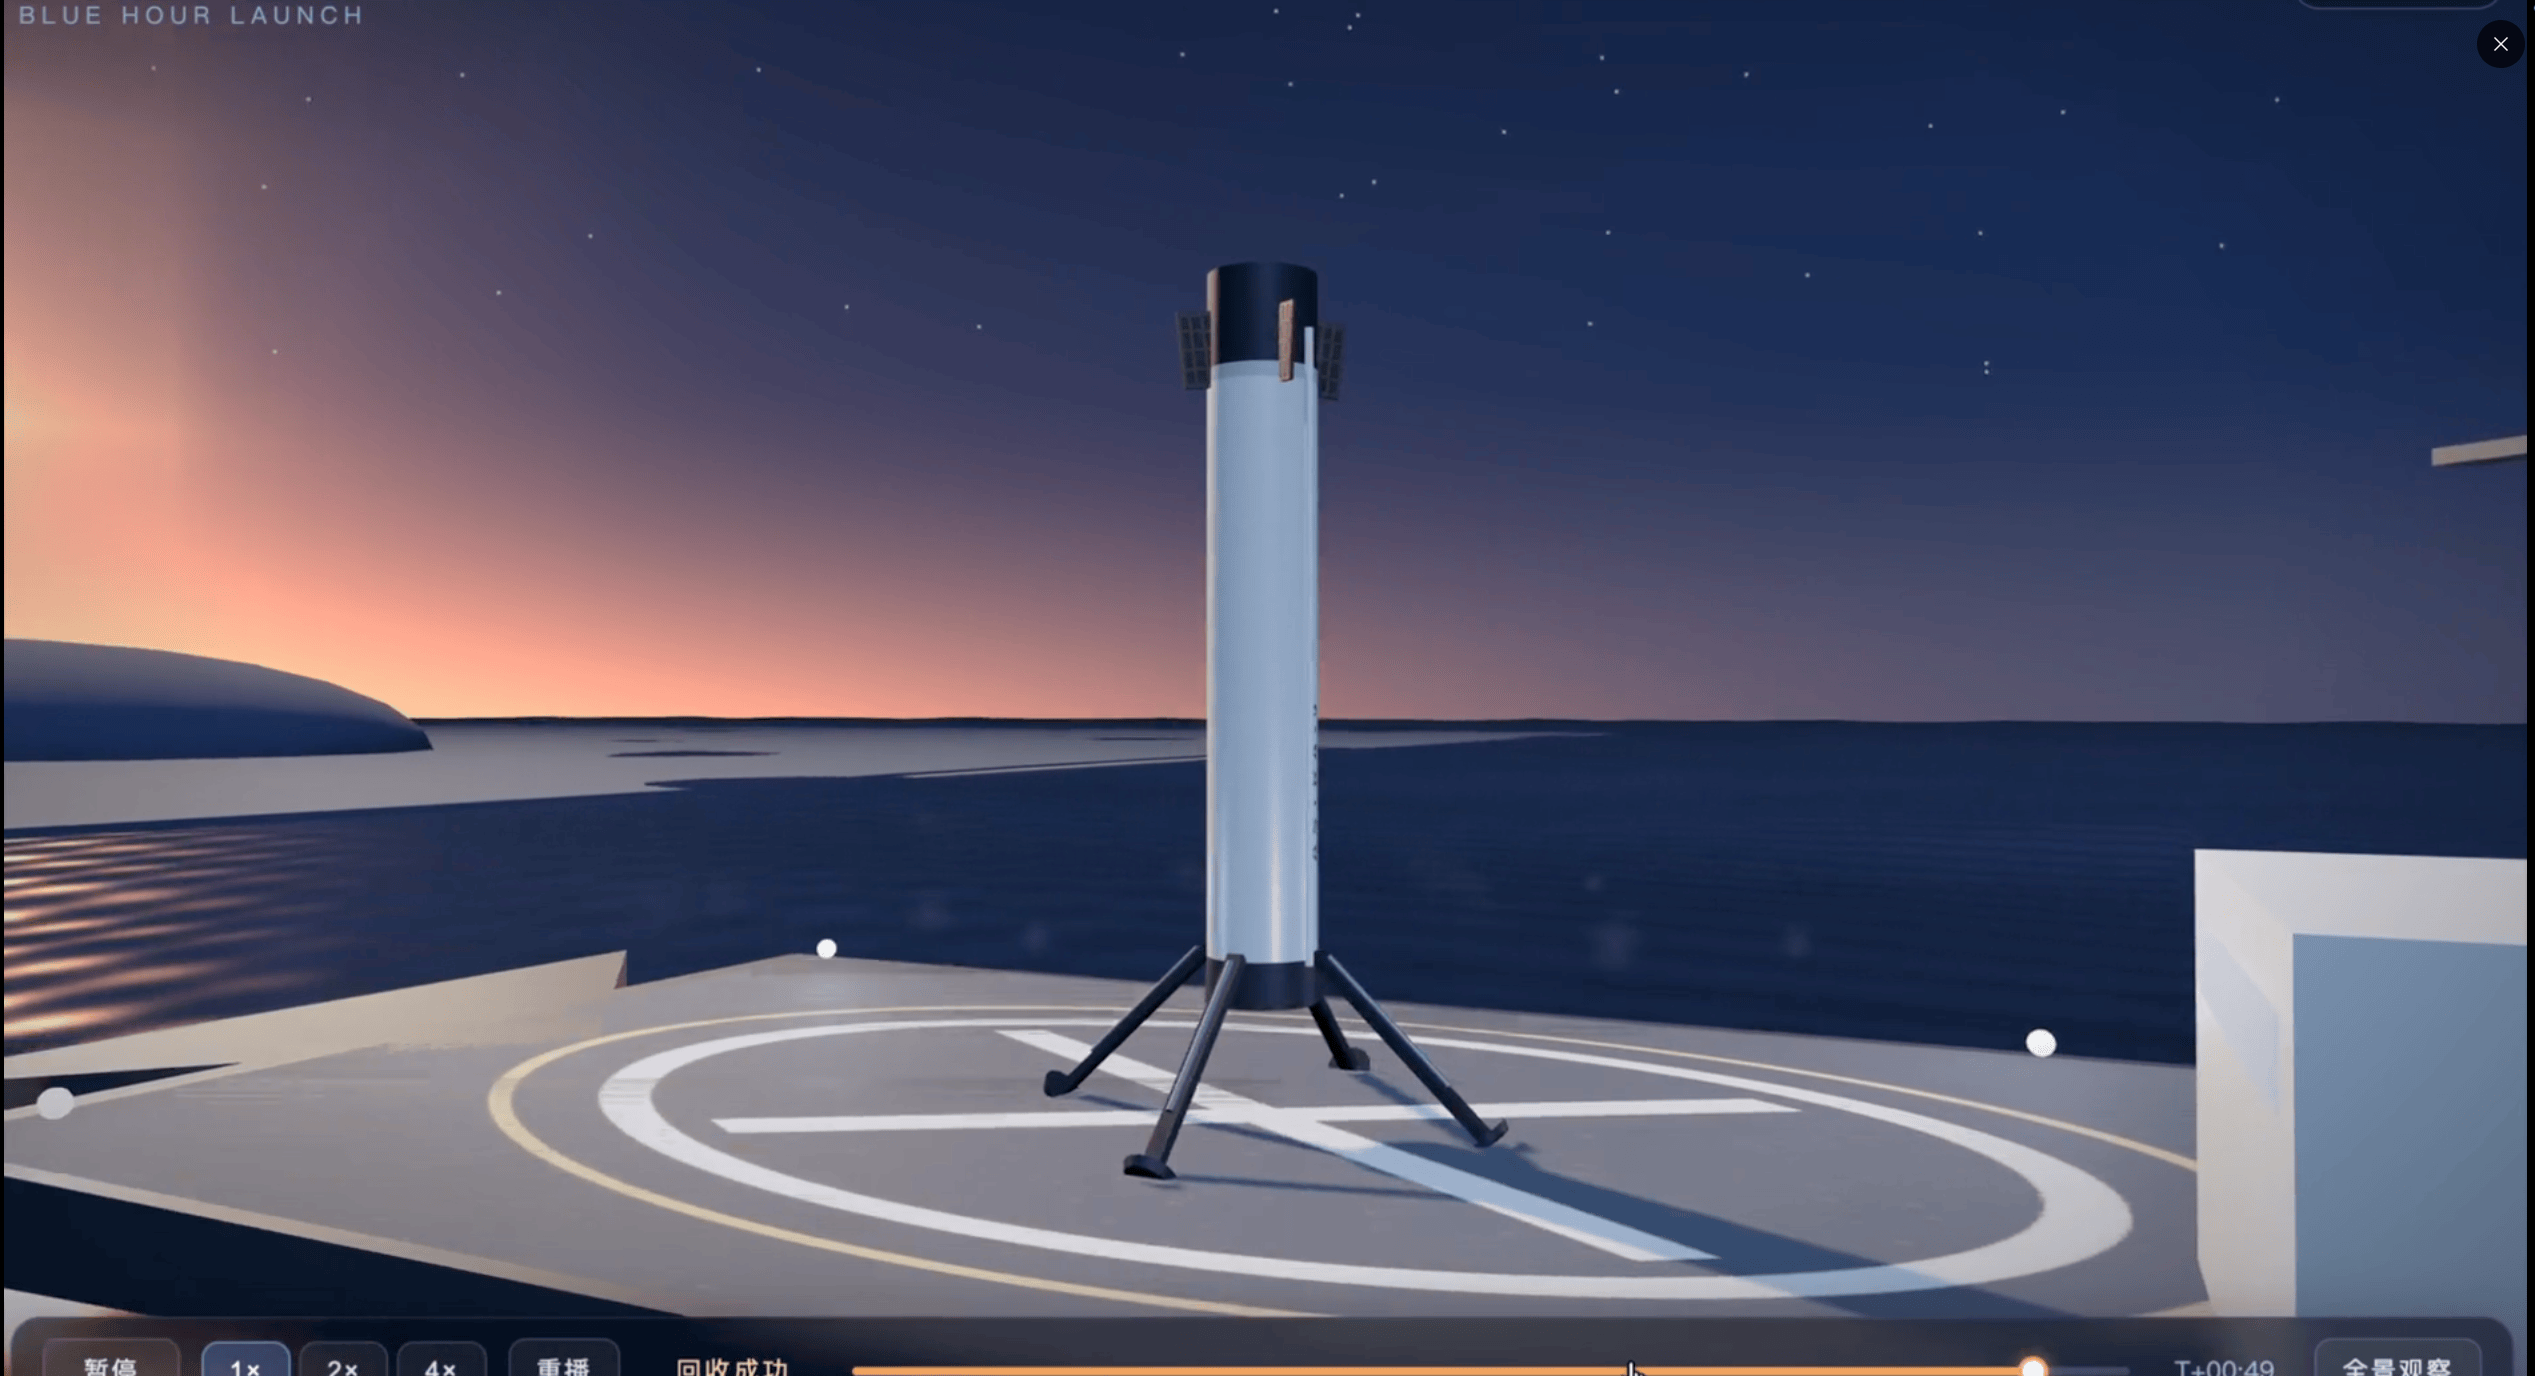
这段演示有完整的起承转合。尤其是着陆前,助推器展开支腿、尾焰朝下,最后停在平台上,比单纯画一个火箭向上飞,要多处理好几层状态关系。
虽然仍有可以打磨的地方,但它已经能把场景、动画和交互组织成一个还不错的效果演示。
第二道题,这次我们给Qwen4-Max一张AI开发者活动报名页的参考图,让它写出对应的网页。标题、日期和票价要准确,布局、配色和信息层级也要尽量还原。
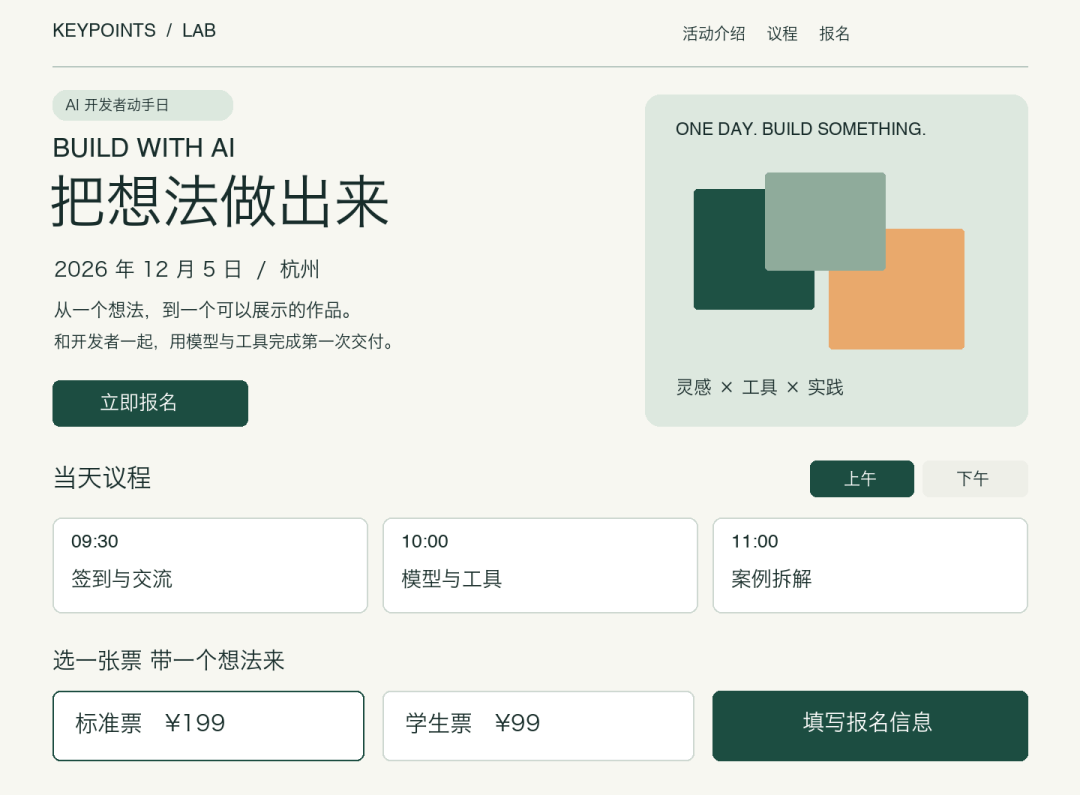
这一次大约只用时1分多钟。浅色背景、深绿色按钮、左文右图的结构,以及右侧叠放的几何色块,都保留了下来。它严格遵循指令,没有另起一套通用网站模板,活动信息也能对应上参考图。
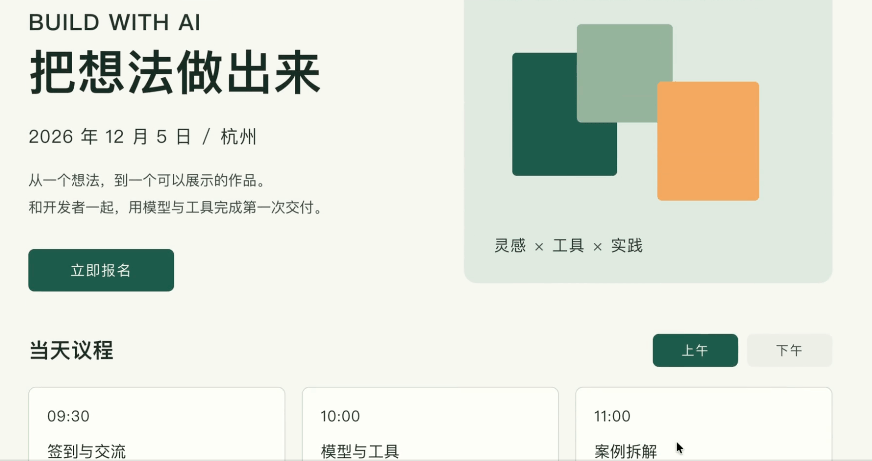
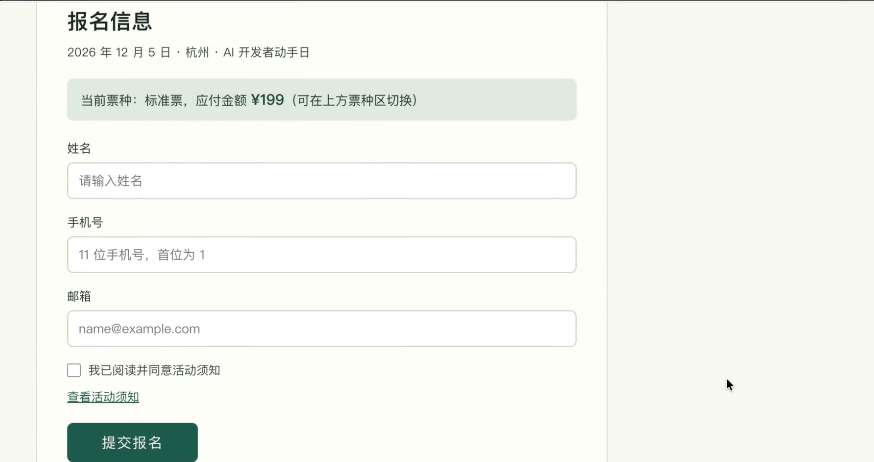
第一版完成后,我们再追加一个变化:活动延期一周,从12月5日改到12月12日,其他内容不变。
更新后的页面里,首屏和报名区域的日期都换成了12月12日,原来的配色、票种和议程结构则保留下来,返回文件中的报名确认日期,也做了对应更新。
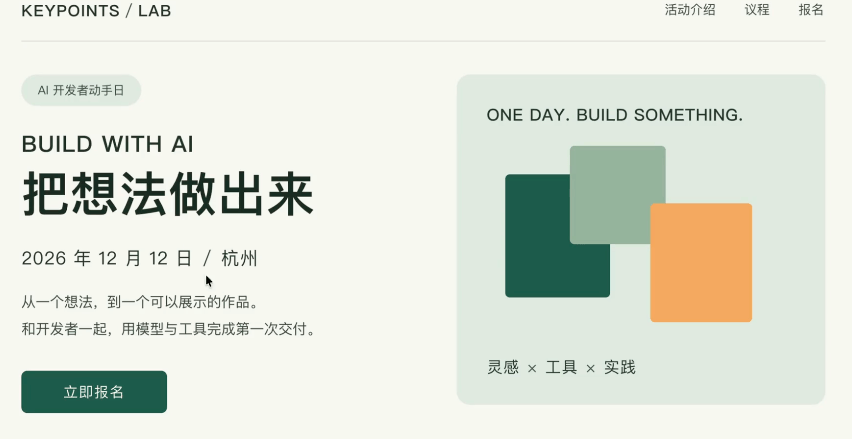
这个变动虽然不大,却接近真实工作里的修改:用户补充一条要求,模型需要严格遵循指令找到受影响的位置,同时保住已经做对的部分。
网页之外 让它接一份真正要交的工作看完交互效果,下一步打开千问办公。
这也是Qwen4-Max此次发布值得关注的一点。官方将模型直接放进专业办公和长程任务的语境里;千问办公的模型菜单,也已经列出Qwen 4-Max,用户可以手动选择。
既然如此,我们就给它一份需要算账、核对、写结论,还要整理文件的工作。
材料为一组模拟门店数据:订单表、退款表、投放表,加一份业务口径说明。里面有重复订单、已取消订单,也有已经确认和仍待处理的退款。
任务是做一份三家门店的经营复盘,交付Excel底稿和六页PPT。
从返回的交付说明看,Excel包含九张工作表,覆盖原始数据、清洗说明、订单明细及汇总;PPT则把内容分成经营总览、门店对比、渠道对比、退款与数据问题、投放讨论和结论六页。
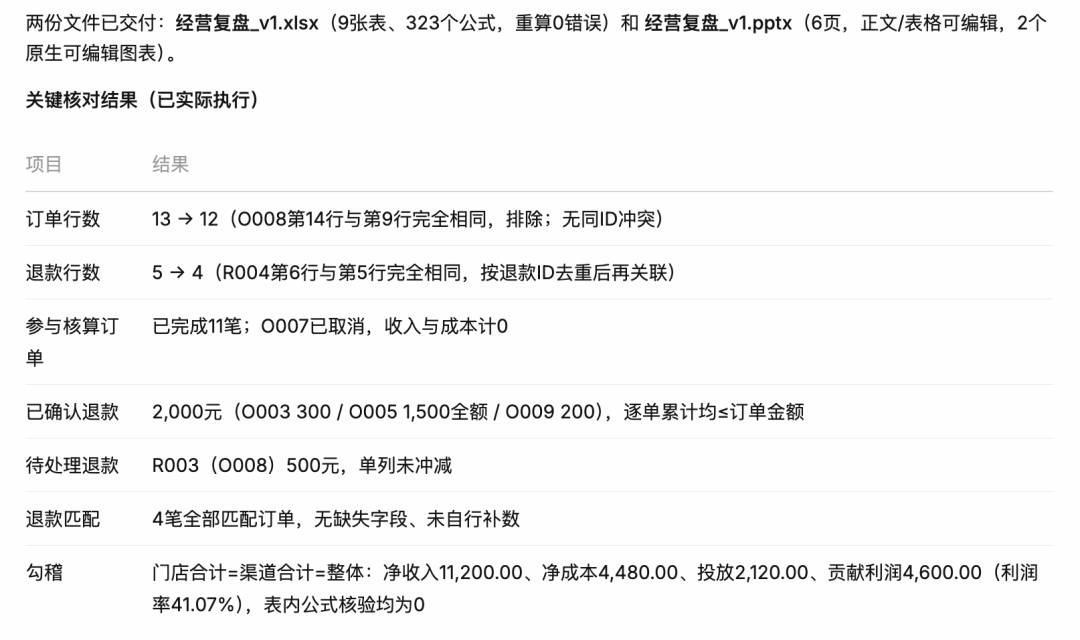
先看最关键的结果。订单按ID去重后剩12笔,排除一笔取消订单,11笔参与核算;已确认退款2000元,待处理的500元单列。最终净收入11200元,净商品成本4480元,投放费用2120元,贡献利润4600元,贡献利润率约41.07%。
再看PPT,它已经把数据整理成了直观的报告,结构清楚,已经具备拿到会上继续讨论的水平。
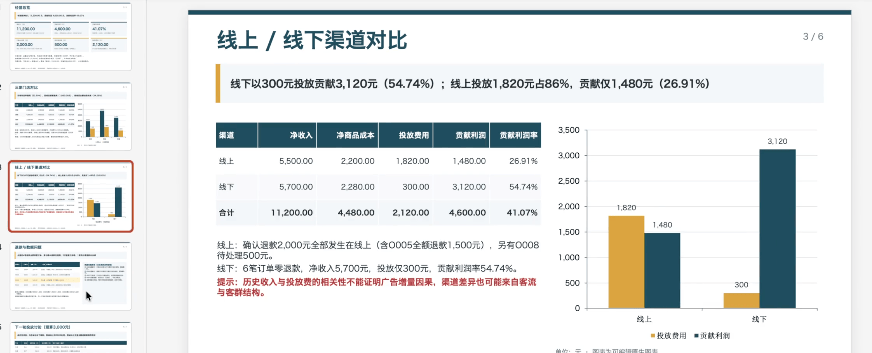
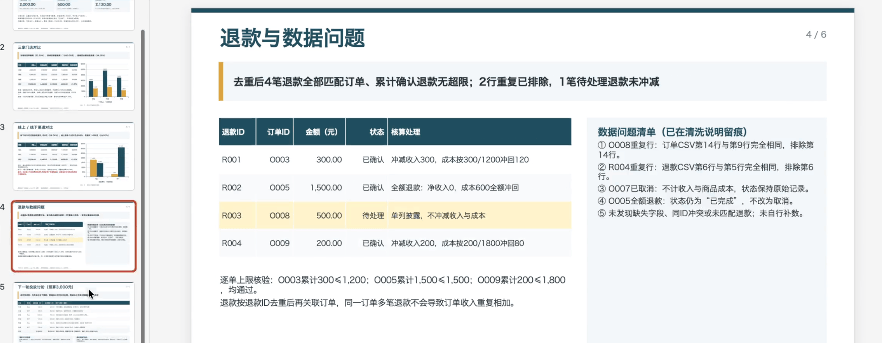
在3000元的投放讨论里,材料也保留了条件:对尚待确认的退款继续跟踪,对全额退款先排查原因,再讨论放量。它还明确提示,历史收入与投放费用的相关性,不能直接当作广告带来的增量效果。
这里的边界处理值得肯定。数据没有给出的答案,模型没有必要替用户下定论。把已经能算清的部分算清,把下一步需要补的数据列出来,不失为一个靠谱的办公助理。
把旗舰模型的账重新算一遍回到发布信息,Qwen4-Max给出的一个重要信号,是能力和任务消耗被放在一起讲。
官方在自建的Work360评测中报告,相比Qwen3.8-Max,新模型在High思考档位下减少约35%的token消耗;该评测的单任务平均费用从26.58元降至 11.16元,降低了58%。
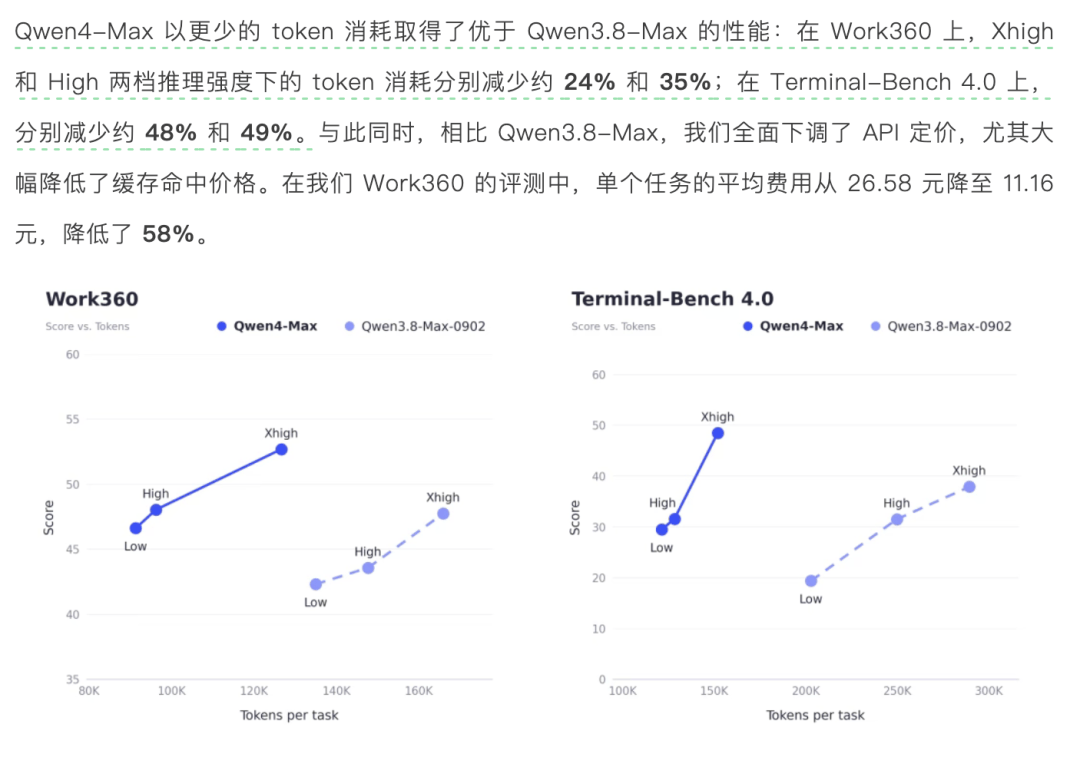
这件事对Agent尤其重要。一个任务会读多少轮文件、调用几次工具、报错以后重跑多久,都会进入最后的账单。模型如果能少走几步弯路,用户得到的就是更低的总花费。
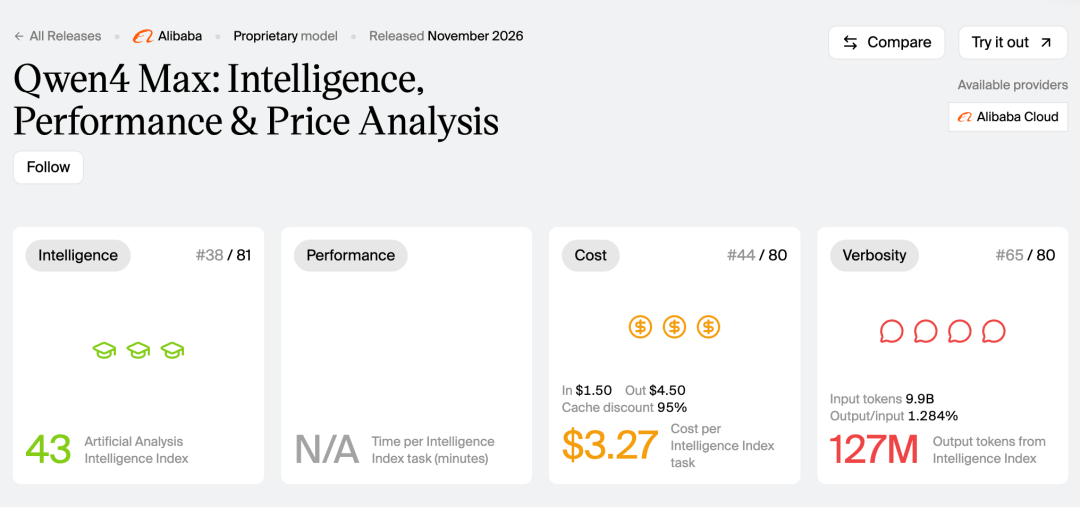
第三方评测也给出了一个参考。Artificial Analysis报告,Qwen4-Max的 Intelligence Index得分为43,比Qwen3.8-Max高9分,单次指数评测任务平均费用则从10.02美元降至3.27美元。
那么,放到一道具体任务里表现如何?我们也通过千问AI平台测试比较了一下。沿用前面的订单、退款、投放数据和业务口径,给Qwen4-Max和Kimi K3.1 Pro出了同一道核算题。这一轮只要求返回结构化结果,单独比较模型计算与更新的消耗,不生成Excel和PPT。
两款模型均开启思考,使用各自的High档位。整套流程独立跑了三轮,共 12次调用,每轮都包含首次核算和追加修改两个阶段。
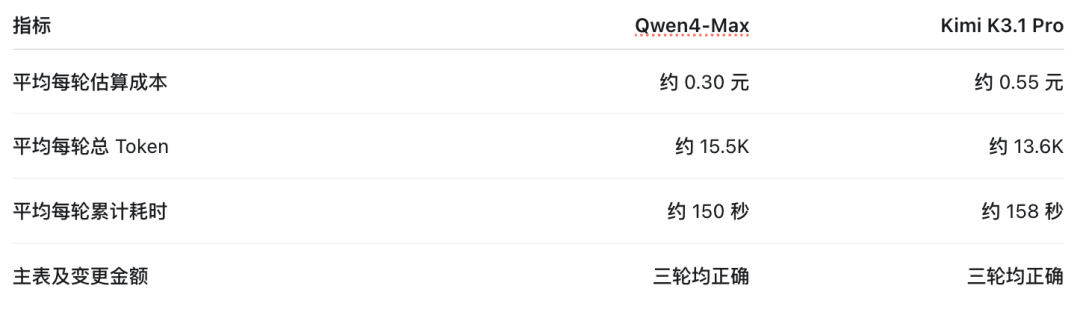
虽然Qwen4-Max这次并没有用更少的Token,但较低的单位价格抵消了这部分消耗,平均成本约低46%。
Qwen4-Max已经体现出具体的成本优势。对于准备把模型接进日常流程的用户,这是一项实际的吸引力:当调用从偶尔试用变成每天发生,完成一件事要花多少钱,就会成为选择模型的重要依据。
几项任务体验下来,Qwen4-Max最值得肯定的是能力提升、任务成本下降与更易上手的产品:它能以比较低的花费把复杂的视觉想法写成可运行的交互,也能在业务材料里对齐口径,再借助办公产品组织出汇报成果。
One more thingQwen4-Max发布之后,开源社区最关心的问题是:小尺寸模型什么时候来?
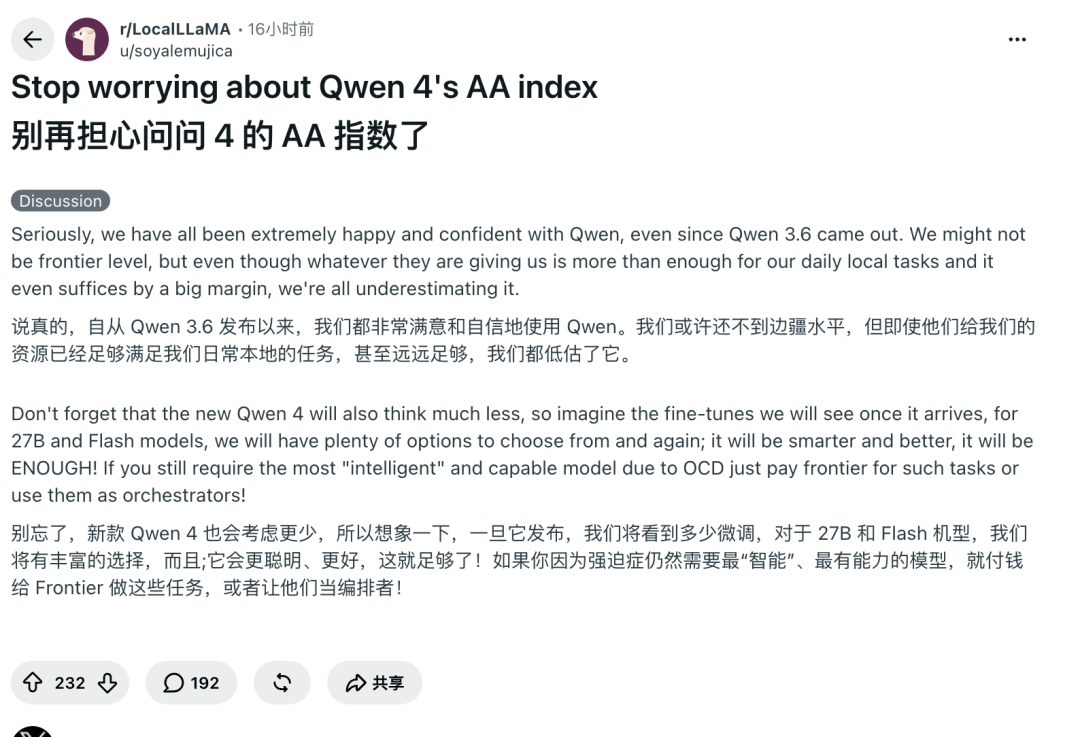
在LocalLLaMA的讨论里,有用户认为现有Qwen已足以承担自己的日常任务,对下一代更期待的是减少推理消耗,并继续适配自己的设备和流程。这些声音不能代表整个社区,却也体现出:千问积累的用户,并不都在等待一个榜单冠军。
开发者追求的是本地部署的掌控感,普通用户看重的是开箱即用的生产力。开源生态为千问攒下了信任,而千问办公这类工具产品,则在把信任交付到更多人手里。