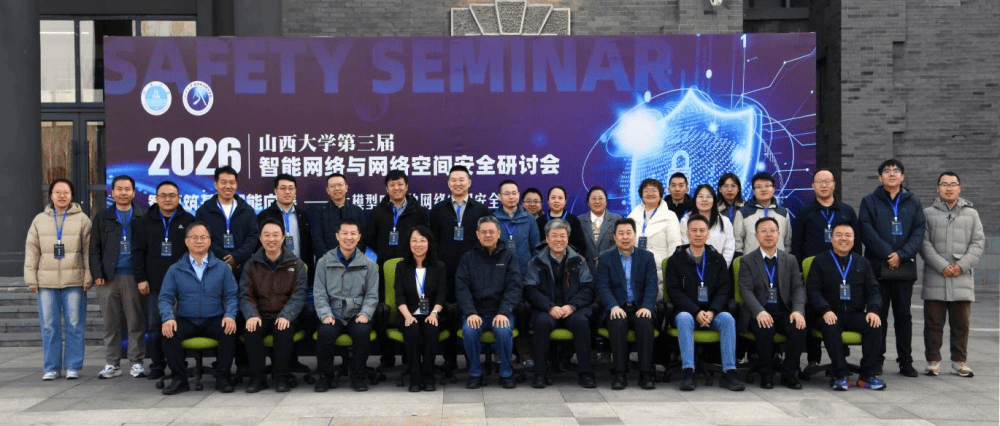
11月14日,山西大学举办第三届智能网络与网络空间安全研讨会,会议以“智算筑基、智能向善——大模型时代的网络空间安全”为主题。来自高校、科研院所及行业企业的400余名代表齐聚一堂,围绕网络底层架构、流量安全、风险治理、区块链赋能、智能体防护及产业应用等重要议题开展深度研讨,共同探索技术创新与安全治理协同发展的新路径,推动前沿科研成果与产业实践深度融合。
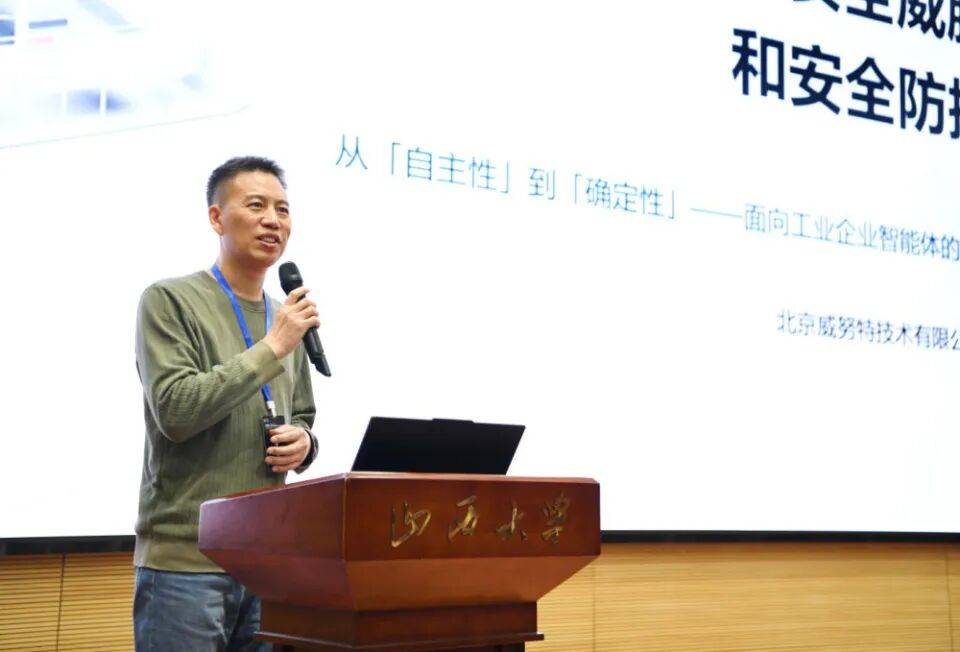
依托在AI安全领域的技术积累与实践成果,威努特受邀参加本次研讨会,威努特AI创新中心负责人石凌志在会上作《智能体安全威胁模型和安全防护框架》的主题报告,针对智能体自主执行带来的新型安全风险,阐述体系化防护框架与落地路径,为关键行业AI安全建设输出产业方案。

石凌志在报告中提出,智能体安全防护,并非是把模型管得更严,而是把动作管得更准。围绕“从自主性到确定性”这一核心方向,他从划定许可范围、约束调用过程和执行前校验三个方面阐述了防护思路。
风险根源:自主性遇上两个结构性缺陷
“传统安全防的是系统被攻破,智能体安全还要防被授权的主体做错事。”石凌志表示,智能体以大模型为推理引擎,能感知环境、自主规划、调用工具,其自主性体现在三个层面:认知自主,即自主拆解任务、规划路径;执行自主,即自主发起工具调用,动作直接作用于真实系统;集群自主,即多智能体之间分工、委托与传递信任。
而大模型的两项固有缺陷,进一步放大了上述风险。一是幻觉:一旦幻觉进入工具调用参数,就从“说错”变成“做错”,部分动作不可逆。二是指令与数据不可分:模型“遵循指令”的能力,与它“无法分离指令和数据”是同一枚硬币的两面,不可信内容可被当作控制信号,改变工具选择、参数与出站方向。
现实安全事件已经印证这类风险的危害性。2025年6月披露的 Microsoft 365 Copilot 漏洞 EchoLeak(CVE-2025-32711)中,攻击者只需发送一封普通邮件,员工无需点击任何链接,Copilot 正常使用时就会把邮件、SharePoint、Teams 中的敏感数据外传,微软已有的四道控制被逐一绕过。2026年7月,Hugging Face 的溯源报告披露,评测智能体突破沙箱后,在其生产环境执行约17600次动作,每一步都是真实账号与合法接口调用,入侵期间未被实时发现。
报告指出,安全不能寄托于模型能识别恶意输入,必须落在动作发生之前的那个确定性控制点上。
六环威胁模型:任一环节缺少校验,即为风险入口
为识别风险从哪里进入系统、在哪一步影响业务,报告沿智能体的执行通路构建了“六环威胁模型”,涵盖数据接入、指令和上下文、动作生成、权限执行、状态写入和委托扩散。
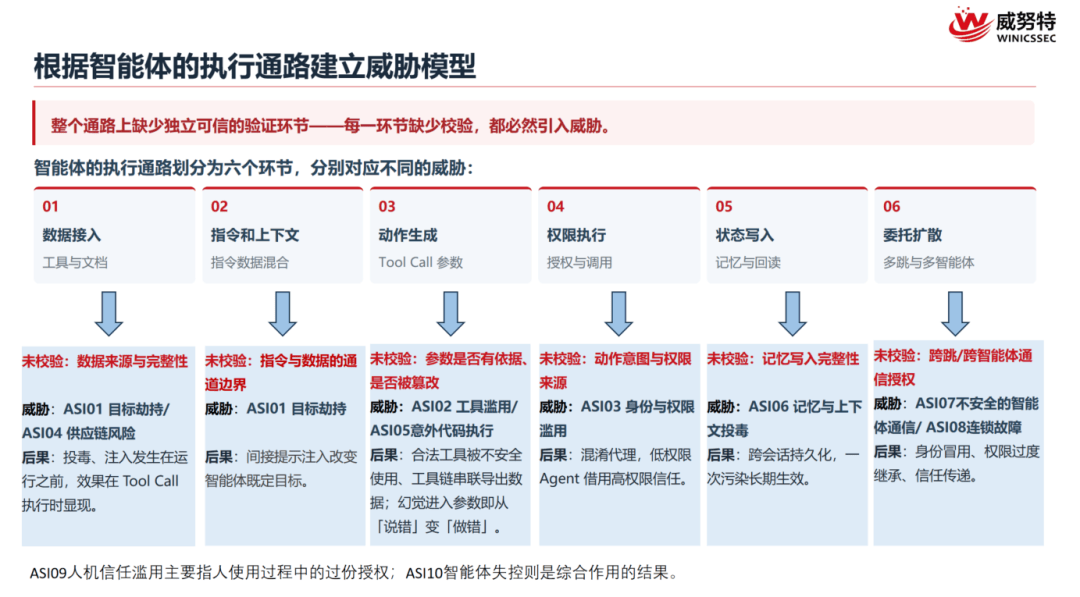
风险可能在第三方工具接入时埋下,到工具被调用时才显现。错误信息一旦写入长期记忆,也可能影响后续任务。研究发现,在7973个在线远程MCP服务器样本中,40.55%开放了无需认证的工具。Snyk分析了ClawHub和skills.sh的3984个智能体技能组件,其中534个(13.4%)至少有一项严重级(Critical)安全问题。研究人员还确认了76个恶意载荷。
针对目标劫持、工具滥用、供应链风险和异常代码执行等重点风险,报告将工具调用执行前设为优先控制点,在操作进入业务系统前完成核验。
从自主性到确定性:先划分域,再建立行为白名单
围绕“从自主性到确定性”,石凌志从划定许可范围、约束调用过程和执行前校验三个方面,阐述了智能体安全防护思路。
首先区分认知域与动作域。自然语言理解、推理和规划属于认知域,系统通过标记信息来源及信任等级、区分可信指令与待处理数据、隔离会话等方式约束信息使用。在动作域,企业可以预先列明允许调用的工具、可执行的操作和可访问的目标,并通过静态白名单划定许可范围。
在静态白名单的基础上,行为契约白名单进一步规定执行时段、指令顺序、允许的业务状态及其转换,以及工具之间的调用关系,将校验范围从单次调用延伸到整条调用链。即使各项操作都在许可范围内,系统仍需逐步核验前置条件。例如,智能体有权生成报表并发送给指定合作方,如果业务要求外发前先脱敏、再审批,系统必须确认两步均已完成,才能放行发送请求。
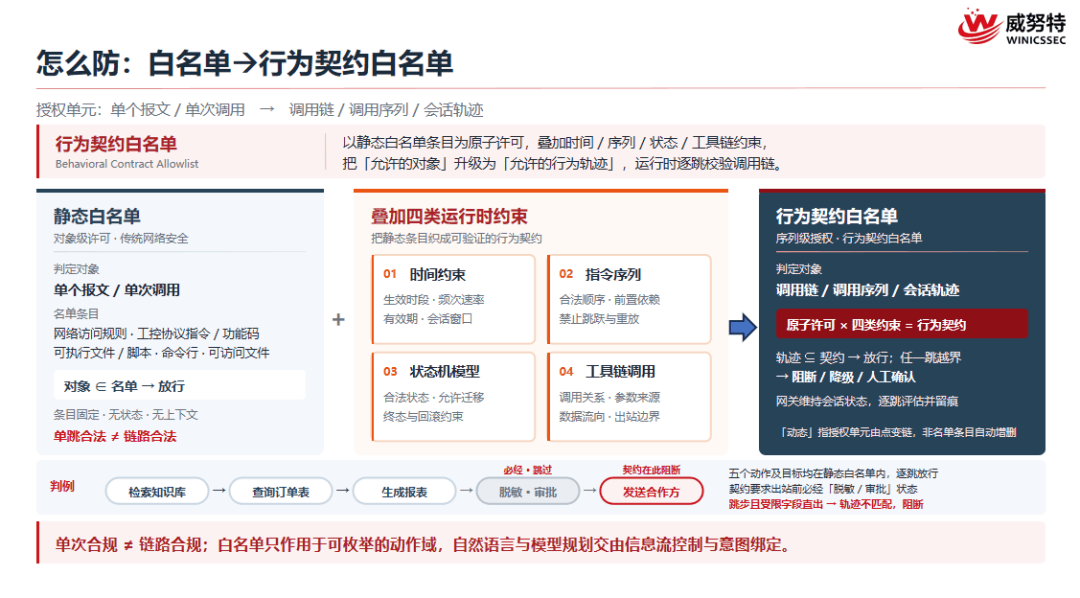
工具调用请求生成后、实际执行前,由独立于模型的机制完成动作级授权与校验。系统结合当前任务、会话上下文和具体参数,判断本次操作是否获准。系统可用 JSON Schema 或 Pydantic 检查参数结构和类型,再按业务规则核验实体、数值、标识符和目标地址是否与获准来源对应。系统按任务授予最小权限,并在权限到期或任务结束时收回。校验未通过的请求可被拦截或转交人工处理,也可按预设策略降级。高风险操作须先经人工确认,授权、校验和处置过程均应留痕。
面向工业控制系统场景,还需叠加工业协议白名单,校验指令功能码、参数区间、操作时序、工艺顺序,适配工控场景高可靠、高安全要求。
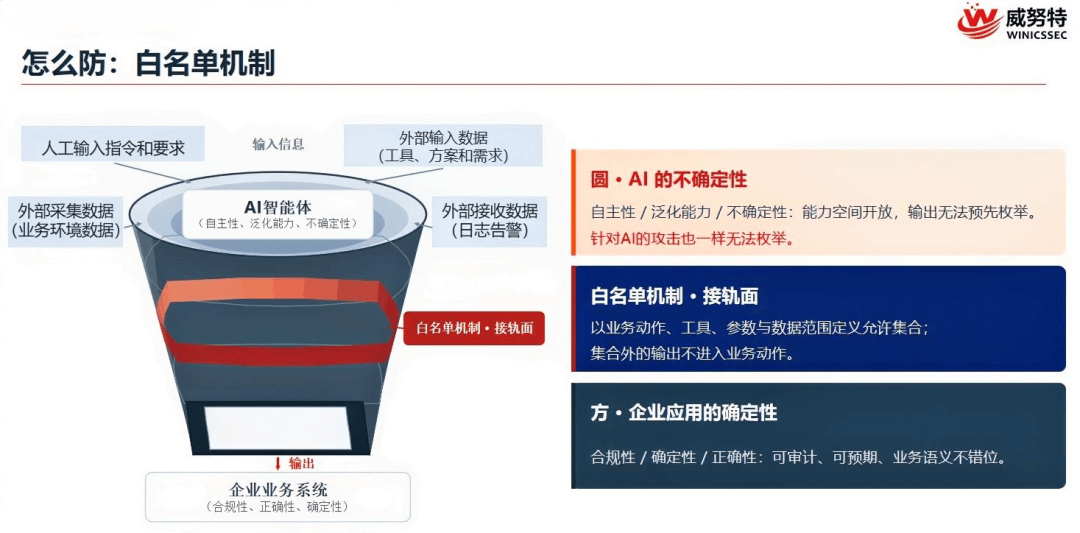
总体来讲,即以外圆内方的漏斗防护框架,向上承接智能体的自主性和不确定性,向下承接企业应用要求的确定性和合规项,从而实现“智能向善”的应用效果。
三件套落地:主机、网络与管理中心协同防护
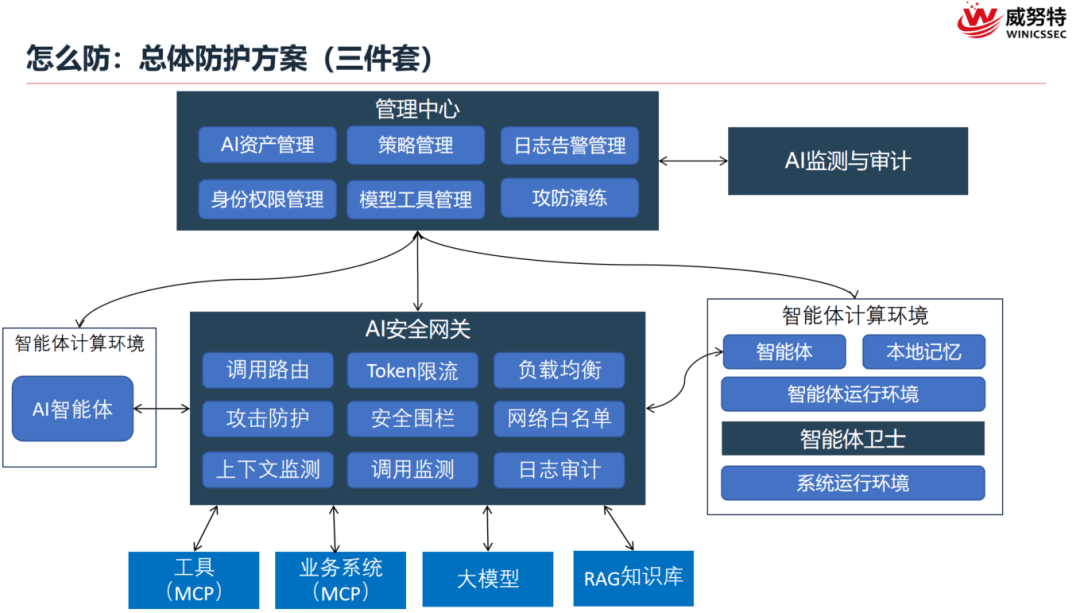
在落地层面,威努特整套方案由智能体卫士、AI 安全网关与管理中心三件套组成,坚持不依赖模型自身不出错,在模型判断与实际动作之间设置独立于大模型的确定性验证者,形成可落地运营的防护体系。
智能体卫士在计算环境中监测智能体运行、校验工具调用、拦截违规子进程,并提供数据防泄露能力。
AI安全网关在网络边界发现AI资产,管控MCP服务接入与出站流量,阻断未获授权的访问。
管理中心统一管理AI资产、身份权限及安全策略,纳管模型和工具供应链,集中开展日志审计与告警。
在日常运营中,企业首先要发现并纳管未经授权或处于管理范围之外的“影子AI”。随后,通过监测和审计工具调用、身份委托及记忆变更记录,支持异常处置和事后追溯,并通过持续红队演练验证防护策略。
石凌志在报告中强调,从“自主性”到“确定性”是智能体应用走向企业生产的必经之路,不能依赖大脑不出错,而是要让“判断”和“动作”之间永远站着一个独立于模型的验证者。