对残缺数据表来说,高效处理的第一步就是彻底清洗:
当你拿到的数据集里,年龄、成绩、邮箱这些关键信息总有空白时,直接拿来分析很容易得出误导性结论 —— 而系统化的数据清洗,正是数据工作里最基础、也最能体现专业性的环节。
不管是写课程报告、毕业论文,还是做业务报表,只有把数据洗干净,得出的结论才靠谱。
本文会用 Python 的 Pandas 库,手把手带你完成缺失值的检测与清理操作,帮你彻底摆脱空白单元格的困扰。
缺失值清理实战
01
查看原始数据
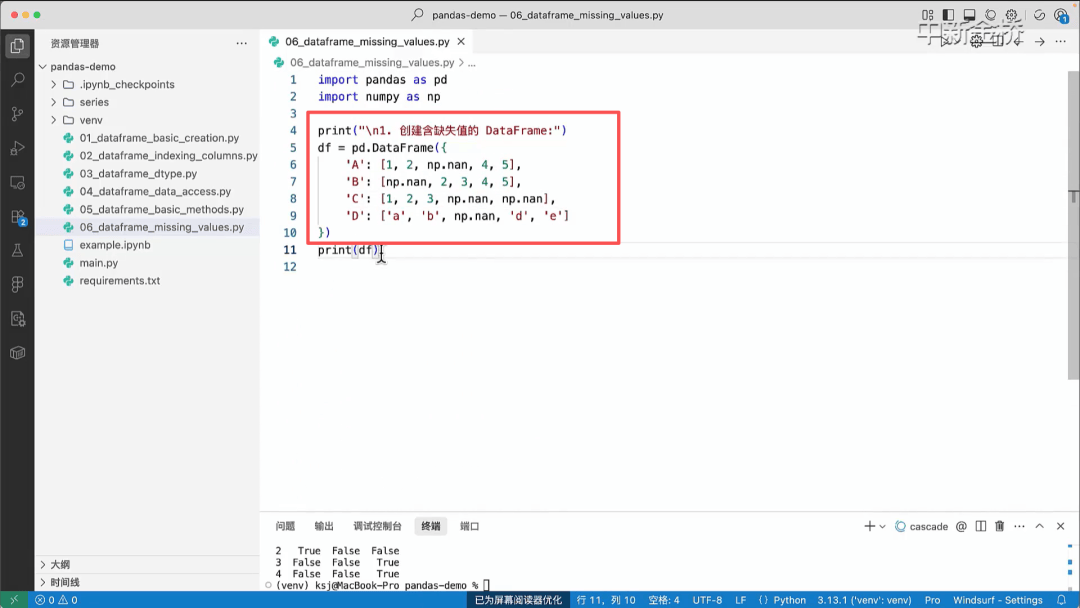
在开始清洗前,我们首先导入一份示例数据表。可以清晰看到缺失数据的地方。
02
定位缺失值
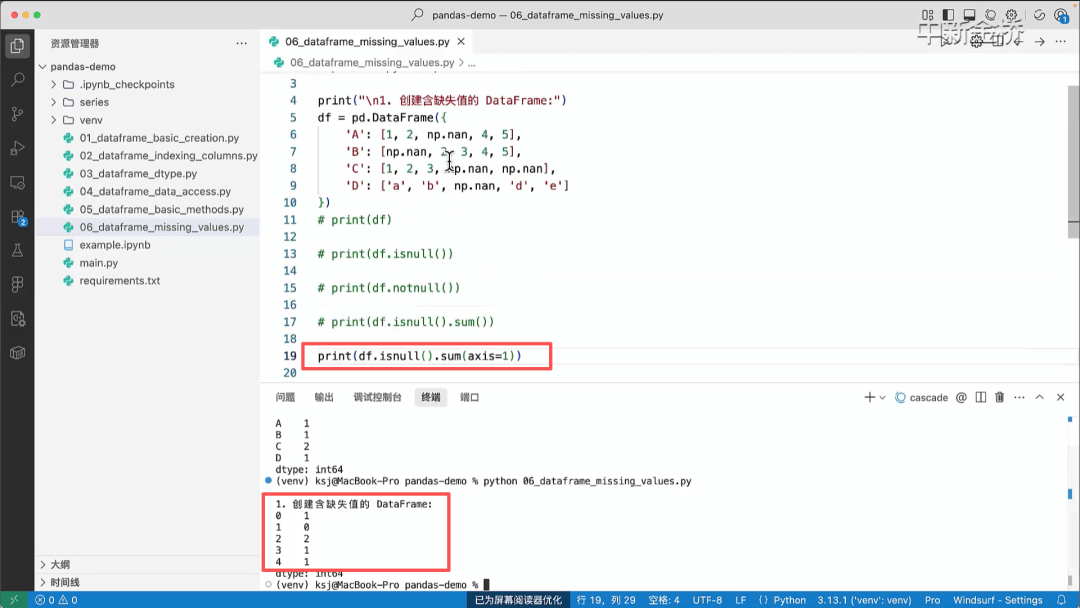
使用 df.isnull.sum 可快速统计各列的缺失值数量。

03
查看含缺失值的行
仅知道缺失数量还不够,我们通常需要精确定位到具体哪些行的数据不完整。可以使用以下代码,将所有包含缺失值的行筛选出来。
04
删除缺失值
确定要删除缺失值后,使用 dropna 方法可以一键删除所有包含缺失值的行。

05
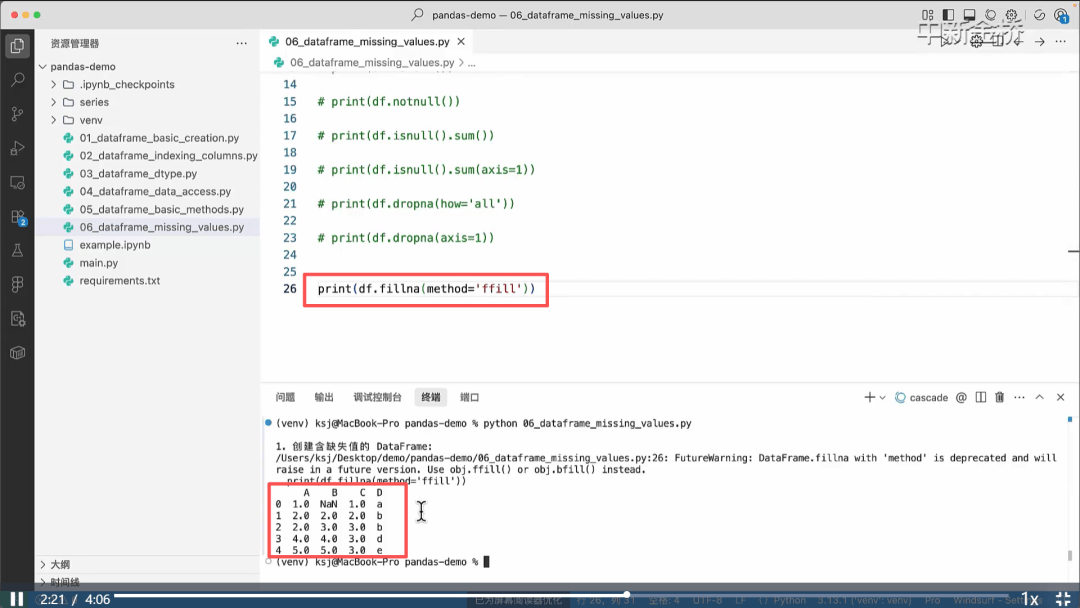
缺失值填充
除删除外,也可使用均值、中位数、前后值等进行填充。
理论看完,动手才算开始。
打开编辑器,用你的数据试一遍上述操作——从解决第一个缺失值起,建立可靠的分析工作流。
本节具体内容请查看下方二维码
本章全部课程请到“软件通”数据库中
查找—— Pandas 2.3.1 基础课程
软件通数据库使用指南